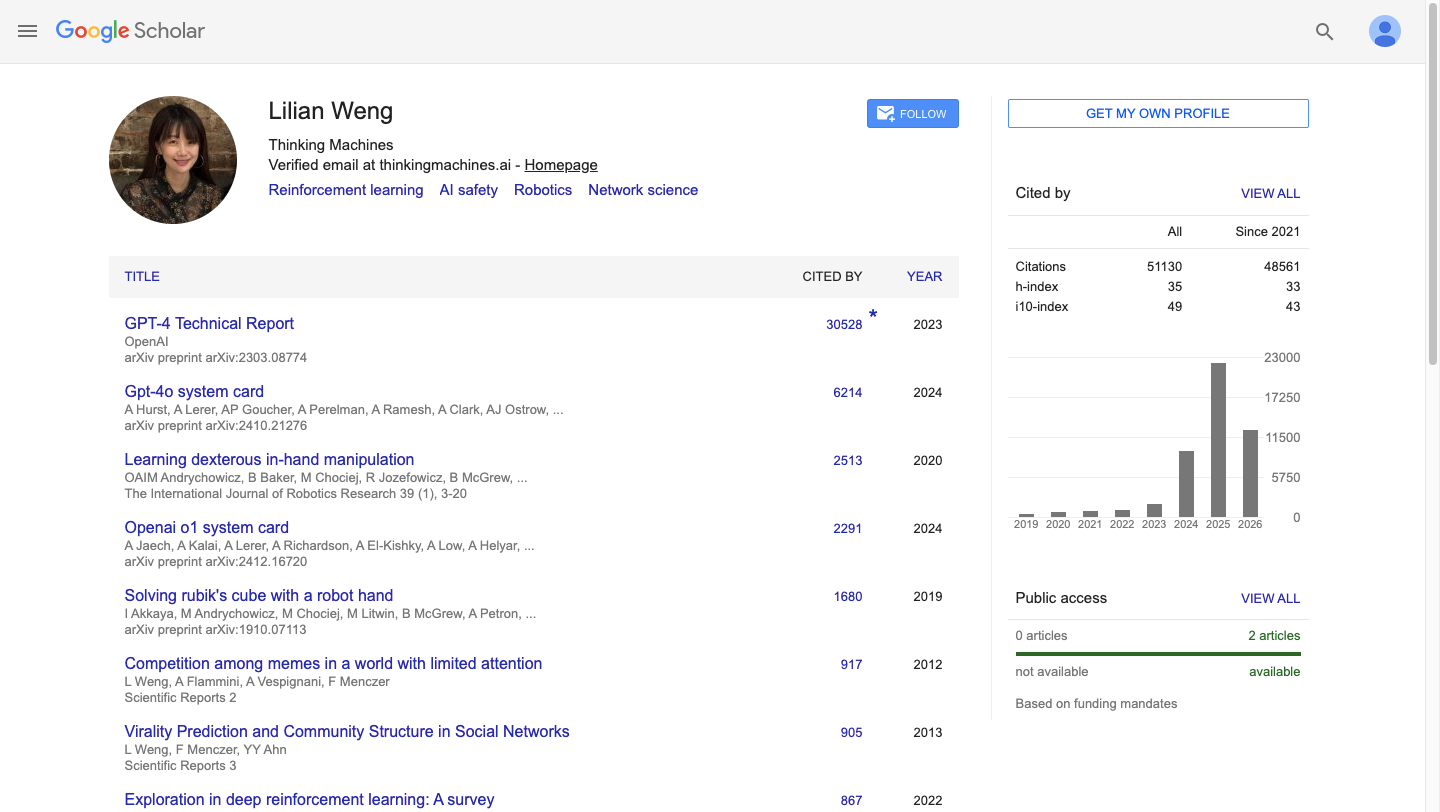
作者简介
Lilian Weng(翁荔),中国出生的 AI 研究员,本科毕业于北京航空航天大学计算机科学专业,后在美国卡内基梅隆大学获得计算机科学硕士和博士学位。早期曾在 Snapchat 担任研究科学家,2018 年左右加入 OpenAI,参与过机器人项目(如教机械手解魔方)、大语言模型研发以及 AI 安全/对齐研究,曾任 OpenAI 研究与安全副总裁(VP of Research and Safety)。她以撰写高质量技术博客(Lil'Log)闻名,主题涵盖强化学习、Agent 框架、提示工程、进化算法等,深受 AI 社区欢迎。2025 年,她与 Mira Murati、John Schulman 等前 OpenAI 同事共同创立新公司。
文章概述
本文围绕递归自我改进(Recursive Self-Improvement, RSI)展开,核心论点是:RSI 的近期实现路径不是让模型直接改写自身权重,而是通过改进模型周围的 Harness(约束/编排系统) 来实现。
Harness 指围绕基础模型的整个执行系统——包括工作流设计、工具调用、上下文管理、状态持久化、子代理调度、评估反馈等。文章将其类比为 AI 的"操作系统",系统梳理了 Harness 的设计模式、优化路径(从上下文工程到进化搜索再到联合权重优化),并讨论了未来挑战(弱评估器、多样性坍缩、奖励作弊、人类监督角色等)。
核心结论: 近中期 RSI 的实际进展将主要通过 Harness 工程实现;即使许多 Harness 改进最终被内化到模型权重中,指定目标、约束、上下文和评估的需求也不会消失。
正文翻译
递归自我改进(RSI)的概念可追溯到 I. J. Good(1965),他将"超级智能机器"定义为一个能在所有智力活动上超越人类、并设计更好机器来改进自身的系统。Yudkowsky(2008)将"递归自我改进"用于描述一个特定的反馈循环:一个 AI 利用其当前智能来改进产生该智能的认知机制。
这个反馈循环在现代 AI 中可以是模型直接改写自身权重,也可以更广义地指模型改进训练管线和部署系统,进而产生性能更强的后继模型。前沿实验室(Anthropic、OpenAI)的研究速度已被证明正在大幅加速。
我特别提到"部署系统",因为原始模型与真实世界上下文之间的这一层,似乎与模型的原始智能(即预训练后立即评测的能力)同等重要。Harness 是 AI 部署的关键组件,Claude Code 和 Codex 等成功的编码 Agent 产品已经证明了这一点。Harness 是围绕基础模型的系统,负责编排执行,决定模型如何思考和规划、调用工具和行动、感知和管理上下文、存储产物、以及评估结果。 本文将聚焦于 Harness 工程相关研究及其对 RSI 的贡献。近期大量关于自动研究、自我改进 Agent 和进化程序搜索的工作都可以围绕这个问题来组织。其他关于模型自对弈、合成数据、测试时训练以及持续学习的更广泛工作(如 Yuan et al. 2024, Chen et al. 2024, Zhao et al. 2025, Choi et al. 2026)也符合 RSI 愿景,但不是本文的重点。
Harness 设计模式
与早期 Agent 框架"Agent = LLM + 记忆 + 工具 + 规划 + 行动"相比,Harness 工程额外包含了工作流设计(如循环工程)、评估、权限控制和持久状态管理。它不再只是提示模板,而更接近运行时和软件系统设计:模型如何观察、行动、记忆、自检和改进。
设计应当刻意保持简单和通用以实现泛化,最好参考现有软件工程实践以利用预训练知识。操作系统和 Harness 之间有很强的类比——与 OS 类似,Harness 应当封装复杂逻辑同时保持接口简洁。同时,配置、工具接口和其他协议可能会逐步在行业内标准化。
模式一:工作流自动化
定义一个模型可以在其中操作、测试和迭代的工作流,是自动化的核心设计。Karpathy 的 autoresearch 仓库是此类工作流构建的干净示例。常见工作流遵循目标导向循环:规划、执行、观察/测试、改进,再次执行,直到目标达成。过程中可能触发对用户的主动请求,以澄清任务规格或执行偏好。
工作流图还强调了模型分析自身轨迹和失败案例,然后通过"Agent 运行时"而非静态提示模板来迭代改进进度。
模式二:文件系统作为持久记忆
长周期 Agent 系统中的一个反复出现的模式是:对丰富状态和产物的简单控制。Harness 不应将所有工作流和日志都放在上下文中;而应将持久状态保存在文件中。在长周期 Agent 执行中,实验日志、代码差异、论文摘要、错误追踪和历史轨迹等产物往往远超模型训练时的上下文窗口长度。
学习如何读取、写入和编辑文件系统(通常通过 bash 命令)是 LLM 的基础技能,因此以文件形式管理持久记忆自然会从核心模型能力的提升中获益。
模式三:子代理与后台任务
Harness 可以生成多个子代理并行执行并监控后台任务。当主代理需要搜索多个假设、并发运行实验或委托隔离子任务(避免污染主上下文)时,这很有用。父代理需要一个小型进程管理器:启动任务、检查日志、取消失败运行、将结果合并回主线程。
关键设计选择是让并行性显式且可检查。如果子代理输出只存在于瞬态对话上下文中,它们会很快过时并被隐藏。如果存储为文件、日志和状态记录,模型可以在中断后恢复,并对自身执行历史进行推理。
案例研究:编码 Agent 的 Harness
主流编码 Agent(Claude Code、Codex、OpenCode、Cursor 风格 Agent)的核心接口已趋于稳定。它们通常使用一个循环,配备一组工具,编码 Agent 能够在给定仓库中开发和调试问题,类似于人类开发者配备 IDE。 工具分组概览:
| |
|---|
| 文件发现:glob、grep、ls;文件读取:read、read_many;文件修改:write`(写全新文件)、edit(精确字符串替换)、multi_edit、apply_patch |
| |
| lsp、git 工具(git_status、git_diff、git_commit) |
| |
| web_search、web_fetch、浏览器工具 |
| |
| CronCreate、CronDelete、CronList |
| spawn_agent、resume_agent、wait_agent、list_agents、close_agent、interrupt_agent 等 |
Harness 层 vs 核心智能?
很难预测 RSI 的未来将在多大程度上依赖 Harness 工程,但近期 RSI 的实现路径不太可能从模型直接改写自身权重开始。我对近期实用路径的预测是:
- Harness 工程将朝着元方法论方向演进(即改进"获得更好答案的机制",而非只改进答案本身)。Harness 系统本身成为优化目标,启发式规则越来越少,通用机制越来越多。
- 反过来,成熟的 Harness 使模型自我改进的自动研究循环成为可能,而更聪明的模型防止 Harness 过度工程化,保持系统可持续。
最终,许多 Harness 改进可能会被内化到核心模型行为中,但与外部上下文和工具的接口应该会保留。我们已经在提示工程中看到了这种模式的温和版本:随着指令微调和模型推理能力的提升,手工提示技巧变得不再核心,但指定目标、约束、上下文和评估的需求并未消失。
Harness 优化
Harness 系统中被优化对象的演进大致为:指令提示 → 结构化上下文 → 工作流 → Harness 代码 → 优化器代码。随着模型变得更智能和强大,我们转向更复杂的目标和更通用的方法。
上下文工程
简单地将所有工具响应和模型生成追加到上下文中,会随着 Agent 任务周期的显著增加而迅速失控。上下文管理是一个为 LLM 构建更结构化、更简洁上下文并管理持久状态的层。毫无疑问,长上下文研究将持续进步,但目前长上下文智能和上下文工程有时相互交织。
Agentic Context Engineering(ACE;Zhang et al. 2025) 将上下文视为不断演化的手册,而非不断变长的提示。它包含三个组件,维护一个由条目(每条有标识符和描述)组成的上下文手册:
- 生成器(Generator):参考条目生成任务轨迹。
- 反思器(Reflector):从成功和失败轨迹中提炼洞察。
- 策展人(Curator):用增量、条目化的方式更新结构化上下文。
为防止迭代重写中的上下文坍缩和简洁偏差,ACE 的一个关键设计选择是:策展人不重写完整的提示文本块,而是输出结构化条目集合(标识符, 描述),这些条目通过确定性逻辑合并到结构化上下文日志中,定期精炼和去重。
ACE 从执行轨迹中学习洞察使我们走向自管理记忆,但更新规则和整体工作流仍是手工制作的。为走向更自我改进的循环,Meta Context Engineering(MCE;Ye et al. 2026) 将机制(如何管理上下文)与产物内容(上下文中有什么)分离,在元优化层运行技能演化,在基础层运行上下文优化。
MCE 的技能 定义上下文函数 ,将输入 映射为上下文 ,其中: 双层优化是在训练数据上找到给定技能 的最佳上下文 ,外层循环找到在验证集上表现最优的技能: 技能数据库追踪历史技能、上下文函数和评估指标 。元级 Agent 对先前技能执行"智能体交叉"以创建新技能:。 基础级上下文工程师执行技能 ,从执行反馈 中学习上下文函数:。 MCE 不像 ACE 那样强制规定如何结构化上下文,而是使用自由形式的技能存储任务最重要的知识,迭代地共同演化技能和技能条件化的上下文。实现上,上下文函数 被实例化为专用目录中的文件集合,包括静态(skill.md)和动态(上下文和数据轨迹)组件。元级和基础级优化都在标准工具集的 Agent 编码环境中执行: T={Read,Write,Edit,Bash,Glob,Grep,TodoWrite} Meta-Harness(Lee et al. 2026) 更进一步:被优化的对象是决定和优化"什么信息应被存储、检索和呈现给模型"的代码。其名称中的"Meta-"意味着它是一个用于优化 Harness 的 Harness。
提议新 Harness 的提案器本身就是编码 Agent,最终输出是帕累托前沿上的 Harness 候选集合。
- 完整执行历史通过文件系统可访问,编码 Agent 使用 grep`或 cat 等命令来读取,而非将所有内容塞入单一提示上下文。
- 提议的 Harness 是文件系统中的一个目录,包含自身源代码、分数、执行轨迹和状态更新。
- Meta-Harness 循环迭代创建新 Harness,只保留合格的。
重要经验是明确的:一旦 Harness 设计变成可执行的搜索空间,强大的编码 Agent 就能利用人类工程师使用的同一设计空间。
工作流设计
Harness 工程中的工作流设计可由领域专家手工制作。以自动研究为例,已有多种框架被提出和测试:
AI Scientist(Lu et al. 2026) 构建了一条管线:提出研究想法、编写代码、运行实验、分析结果、撰写手稿、执行同行评审。ScientistOne(Meng et al. 2026) 将可验证性作为核心设计约束——每个声明(引用、数值、方法、结论)都必须追溯到证据来源,并由"证据链检查"审计。
Autodata(Kulikov et al. 2026) 设计为数据科学家角色,用于生成训练和评估数据。主 Agent 管理一个挑战者(提出问题)、一个弱求解器、一个强求解器和一个验证器/裁判,旨在合成"恰好合适"难度的数据——强求解器成功但弱求解器失败。挑战者提示根据求解器和验证器的反馈迭代更新。局限是合成任务只用于微调弱求解器而非强求解器;如果循环无法迭代改进强模型,它更像是通过生成的提示分布进行间接蒸馏,RSI 味道较淡。
工作流的设计空间巨大,自然可以将工作流设计视为搜索问题,因此应该能通过算法找到好的解决方案,而不仅仅靠手工制作。
ADAS(Automated Design of Agentic Systems;Hu et al. 2025) 将 Agent 设计本身形式化为优化问题——"元 Agent 搜索",其中元 Agent 提议新的 Agent 工作流设计。元 Agent 先生成新工作流的高层描述,然后用代码实现,再经过两步自精炼检查其新颖性。
AFlow(Zhang et al. 2025) 将 Agent 工作流表示为图,其中节点代表 LLM 调用动作,边实现代码中的逻辑操作。工作流优化依赖 MCTS(蒙特卡洛树搜索):
- 让 LLM 根据评估性能生成修改后的工作流进行扩展
AFlow 在 QA、代码和数学任务上的实验显示,其相对手工设计工作流和 ADAS 有明显改进。
自我改进的 Harness
无论是上下文工程还是工作流设计,都只是 Harness 的一部分。我们需要搜索整个设计空间,同时优化上下文管理逻辑、工作流、权限和许多其他 Harness 组件。正如 Meta-Harness、ADAS 和 AFlow 中所见,代码是定义程序和系统的通用语言。简单说,Harness 是编程控制提示、工具调用、子代理、控制流、记忆和工作流逻辑如何协同工作的代码。如果 LLM 能优化执行 Agent 的代码,它就能访问比手写提示大得多的设计空间。
Self-Taught Optimizer(STOP;Zelikman et al. 2023) 是递归脚手架改进的早期示例。种子改进器 接收初始解 、效用函数 和黑盒语言模型 ,返回改进后的解 ,即 。STOP 的目标不是直接改进 ,而是改进改进器 本身。 定义元效用为给定改进器函数 在下游任务集合 上的平均效用: 因为改进改进器本身也是优化问题,可以递归获取新版本:
实验中,改进后的改进器发现了多种策略:遗传算法、分解并改进部分、多臂提示赌博机、模拟退火、变化温度、束/树搜索等。这类似于 Harness 工作流可被表示为优化对象。
值得警惕的结果是:STOP 在 GPT-4 上跨迭代改善了下游性能均值,但在较弱模型(GPT-3.5 和 Mixtral)上性能退化。递归结构本身不够——基础模型必须足够强大才能改进机制。这意味着 Harness 改进使模型得到更好的部署,但智能仍然是核心。
Self-Harness(Zhang et al. 2026) 依赖 LLM Agent 通过"提议-评估-接受"循环改进自身 Harness。循环包含三个阶段:
弱点挖掘: 将失败聚类为验证器锚定的失败模式。当前 Harness 用于评估任务,收集执行轨迹进行分析。两次运行可能在错误日志表面有相同的验证器结果(如超时或缺失产物),但有不同的因果机制。因此需要丰富的失败记录——包含终端验证器级原因、相关 Agent 行为的因果状态、轨迹暴露的抽象 Agent 机制——以揭示根本原因。 Harness 提议: 基于挖掘的失败模式提议有界的 Harness 编辑。同一模型在 下作为提议者被调用,提供有界提议上下文:(1) 当前 Harness 的可编辑面、(2) 验证器锚定的失败模式、(3) 应保留的通过行为记录、(4) 先前尝试编辑的摘要。编辑应优先选择可解决的反复出错模式(非任务特定难度),且能通过窄范围更改解决。 提议验证: 验证并合并合格编辑以创建新 Harness 。候选编辑在持有数据 (测试弱点是否解决)和留出数据 (检查是否引入其他问题)上评估。只有在两者上都无回归的候选才被接受并合并。 在 MiniMax M2.5、Qwen3.5-35B-A3B 和 GLM-5 上运行 Terminal-Bench-2 时,Self-Harness 能学到针对不同基础模型不同弱点的模型特定 Harness 指令,改善留出通过率。
Self-Harness 类工作确实引发了我的担忧:如果程序被允许编辑 OS 系统,抽象边界就被打破了。可编辑面需要适当设计,权限控制和安全层需要存在于此循环之外。奖励作弊的所有挑战仍然存在。
进化搜索
进化搜索是受自然选择启发的优化方法。它通过变异进化一个解群体,只保留群体中"适应度"高的个体。进化搜索在以下条件下很有用:(1) 搜索空间广阔或形状奇特;(2) 难以用梯度直接优化但容易评估解。Harness 搜索似乎很适合。
Promptbreeder(Fernando et al. 2023) 通过丰富的变异操作优化任务特定提示,有趣的是变异提示(即指示 LLM 变异任务提示的指令)本身也通过进化改进。GEPA(Agrawal et al. 2025) 结合基于反思的提示与进化搜索,使用对试错轨迹的自然语言反思来提议提示更新。
AlphaEvolve(Novikov et al. 2025) 是编码 Agent 进化搜索系统,存储候选程序池并提示冻结的 LLM 生成改进差异。系统反复评估子程序并保留成功的,随时间发现更好的解。几个设计细节很重要:
- 编码 Agent 可访问完整仓库,但待改进的代码区域用 # EVOLVE-BLOCK-START 和 # EVOLVE-BLOCK-END显式标记
- 元提示与指令和上下文共同演化,方式类似于演化解程序
后续变体如 ThetaEvolve(Wang et al. 2025) 结合进化搜索与 RL 和上下文学习。ShinkaEvolve(Lange et al. 2025) 引入三个新组件改善 LLM 采样效率:
- 通过设计平衡性能排名和后代数量的父代采样实现更高采样效率的探索
- 基于嵌入余弦相似度的代码新颖性拒绝采样——丢弃与现有群体过于相似的候选
与上述聚焦于解改进的方法不同,Darwin Gödel Machine(DGM;Zhang et al. 2025) 明确以可编辑的 Harness 代码仓库作为 LLM 编码 Agent 的进化目标。该 Agent 被允许修改自身 Harness。后续工作 Hyperagents(Zhang et al. 2026) 引入元 Agent 来控制如何修改现有任务 Agent 以创建新 Agent。
DGM 流程:
- 每次迭代,以与性能成正比、与子代数量成反比的概率选一个父代,修改并分支产生新 Agent
- 被选父代检查自身基准评估日志,然后提议对自身 Harness 代码库的改进以生成新版本编码 Agent
- 新编码 Agent 被评估,只有性能足够高的才加入池
DGM 是固定模型下的 Harness 进化。在以 Claude 3.5 Sonnet 为基础 LLM 和简单初始 Harness 配置的实验中,DGM 发现的 Agent 在 SWE-bench Verified(20% → 50%)和 Polyglot(14.2% → 30.7%)上可媲美或超越手工 Agent。 这类方法在候选解可自动评估且适应度易量化时效果良好(如矩阵乘法、GPU 核优化、算法竞赛、数据中心调度)。在评估缓慢、模糊或主要基于启发式的领域则表现困难。进化的计算效率和有效性也是顾虑。
与模型权重的联合优化
Harness 进化改变的是模型周围的非参数化系统。要实现完全的自我改进,模型完全可以被允许同时更新自身权重。权重更新可通过改进模型训练管线或测试时持续学习来实现。持续学习这个话题值得未来单独写一篇。
SIA(Hebbar et al. 2026) 是在同一优化循环中结合 Harness 改进和模型参数更新的早期尝试,设计包含三个组件:
- 元 Agent(Meta-Agent):提议初始 Harness
- 任务特定 Agent(Task-Specific Agent):执行任务
- 反馈 Agent(Feedback-Agent):根据最近轨迹决定是更新 Harness 还是模型权重
SIA 实验中有几个混淆因素使结果难以解读。例如任务特定 Agent 比元 Agent 和反馈 Agent 使用的模型弱得多(gpt-oss-120b vs Claude Sonnet 4.6),基线太弱无法与相关方法干净交叉对比。我认为这个方向有趣,但证据是初步的。训练稳定性和 Goodhart 效应等许多挑战仍然开放。
未来挑战
AI Scientist 系列工作有力地证明了专家设计的 Harness 可以协调自动研究循环的大部分环节,实验形式为撰写研究论文。但论文产出不等同于科学发现。系统可以写出看似合理的手稿,同时仍可能存在虚构引用、实现偏移或薄弱的实验结果。
Trehan & Chopra(2026)测试了 LLM 能否用最小脚手架和基本工具(read_file、write_file、llm_search、list_files)从研究想法走到论文。他们在三个领域(世界模型、多智能体 RL、AI 安全与对齐)实验,每个领域 45-50 篇高质量种子文档。最终只有四个想法被人类专家选中进入完整管线,其中只有一个被完整执行为论文。他们观察到六种反复出现的失败模式:
偏向训练数据默认值: 使用旧库、过时命令、标准格式或不基于实际仓库/数据集的假设。
执行压力下的实现偏移: 当实现变得技术复杂时,模型可能转向常见的更简单解决方案,而非提议的方法。
记忆和上下文退化: 长周期项目会丢失关键细节,除非日志被写为持久产物。
过度乐观: 模型在嘈杂或失败的实验中宣称成功。Bubeck et al.(2025)也观察到类似的"p-hacking 和 eureka 式"模式——模型引入"数值胶带"并在信号仍是噪声时宣布胜利。
领域智能不足: 模型缺乏隐性专业知识,如预测实现复杂度、判断实验结果是否合理、知道哪些基线重要。
科学品味薄弱: 实验可能可执行但无法回答正确的问题。
走向完全 RSI,研究者已取得实际进展,但几个瓶颈仍存:
1. 弱且模糊的评估器。 许多研究声明没有快速精确的验证器,真实世界任务同样如此。当前自我改进循环在评估指标可测量且客观时效果最好,类似 RL 的工作方式。研究品味、新颖性和长期科学价值则更难衡量。例如研究品味往往混合了问题构建、实验设计和关于哪些意外结果值得追踪、哪些失败值得重试的判断。
2. 上下文和记忆生命周期。 随着 AI Agent 变得更自主和独立,记忆会增长。有用的 Harness 需要管理上下文和记忆来补充长上下文生成的现有局限,同时最大化长周期任务的成功。既然人类能维持一生的记忆,我看到一个类比:上下文工程将会并且应该成为智能的核心部分,而非停留在软件系统层。
3. 负结果。 研究者被激励发表成功结果,因此文献偏向成功。基于大量(大部分人类创建的)数据训练的 LLM 可能不善于决定何时放弃假设、报告负结果或承认失败——由于数据中成功与失败案例的不平衡。研究 Harness 应使失败尝试易于保存——从失败中学习是削减任务搜索空间的最好方式。
4. 多样性坍缩。 进化和 RL 循环倾向于利用已知的高奖励模式。我们需要机制防止群体坍缩为同一解的变体。这对开放式研究尤为关键——最佳路径在当前评估器下可能最初看起来更差。
5. 奖励作弊。 自我改进循环优化给定的任何信号。如果奖励来自单元测试,Agent 可能过拟合测试;如果来自裁判模型,可能学到特定于该裁判的作弊技巧;如果来自基准分数,可能利用基准产物。评估器和权限控制应该位于演化 Harness 的循环之外,配合留出测试、轨迹审计和在关键决策点的人类审查——多少监督能被扩大和自动化仍是开放研究领域。
6. 长期成功。 外在优化循环作用于我们能在训练沙盒中模拟的单次执行之外的奖励。以编码 Agent 为例:编码 Agent 已经提升了软件工程的日常生产力,但许多优化目标仍然太短期。它通常能完成手头任务,但不太明显它应如何保护由数百或数千工程师集体维护的仓库的长期健康。标准的基于沙盒的 RLVR 训练很少捕获可维护性、所有权边界、迁移成本、向后兼容性或未来调试负担。
7. 人类的角色。 人类应该向上移动,而非被从循环中移除——意味着人类应在正确的时间、正确的抽象层级提供监督,我们的系统设计应考虑何时以及如何设置这些接触点。
上述许多挑战需要人类的反馈和引导。毕竟,我们是为了人类更好的未来而构建技术,而非相反。
附录:一些有用的基准
PaperBench: 从头复现 20 篇 ICML 2024 Spotlight 和 Oral 论文,包括理解论文贡献、开发代码库和成功执行实验。共 8316 个评分标准,与论文作者共同开发。当时最好的模型(Claude 3.5 Sonnet,约 21%)未超过 ML 博士。
CORE-Bench: 评估已发表研究的计算可复现性。270 个任务基于 90 篇跨计算机科学、社会科学和医学的论文。任务涉及从提供的代码和数据中复现结果。包含多个难度级别和纯语言/视觉语言任务。当时最好的 Agent(GPT-4o 和 GPT-4o-mini)在最难任务上只达到 21% 准确率。
ScienceAgentBench: 评估 LLM Agent 的数据驱动科学发现能力。从 44 篇四个学科(数学、化学、生物、地理)的同行评审论文中提取 102 个任务。覆盖这些领域的基础数据科学任务:数据处理、模型开发、数据分析和信息可视化。
RE-Bench: 在真实 ML 研究工程环境中对比前沿 AI Agent 与人类专家。7 个具有挑战性的开放式 ML 研究工程环境。每个环境 = (评分函数, 起始解, 参考解);每个可用 8 个以下 H100 GPU 运行。包含 61 位人类专家的 71 次 8 小时尝试数据。人类专家在 82% 的 8 小时尝试中获得非零分;24% 达到或超过强参考解。最佳 AI Agent 在 2 小时预算下得分比人类高 4 倍,但人类在更长预算下回报更好,在 8 小时和 32 小时设定下超过 Agent。
MLE-bench: 在离线 Kaggle 竞赛上评估 ML 工程 Agent。包含 75 个从 Kaggle 精选的 ML 工程竞赛。测试训练模型、准备数据集、运行实验和提交预测。使用 Kaggle 公开排行榜作为人类基线。最佳设定(o1-preview + AIDE 脚手架)在 16.9% 的竞赛中达到至少 Kaggle 铜牌水平。
KernelBench: 评估生成 GPU 核的正确性和速度。250 个 PyTorch 任务,评估 LLM 能否写出快速且正确的核。评估指标 fast_p = 正确且比基线更快的生成核百分比。
参考文献
[1] Good, I. J. "Speculations Concerning the First Ultraintelligent Machine." Advances in Computers, 6:31–88, 1965.
[2] Yudkowsky, Eliezer. "Recursive Self-Improvement." LessWrong, 2008.
[3] Choi, et al. "Anchored Self-Play for Code Repair." ICML 2026.
[4] Zhao, et al. "Absolute Zero: Reinforced Self-play Reasoning with Zero Data." arXiv:2505.03335, 2025.
[5] Yuan, et al. "Self-Rewarding Language Models." arXiv:2401.10020, 2024.
[6] Chen, et al. "Self-Play Fine-Tuning Converts Weak Language Models to Strong Language Models." ICML 2024.
[7] Zhang, et al. "Agentic Context Engineering: Evolving Contexts for Self-Improving Language Models." ICLR 2026.
[8] Ye, et al. "Meta Context Engineering via Agentic Skill Evolution." arXiv:2601.21557, 2026.
[9] Lee, et al. "Meta-Harness: End-to-End Optimization of Model Harnesses." arXiv:2603.28052, 2026.
[10] Lu, et al. "Towards end-to-end automation of AI research." Nature, 651:914–919, 2026.
[11] Meng, et al. "ScientistOne: Towards Human-Level Autonomous Research via Chain-of-Evidence." arXiv:2605.26340, 2026.
[12] Kulikov, et al. "Autodata: An agentic data scientist to create high quality synthetic data." arXiv:2606.25996, 2026.
[13] Hu, Lu, and Clune. "Automated Design of Agentic Systems." ICLR 2025.
[14] Madaan, et al. "Self-Refine: Iterative Refinement with Self-Feedback." NeurIPS 2023.
[15] Zhang, et al. "AFlow: Automating Agentic Workflow Generation." ICLR 2025.
[16] Zelikman, et al. "Self-Taught Optimizer (STOP): Recursively Self-Improving Code Generation." COLM 2024.
[17] Zhang, et al. "Self-Harness: Harnesses That Improve Themselves." arXiv:2606.09498, 2026.
[18] Fernando, et al. "Promptbreeder: Self-Referential Self-Improvement Via Prompt Evolution." arXiv:2309.16797, 2023.
[19] Agrawal, A. et al. "GEPA: Reflective Prompt Evolution Can Outperform Reinforcement Learning." arXiv:2507.19457, 2025.
[20] Novikov, et al. "AlphaEvolve: A coding agent for scientific and algorithmic discovery." arXiv:2506.13131, 2025.
[21] Lange, Imajuku, and Cetin. "ShinkaEvolve: Towards Open-Ended And Sample-Efficient Program Evolution." arXiv:2509.19349, 2025.
[22] Wang, et al. "ThetaEvolve: Test-time Learning on Open Problems." arXiv:2511.23473, 2025.
[23] Zhang, et al. "Darwin Gödel Machine: Open-Ended Evolution of Self-Improving Agents." arXiv:2505.22954, 2025.
[24] Zhang, et al. "Hyperagents." arXiv:2603.19461, 2026.
[25] Yuksekgonul, et al. "Learning to Discover at Test Time." arXiv:2601.16175, 2026.
[26] Riaz, et al. "Epistemic Uncertainty for Test-Time Discovery." arXiv:2605.11328, 2026.
[27] Hebbar, et al. "SIA: Self Improving AI with Harness & Weight Updates." arXiv:2605.27276, 2026.
[28] Trehan and Chopra. "Why LLMs Aren't Scientists Yet: Lessons from Four Autonomous Research Attempts." arXiv:2601.03315, 2026.
[29] Bubeck, et al. "Early science acceleration experiments with GPT-5." arXiv:2511.16072, 2025.
[30] Starace, et al. "PaperBench: Evaluating AI's Ability to Replicate AI Research." ICML 2025.
[31] Wijk, et al. "RE-Bench: Evaluating frontier AI R&D capabilities of language model agents against human experts." ICML 2025.
[32] Chan, et al. "MLE-bench: Evaluating Machine Learning Agents on Machine Learning Engineering." arXiv:2410.07095, 2024.
[33] Chen, et al. "ScienceAgentBench: Toward Rigorous Assessment of Language Agents for Data-Driven Scientific Discovery." ICLR 2025.
[34] Siegel, et al. "CORE-Bench: Fostering the Credibility of Published Research Through a Computational Reproducibility Agent Benchmark." TMLR 2024.
[35] Ouyang, et al. "KernelBench: Can LLMs Write Efficient GPU Kernels?" arXiv:2502.10517, 2025.
 AI 速览