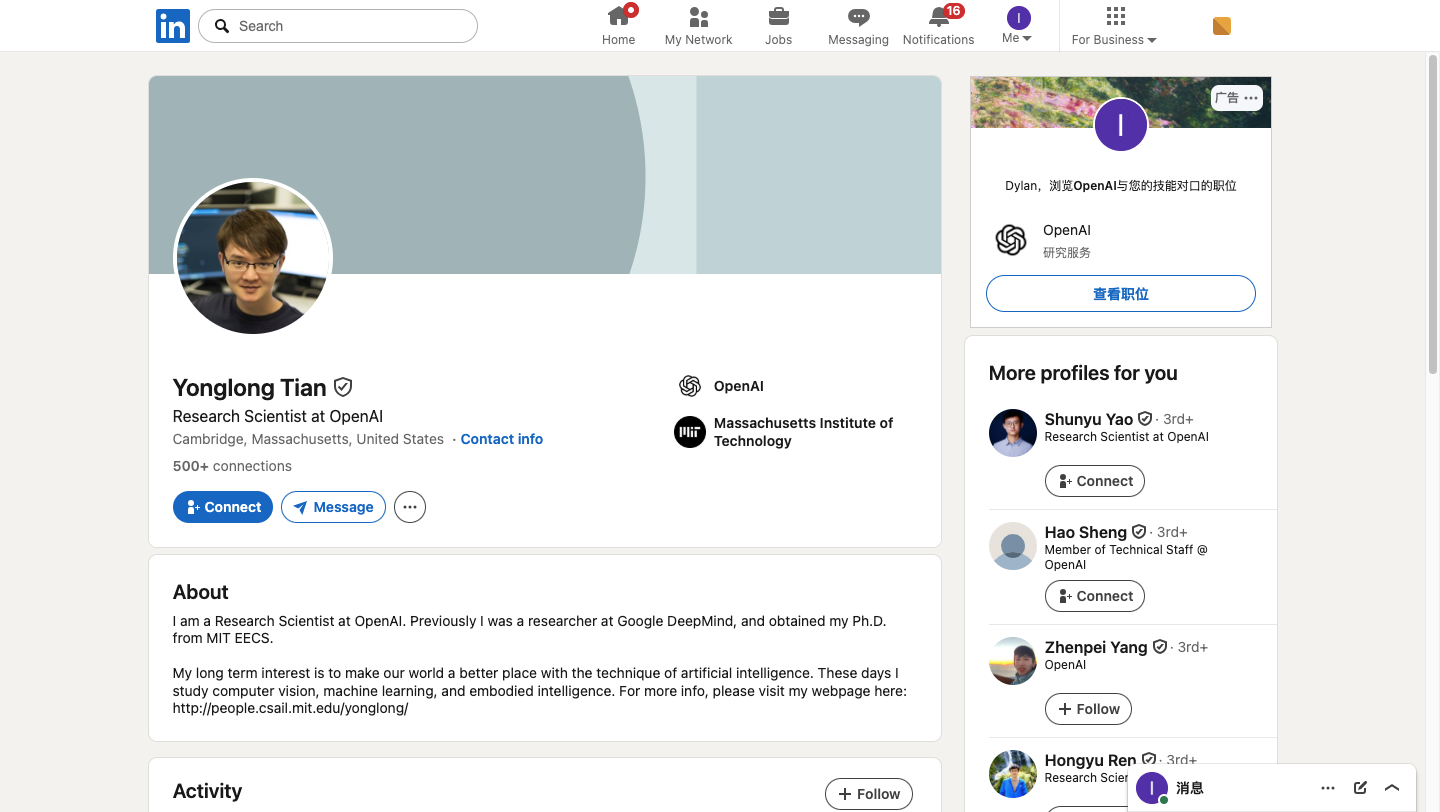
7月8日消息,据澎湃新闻从腾讯相关负责人处确认,OpenAI 前研究员田永龙(Yonglong Tian)已于近期加入腾讯大语言模型部,后续将参与 VLM(视觉语言模型)相关研发。田永龙此前在 OpenAI 担任研究团队成员,参与了 GPT-5 的研发工作。他是对比学习领域的关键贡献者,谷歌学术被引量达 29330 次。这是继 2025 年 12 月姚顺雨之后,腾讯半年内第二次从 OpenAI 引入核心研究人员,两人此前在 OpenAI 为同事关系。田永龙的加入指向明确方向:混元 Hy3 文本模型已于 7 月 6 日正式发布,下一步的重心将转向多模态。
对比学习奠基人之一,从清华到 MIT 到 Google 到 OpenAI
田永龙本科毕业于清华大学,随后在香港中文大学攻读硕士,师从计算机视觉先驱汤晓鸥和王晓刚(两人均为商汤科技联合创始人)。博士阶段进入麻省理工学院,师从知名计算机视觉研究者 Phillip Isola。
他最具影响力的工作有两篇。一是作为共同作者的 Supervised Contrastive Learning,提出了监督对比损失概念,将自监督学习中的批次对比方法扩展到全监督场景,应用该策略的 ResNet-200 在 ImageNet 上达到 81.4% Top-1 准确率。二是作为第一作者的 Contrastive Multiview Coding,提出对比多视图编码方法,通过让同一场景的不同视图在特征空间中相互靠近来最大化视图间共享的互信息,该工作直接影响了后续 SimCLR、MoCo 等主流自监督方法的设计。
博士毕业后,田永龙先加入 Google Research 担任资深研究科学家,2024 年 5 月转至 DeepMind 担任相同职务,同年 10 月加入 OpenAI。在 OpenAI 期间参与 GPT-5 研发,直至近期离职加入腾讯。他的研究主线始终围绕视觉表征学习和跨模态对齐——这正是 VLM 的技术基底。
姚顺雨主导架构重建,Hy3 是第一个交付物
田永龙加入的腾讯大语言模型部,负责人正是姚顺雨。2025 年 12 月 17 日,腾讯宣布升级大模型研发架构,1998 年出生的姚顺雨出任"CEO/总裁办公室"首席 AI 科学家,向刘炽平直接汇报,同时兼任 AI Infra 部和大语言模型部负责人。姚顺雨同样来自 OpenAI,在 OpenAI 期间参与了智能体产品 Operator 和 Deep Research 的核心开发,更早期的学术贡献包括 ReAct 框架和思维树理论。
姚顺雨到任后,腾讯混元经历了一次完整的底层重建。2026 年 1 月底重建预训练和强化学习基础设施,4 月 23 日发布 Hy3 Preview,7 月 6 日 Hy3 正式版上线。Hy3 采用 MoE 架构,总参数 295B、激活参数 21B,支持 256K 上下文,API 定价输入 1 元/百万 Token、输出 4 元/百万 Token,以 Apache 2.0 协议开源。在内部 270 位专家盲测中,Hy3 均分 2.67/4,高于智谱 GLM-5.1 的 2.51/4。WorkBuddy 办公场景中任务解决率从 Preview 版的 72% 跃升至 90%,平均耗时缩短 34%。 从 1 月重建到 7 月正式版,不到半年跑通了底层重构到产品落地的全链路。这是姚顺雨团队交出的第一份答卷,也是田永龙加入时的团队基线。
腾讯过去半年的人才布局指向同一个方向:原生多模态
田永龙不是孤立的一次招聘。过去半年,腾讯在多模态和视觉方向的人才引进呈现系统性特征。今年年初,前新加坡 Sea AI Lab 研究员庞天宇加盟腾讯混元多模态部 Exploration Center,担任强化学习首席研究员及技术负责人。2025 年,腾讯还引入了原阿里通义实验室应用视觉团队负责人薄列峰、微软亚洲研究院原首席研究员胡瀚。
这些招聘覆盖了多模态模型研发的几乎所有关键能力层:视觉表征学习和跨模态对齐(田永龙)、多模态强化学习(庞天宇)、应用视觉(薄列峰)、基础视觉研究(胡瀚)。再加上姚顺雨本人在 Agent 架构和推理框架上的积累,腾讯正在为原生多模态模型的研发组建一支完整的技术拼图。
Hy3 解决了文本基座问题,下一步的瓶颈在视觉编码
从产品节奏看,Hy3 正式版的发布意味着文本基座模型已进入可用状态。腾讯官方表述"90% 的 Agent 任务可以用 Hy3 成功执行",说明文本能力不再是最紧迫的短板。田永龙在 Hy3 发布两天后被官宣加入、且明确参与 VLM 研发,时间节点说明多模态是混元团队接下来的优先事项。
田永龙的研究履历恰好对准了 VLM 的核心技术难点。视觉语言模型的关键挑战不在文本侧(有 Hy3 做底座),而在视觉编码器的质量和跨模态对齐的效率。田永龙在对比学习和视觉表征方面十余年的积累,叠加他在 OpenAI 参与 GPT-5 时积累的大规模训练经验,使他成为腾讯补强多模态视觉侧能力的精准人选。
需要注意的是,人才到位和产品交付之间存在时间差。田永龙刚加入,混元的原生多模态模型距离对外发布还需要数月以上的研发周期。目前腾讯在多模态生成方面已有混元视频等产品线,但原生多模态理解模型(类似 GPT-5 的视觉能力或 Gemini 的原生多模态架构)尚未公开发布。这次招聘信号的释放先于产品,验证节点要看未来两到三个季度是否有对应的模型发布。 接下来要看的是混元多模态模型何时亮相
腾讯 2025 年 4 月曾将大模型研发拆分为大语言模型部和多模态模型部两条轨道。田永龙加入的是大语言模型部参与 VLM 研发,而非多模态模型部。这个组织归属可能意味着腾讯的 VLM 方向由文本基座团队主导推进——以文本模型为底座扩展视觉能力,而非从视觉侧独立构建。这一路径选择与 OpenAI 的做法一致(GPT 系列从文本扩展到多模态),与 Google Gemini 的原生多模态架构不同。下一个验证点是腾讯是否会在 2026 年下半年发布一款基于 Hy3 底座的原生视觉语言模型,以及它在多模态理解和生成两个方向上各走到什么程度。
 AI 速览