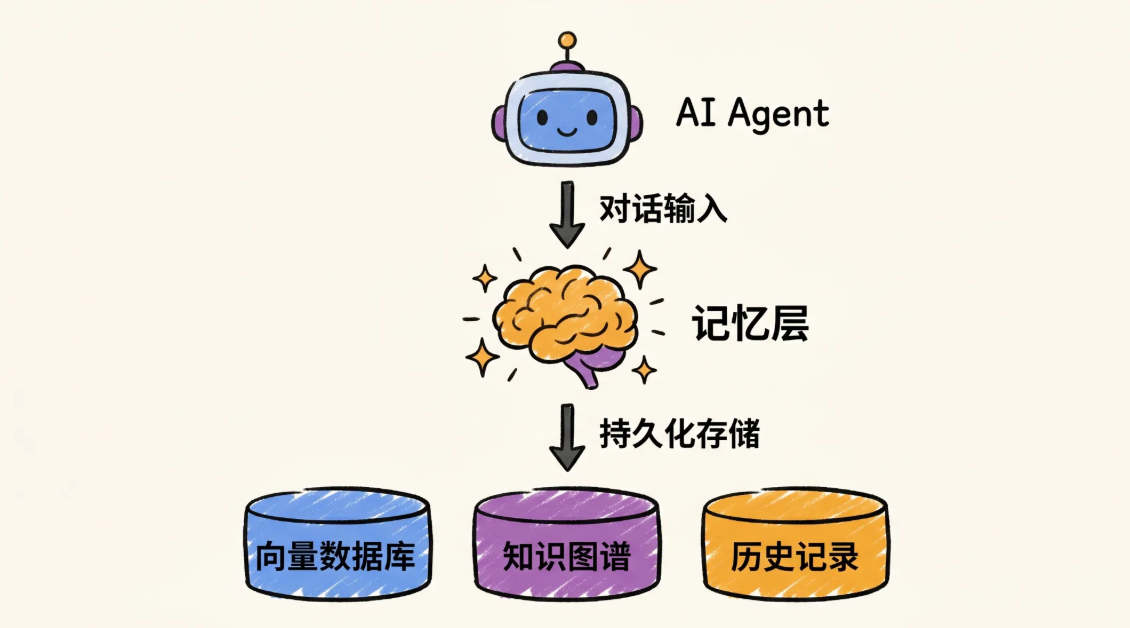
大模型本身没有记忆,Agent要想记住用户偏好和历史决策,靠的不是聊天记录堆上下文,而是一套独立的记忆层。这篇拆开源框架 Mem0,看它具体怎么把对话变成能查、能追、能演化的长期记忆。
大模型请求结束就忘事儿了,这个你肯定知道。每次请求都得把历史消息喂回去,才能让模型"记住"刚才聊了啥——但这只能解决短期上下文,解决不了 Agent 长期协作的问题。一个好用的 Agent 不能老问用户喜欢什么,它得记住偏好、记住历史决策和任务状态,然后在合适的时候把这些东西捞回来喂给模型,让模型在当下做出正确判断。这就是记忆层要干的事,它不是简单存了聊天记录,而是要把交互历史压缩成可检索、可追溯、可演化的长期上下文。以前做 Agent 大多是自己写代码搞这套东西,今天就拆一下开源的 Mem0,看它咋实现的,有没有能借鉴的地方。
Mem0 是什么、怎么接入 Agent
Mem0 在 GitHub 上(mem0ai/mem0)star 数将近 6 万,官网是 mem0.ai。接入方式官方给了三种:云端 API、自建部署、直接用 SDK,代码逻辑都一样,只是部署形态不同。个人本地用 SDK 就行,数据存本地;企业级选自建 host;不想折腾就用云端 API。这里主要拆开源 SDK 这块。
核心入口在 mem0/memory/main.py 里的 Memory 和 AsyncMemory初始化的时候会拉起几个组件:负责从对话里抽事实的 llm,负责向量化的 embedding_model,主存储 vector_store(默认 Qdrant,也能换成 pgvector、Redis、Milvus、Pinecone),本地 SQLite 管理变更历史和最近消息窗口,一个懒加载的 entity_store 把实体和记忆 ID 连起来,还有个可选的 reranker 做二次排序。
记忆写入流程:从对话到长期记忆
你调 add() 方法丢一段对话进去,得带上 user_id、agent_id、run_id 这类归属字段,不然后面根本没法区分这是谁的记忆。Mem0 收到消息不会直接存,先去 SQLite 拿这个用户最近 10 条消息,再去向量库捞 10 条相关旧记忆,把"新对话+近期消息+旧记忆"一起丢给 LLM,让它判断这段对话有没有值得长期保存的东西——用户偏好、计划、长期目标之类。纯寒暄不会抽出新记忆。LLM 输出的是结构化 JSON,标注每条记忆是谁说的(attributed_to),以及和哪些旧记忆有关联。抽完之后向量化,做一次基于哈希的去重,再写进向量库,同时在 SQLite 里记一条 history,最后从新记忆里抽实体存进 Entity Store。
ADD-only 写入策略与记忆去重机制
写入策略上,Mem0 v3 是偏 ADD-only 的,新事实默认作为新记忆加进去,不是覆盖旧的。这跟摘要式记忆不一样——摘要会把"以前喜欢咖啡,后来喜欢茶"压缩成一条"喜欢喝茶",时间线就没了,你问"我啥时候开始喜欢喝茶的",它答不上来。ADD-only 保留了事实的演化轨迹,方便做时间推理和冲突处理。但这样会不会记忆爆炸?Mem0 做了两层控制:LLM 在看到旧记忆后尽量不重复抽取;SDK 对新记忆算 md5 哈希,重复的直接跳过写入。当然业务侧也需要主动管理,所以 Mem0 也提供了 update 和 delete 方法。
Entity Store 实体索引怎么把记忆连起来
Entity Store 这块有点意思,它不是搭知识图谱那种实体间关系,而是把抽出来的实体(人名、地点、产品名之类)和记忆 ID 关联起来,形成"实体→多条记忆"的索引。实体去重先做规范化文本精确匹配,没命中再走向量搜索,过了阈值才算同一实体,命中后更新它关联的记忆 ID 列表。
检索流程:语义、BM25、实体三路信号融合
检索这边,Agent 回答前调 memory.search()Mem0 内部走三路信号:语义相似度(embedding)、BM25 关键词匹配、实体加权。查询会先扩大到 top_k 的 4 倍形成候选池,避免过早丢掉相关记忆,最后融合打分时用一个动态分母把三路分数归一化,防止多开几个信号分数就虚高。
把 Mem0 接进自己的 Agent 要注意什么
要接进自己的 Agent,思路不复杂:回复用户前先 search 把相关记忆塞进上下文,回复完再把这轮对话丢给 Mem0 抽取保存(最好异步,别拖慢主流程)。作用域设计要想清楚——个人偏好用 user_id,单次任务用 run_id,Agent 自身能力沉淀用 agent_id;用 metadata 做业务隔离;高精度场景(客服、法务)开 reranker 更稳。有个容易被忽略的点:不是每轮回复都该无脑调 add()。像写作 Agent 输出一大段正文,直接扔进去提取实体,会抽出一堆没意义的东西,这种场景得先筛内容,或者干脆把 add() 封装成工具让 Agent 按需调用。
记忆层说到底就是把发生过的事存下来,保证以后能翻出来用。Mem0 的做法是 LLM 抽事实、向量库存内容、SQLite 记变更和近期上下文、实体索引做关联。真正要花心思的不是接入代码本身,而是想清楚什么该记、怎么隔离不同用户、什么时候该去查——这几件事想明白了,用起来其实没那么复杂。
 AI 速览