7月10日消息,Meta Superintelligence Labs 发布 Muse Spark 1.1,同步开放 Meta Model API 公测。这是 Meta 首次以付费 API 向外部开发者出售自研闭源模型。模型面向智能体、编程与计算机操控,支持约 100 万 Token 上下文,API 定价为每百万输入 Token 1.25 美元、输出 4.25 美元。这一价格显著低于 OpenAI 和 Anthropic 的同级产品,但模型在长程编码任务上仍落后于 GPT-5.5 与 Claude Opus 4.8。更值得关注的不是单个模型的强弱,而是 Meta 从三年开源路线的实质性转向:前沿能力移入 API 付费墙,Llama 进入维护而非进攻周期。公测目前仅面向美国开发者,全球可用性与定价稳定性尚无时间表。 7 月 9 日消息,Meta Superintelligence Labs 发布 Muse Spark 1.1,同步开放 Meta Model API 公测。这是 Meta 首次以付费 API 向外部开发者出售自研闭源模型。模型面向智能体、编程与计算机操控,支持约 100 万 Token 上下文,API 定价为每百万输入 Token 1.25 美元、输出 4.25 美元。这一价格显著低于 OpenAI 和 Anthropic 的同级产品,但模型在长程编码任务上仍落后于 GPT-5.5 与 Claude Opus 4.8。独立评测机构 Vals AI 的结果显示,Muse Spark 1.1 在医疗文档、税务问答和法律智能体三项专业领域评测中均排名第一,但网页应用编程仍落后于 Fable 5。更值得关注的不是单个模型的强弱,而是 Meta 从三年开源路线的实质性转向:前沿能力移入 API 付费墙,Llama 进入维护而非进攻周期。公测目前仅面向美国开发者,全球可用性与定价稳定性尚无时间表。
模型能力:工具调用领先,编程和长程任务仍有差距
据 Meta 官方评估报告及第三方对比,Muse Spark 1.1 在智能体工具调用方向表现最强。MCP Atlas(大规模工具使用)得分 88.1,高于 Claude Opus 4.8 的约 82 与 GPT-5.5 的约 75;JobBench(职业工具使用)得分 54.7,同样领先。模型可协调多代理并行执行任务,主动管理上下文窗口,在长会话中记住早期动作并压缩非关键步骤。
编码方向的差距更明确。Terminal-Bench 2.1 得分 80.0,落后于 GPT-5.5 的 83.4 与 Opus 4.8 的 82.7;SWE-Bench Pro 得分 61.5,落后于 Opus 4.8 的 69.2;DeepSWE 1.1(长程智能体编程)得分 53.3,落后于 GPT-5.5 的 67.0 与 Opus 4.8 的 59.0。Meta 在官方博客中承认编码仍是重点投入方向,称更强的编码模型已在训练中。
在计算机操控与多模态方面,OSWorld-Verified 得分 80.8,接近 Opus 4.8 的 83.4。模型被训练为在需要时写脚本自动化,在简单操作时直接点击,在每步生成批量动作。
Vals AI 独立评测:专业领域三项第一,编程未登顶
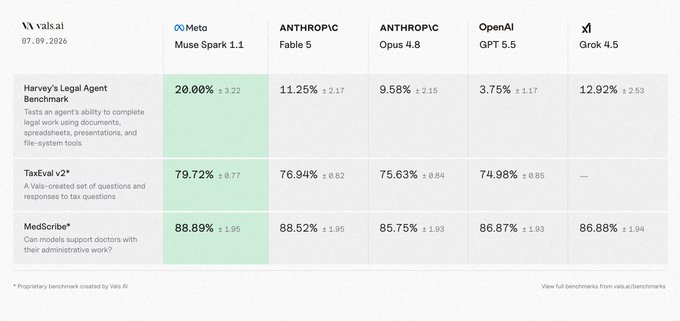
AI 评测机构 Vals AI 公布了 Muse Spark 1.1 在四项独立基准上的成绩。在医疗文档评测中,Muse Spark 1.1 得分 88.89%,略高于 Fable 5 的 88.52%,排名第一。在税务问答评测中得分 79.72%,同样排名第一,优于 Fable 5、Opus 4.8 和 GPT-5.5。该项测试集包含 1223 道未公开题目,评分同时核查答案和推理过程。
法律智能体评测的结果更能说明 Muse Spark 1.1 的智能体优势。该项评测要求模型在文档、表格、演示文稿和文件工具上执行操作,只有满足所有评分标准才计为完成。Muse Spark 1.1 任务完成率为 20.00%,超过 Grok 4.5 的 12.92% 和 Fable 5 的 11.25%。绝对完成率虽低,但在现有模型中领先幅度明显。 网页应用编程评测的结果与 Meta 官方数据一致:Muse Spark 1.1 得分 72.16%,超过 GPT-5.5、Grok 4.5 和 GPT-5.4,但仍落后于 Fable 5 和数个 Claude 系列模型。编程进入前列但未登顶。
Vals AI 的数据提供了一个独立于 Meta 自报的验证视角:Muse Spark 1.1 在需要工具操作和领域知识结合的专业任务中确实领先,这与 MCP Atlas 和 JobBench 上的优势形成交叉印证。编程方向的短板同样得到第三方确认。
Meta Model API:首次向外部开发者收费
Meta Model API 以公测形态发布,面向美国开发者开放。定价为每百万输入 Token 1.25 美元、输出 4.25 美元,缓存输入 0.15 美元,Web 搜索接地 2.50 美元/千次查询。新账户获赠 20 美元额度。API 兼容 OpenAI 和 Anthropic SDK,基础 URL 为 api.meta.ai/v1,模型 ID 为 muse-spark-1.1。
这是 Meta 历史上首次对自研模型收费。此前三年,Meta 通过 Llama 系列免费开放权重,借此降低竞争对手的 API 收入。转向收费意味着 Meta 判断智能体 API 层的直接营收比开源带来的间接生态收益更有价值。Replit CEO Amjad Masad 在官方博客中将模型评价为"完整的智能体基础",称其在百万级上下文、多模态、搜索、推理、编码和结构化输出上一体化集成。
从 Llama 到 Muse Spark:前沿能力已在 API 付费墙之后
2026 年 4 月 8 日,Meta 发布初代 Muse Spark——第一款由 Superintelligence Labs 开发的闭源模型,标志着路线切换正式开始。Superintelligence Labs 由前 Scale AI CEO Alexandr Wang 领导,2025 年成立。初代 Muse Spark 发布后三个月,1.1 版本接棒并首次以付费 API 向外部开发者开放。
Meta 未正式宣布终止 Llama,现有 Llama 模型仍可下载使用。但多家媒体引述内部消息与公开资源分配信号指出,Llama 将进入维护周期,前沿投入已全面转向 Muse Spark。The New Stack 报道称,Meta 内部工程师在 Muse Spark 到来前已大规模迁移至 Claude Sonnet。Llama 用户没有到 Muse Spark 的迁移路径——前者可本地部署和微调,后者仅限云端 API 调用。
对此前依赖 Llama 开源模型的开发者而言,选项变为:继续使用逐渐落后的 Llama;切换至 Mistral、DeepSeek 或 Qwen 等替代开源模型;或迁移至各家闭源 API。 定价策略的信号:低价换开发者迁移,不是旗舰溢价
Muse Spark 1.1 的输出价格 4.25 美元/百万 Token,约为 Claude Opus 4.8 的六分之一、GPT-5.5 的七分之一。在智能体工作负载高频调用的场景下,这个差距意味着同等预算可完成数倍任务量。但需要注意,模型采用推理模式,内部思考 Token 按输出价格计费,实际成本随 reasoning_effort 设置上升。
Vals AI 的数据为这一定价策略提供了更具体的商业叙事:在医疗、税务、法律等高价值专业场景中,Muse Spark 1.1 的表现与 Fable 5 相当甚至更优,但价格只有后者的不到十分之一(Fable 5 定价为每百万输入 10 美元 / 输出 50 美元)。对于需要批量处理专业文档的企业客户而言,"专业能力相当、成本差一个数量级"的组合有明确的采购吸引力。
接下来要看全球开放节奏与编码差距的收敛速度
公测目前仅限美国开发者,全球可用时间表未公布。对于非美国团队,Muse Spark 1.1 暂时只是一个待评估的选项,而非可落地的替代。编程方向的差距是 Meta 自己承认的弱项,官方称更强的编码模型已在训练中,但未给出版本号或时间节点。如果下一次更新仍无法在 SWE-Bench Pro 和 DeepSWE 上接近 Opus 4.8,开发者社区会把 Muse Spark 定位为"工具调用和专业领域专精模型"而非"全栈替代"。此外,Meta 是否会如早期暗示的那样最终开源 Muse Spark 的旧版本,将直接影响 Llama 生态开发者的去留决策。
 AI 速览