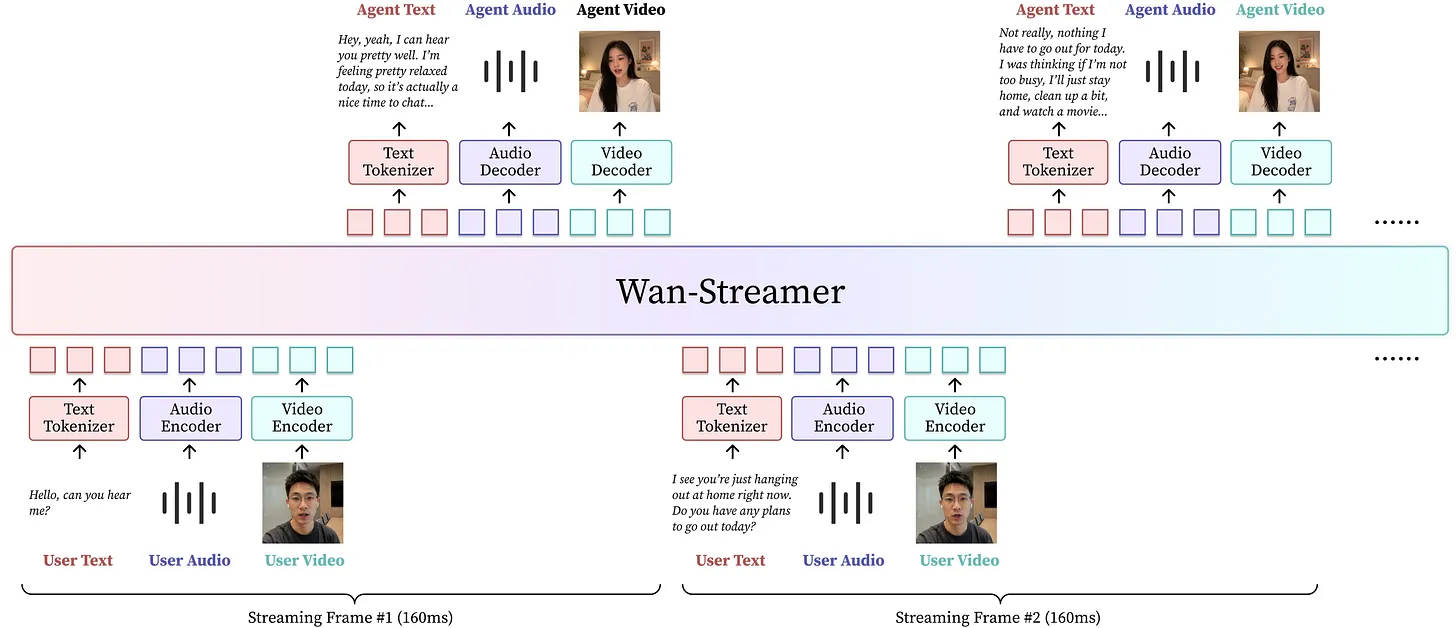
- Wan-Streamer 是阿里巴巴通义实验室推出的端到端原生流式全模态 Transformer,一个模型同时处理文本、音频和视频的实时理解与生成
- v0.2 将输出分辨率从 192×336 提升至 640×368(25 FPS),模型侧信号到信号延迟保持约 200ms,总端到端延迟(含网络)约 550ms
- 采用 Thinker-Performer 分离架构:Thinker 单 GPU 处理延迟敏感路径(感知、推理、解码),Performer 多 GPU 通过 Ulysses 上下文并行进行视频生成
- 突破近景头部特写限制,支持场景化中景对话——面部表情、目光、手势和场景上下文在实时对话中保持清晰稳定
- 不绑定固定虚拟形象骨架,自然语言可描述任意角色(真人、宠物、动漫人物等),即时在对话中生成对应视频
一句话说清楚:这篇论文在解决什么问题
实时视频对话——一个模型端到端地听、看、理解用户,并以同步的语音和视频做出回应——是 AI 交互的终极目标之一。但过去业界对这个问题能做成什么水平,大家心里没底。
直到 2026 年 6 月 Wan-Streamer 首次亮相。在此之前,实时视频对话的公开解决方案大多走的是级联路线:语音识别 + NLP 理解 + 语音克隆 + 预渲染视频拼接,每增加一个环节就增加一段不可控的延迟。结果是交互体验要么延迟到秒级,要么视觉真实度打折扣。通义实验室这次做的,就是把所有模态统一进一个原生流式 Transformer,让模型自己能听、能看、能想、能说视频,全程不走拼接。
v0.2 是这个方向的一次关键升级,回答了一个原先很多人持怀疑态度的问题:能不能在提升视觉质量的同时,不增加交互延迟?
核心方法:它是怎么解决的
Wan-Streamer 的技术核心是一套名为 Thinker-Performer 的分离架构。可以把 Thinker 和 Performer 理解为一对默契的搭档:一个负责快速反应,一个负责精细干活。
Thinker——延迟敏感的指挥层。它运行在单 GPU 上,承担感知(从用户的语音和摄像头画面中提取信息)、推理(理解上下文和意图)、解码(决定下一段回复说什么、做什么表情)的整条延迟关键路径。Thinker 的工作模式是流式的,每次只做少量的语言/状态 Transformer 前向推理,构建出下一段视频生成的缓存,然后立刻传给 Performer。因为计算量小,它跑得快——这是模型侧 200ms 延迟的基础。
Performer——计算密集的执行层。它跑在多 GPU 上,通过 Ulysses 风格的上下文并行来处理最重的视频生成任务。具体来说,v0.2 的长高分辨率视频潜变量序列被切分到多个 Performer 分片上,每个分片只负责一个片段,通过 Ulysses 通信合并去噪结果。而音频潜变量序列因为数据量小得多(同时长下音频的帧数远少于视频),不做序列切分,整条生成。关键设计是 Thinker 的输出只以 K/V 的形式注入 Performer——不传递完整的语言序列到 performer 组内部,从而让通信开销最小化。
这个分离设计的巧妙之处在于:Thinker 和 Performer 之间形成了一个紧凑的计算边界。增加视觉分辨率时,只需要扩展 Performer 组的 GPU 数量和上下文并行度,Thinker 路径完全不受影响。这就是 v0.2 能实现「画质提升不牺牲延迟」的根本原因。
成绩单与对比
Wan-Streamer v0.2 在两个关键维度上拿出了实打实的进展。
分辨率提升,延迟不变。这是 v0.2 最直观的升级点。输出从 192×336(约 6.5 万像素)提升到 640×368(约 23.5 万像素),像素量约 3.6 倍。作为对比,传统级联方案在同等分辨率提升下通常需要增加 2-3 倍 GPU 算力并引入额外 500-1000ms 延迟。Wan-Streamer 通过 Thinker-Performer 分离 + Ulysses 上下文并行,将增加的算力全部投入 performer 组,Thinker 侧的延迟路径不受影响——模型侧延迟仍然锁定在约 200ms,总交互延迟(含网络)约 550ms。
从近景到中景的跨越。v0.1 的表现围绕近景头部特写展开,适合一对一视频聊天场景。v0.2 则进一步支持了场景化的中景对话——在实时对话中,AI 角色可以有自然的目光追随、手势配合和身体转向。社区评测中多位观察者特别提到,这种「有场景感的中景交互」应用到游戏 NPC、虚拟伴侣或远程协作场景时,体验质变显著。有用户直接将 Wan-Streamer 的延迟表现与 OpenAI GPT-Live 的纯音频全双工模式对比,认为 Wan-Streamer 的音视频同步已经走在了前面。
灵活性无虚拟形象绑定。与需要预训练虚拟人骨架的方案不同,Wan-Streamer 不绑定任何固定的形象骨架。用户用自然语言描述角色特征("一个穿着实验室白大褂的猫娘"、"一个五十年代风格的卡通侦探"),模型即席生成对应的面部特征、语音音色和动态表现,而不需要重新训练或更换模型。这对内容创作者、游戏开发者、教育内容和虚拟角色运营来说,意味着极大的场景覆盖弹性。
意义与局限
为什么重要。Wan-Streamer 是业界第一个公开发表、可验证的端到端实时全双工视频对话模型,其 Thinker-Performer 架构在设计与实现上都有原创性。它展示了一条清晰的路径:不依赖级联拼装、不依赖固定虚拟形象、不依赖高算力全 GPU 跑推理,也能做到 550ms 级别的端到端实时交互。对于 AI 陪伴、虚拟角色、在线教育、远程协作等行业,这意味着产品形态的想象空间被打开了一大块——不是未来,是现在就能看到 demo 的产品级研究。
没解决什么。首先,v0.2 的输出分辨率 640×368 在手机和笔记本电脑屏幕上体验很好,但投影到大屏或剪辑到专业影片中仍有不足。这是一个明确的权衡——分辨率提升是以更多 Performer GPU 为代价的,不是免费的。其次,当前仍以研究 demo 和官网体验为主,尚未开放大规模 API 或消费级独立应用,部署成本(单 Thinker GPU + 多 Performer GPU)可以推算出来不会低。第三,社区在冲击声中也有明确的伦理担忧——实时视频生成的真实度越高,越容易被用于深度伪造、情感操控和社交诈骗,这在「we are cooked」类评论中反复出现。论文和团队目前没有公开讨论模型的防护机制或水印策略。
作者、代码与资源
Wan-Streamer 由阿里巴巴通义实验室(Alibaba Tongyi Lab)研究团队完成,论文作者包括黄亮华、吴志凡、时宇鹏等在内的二十余位研究人员。该团队曾在 Wan2.x 系列模型上积累了大量多模态视频理解与生成经验。
关键资源:
通义实验室明确表示这是一项持续进行的研究,后续将继续发布 Wan-Streamer 的更新版本。对实时多模态交互方向感兴趣的开发者和研究者,建议关注官网和 arXiv 上的后续提交。
 AI 速览