7月13日消息,微信 AI 团队(WeLM)近日发布论文"Hidden Decoding at Scale"并在官方博客详解方法,提出一种在不增加 Transformer 层数或宽度的前提下提升大模型能力的扩展方式。核心思路是将每个 Token 扩展为多条隐藏流(hidden stream),为每个 Token 在单次前向传播中分配更多计算量。团队在 80B 和 617B MoE 两个规模上训练了 HD4 版本(扩展倍率 n=4),在全部 9 项共享基准上超过各自匹配的标准自回归基线,且训练成本接近线性增长而非二次方。这是已公开的首个在 100B 以上 MoE 规模上验证的序列长度扩展方法。需要注意的是,目前的对比实验仅使用了早期 SFT(无 RL),更强基线和 RL 结合后的效果尚未公布。
方法:每个 Token 沿序列维度展开为 n 条流
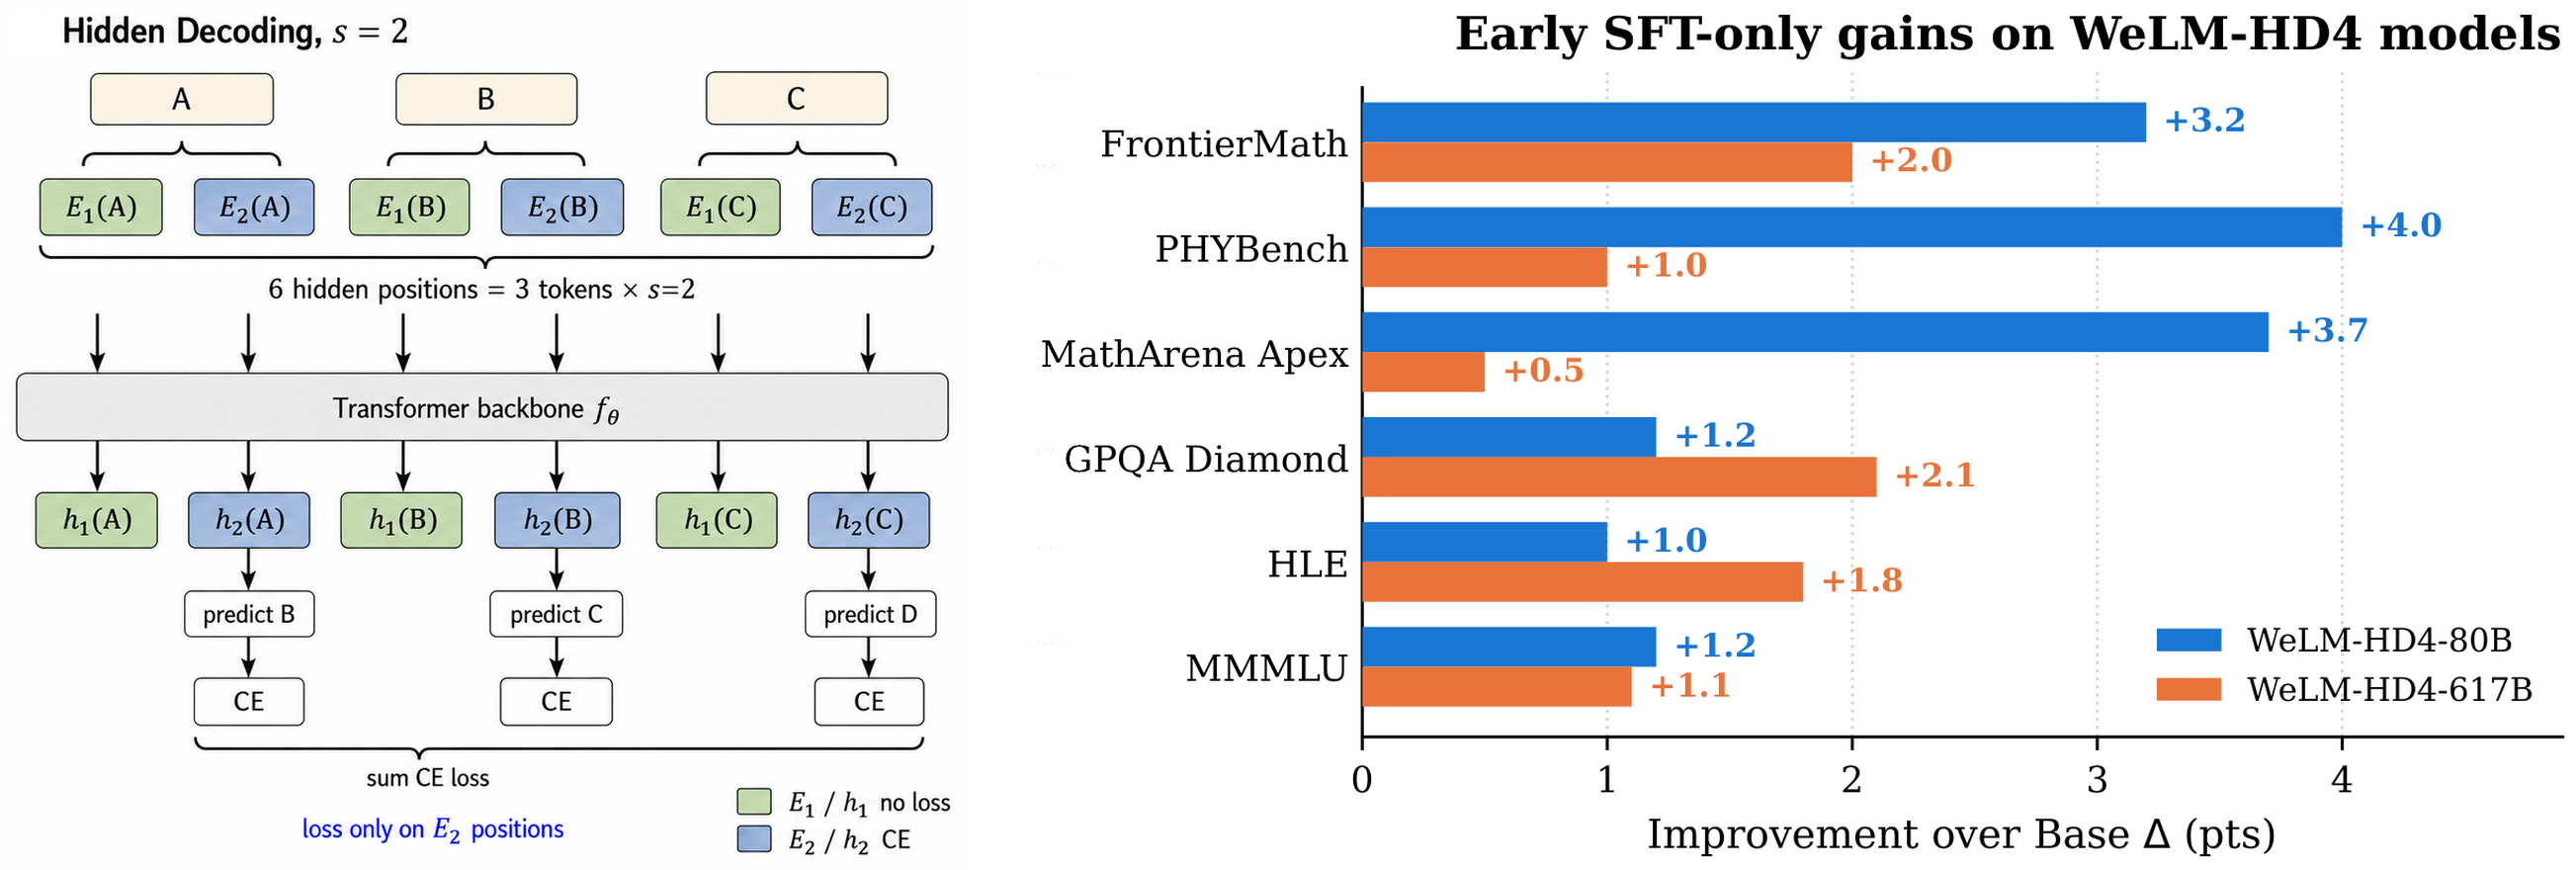
Hidden Decoding 的做法是为模型配备 n 组独立的词表嵌入(Vocab Embedding),将长度为 L 的输入序列扩展为长度 nL 的序列。每个 Token 占据 n 个物理位置,对应 n 条 stream,送入同一个 Transformer 处理。训练时只监督每个 Token 的最后一条 stream 来预测下一个 Token,前 n-1 条 stream 不接收任何直接损失,充当"潜空间中间计算"。
这种设计的关键在于:模型的 Transformer 骨干完全不变——不加层、不加宽、不新增参数(仅增加 n-1 组嵌入表)。额外的计算量来自更长的序列,而非更深的网络。这与深度循环(looped)Transformer 追求的目标相同——让已有骨干做更多思考——但实现方式不同。深度循环需要逐步重复主干、每步等待上一步完成,与大模型训练常用的流水线并行不兼容。Hidden Decoding 将额外计算平铺在序列维度上,n 条 stream 并行处理,天然适配标准训练框架。
Stream-Factorized Attention 把成本从 n² 降到接近 n
将序列长度扩展 n 倍后,标准全注意力的成本会按 n² 膨胀。团队提出的 Stream-Factorized Attention 解决了这个问题:绝大多数层只在同一条 stream 内做注意力(intra-stream),仅少数层启用跨 stream 的混合注意力(cross-stream)。在 21B MoE 的消融实验中,27 层中仅 4 层甚至 1 层使用 full cross-stream 注意力,就能恢复全部层跨 stream 时的大部分准确率收益。
实测训练时间证实了成本可控:4 倍扩展在 80B 上的单 batch 训练时间为基线的 5.1 倍,在 617B 上为 4.4 倍,接近 4 倍的线性参考,远低于 16 倍的稠密注意力开销。更关键的是,HD4 不需要从零训练——它在已有的自回归基座 checkpoint 上做增量续训。HD4 阶段的训练 Token 预算为 80B 模型 1.07T(对比完整基座的 20.39T)、617B 模型 0.90T(对比 17.06T),成本差距超过一个数量级。
617B MoE 上 9 项基准全面提升,5 项超过 Kimi K2.6
在完全对齐的对照实验中——除 Hidden Decoding 外一切相同,相同的早期 SFT 后训练配方(无 RL)——WeLM-HD4 在两个规模上均全面超过对应基线。
最大的收益出现在困难的数学与科学任务上。80B 规模,SciCode 从 45.8 升至 50.0(+4.2),PHYBench 从 69.8 升至 73.8(+4.0),FrontierMath 从 45.8 升至 49.0(+3.2)。617B 规模,GPQA Diamond 从 89.1 升至 91.2(+2.1),HLE 从 33.6 升至 35.4(+1.8)。
团队同时列出了 Kimi K2.6(1T 总参、32B 激活)在相同测试设置下的结果作为前沿模型参照。WeLM-HD4-617B(23B 激活)在 GPQA Diamond、PHYBench、MathArena Apex、HMMT、SciCode 五项上超过 Kimi K2.6。考虑到 WeLM-HD4-617B 的激活参数量不到 Kimi K2.6 的四分之三,且仅使用早期 SFT 后训练,这一对比值得关注,但也意味着后续加入 RL 后的空间可能更大。
中间流在做什么:探针实验给出可解释性证据
论文还通过探针实验回答了一个关键问题:那些不接收直接损失的中间 stream 究竟在做什么?在 Qwen3-8B-Base 上的 8 倍扩展实验中,团队发现了两个一致的结论。
同一 Token 的各 stream 在 Transformer 中间层显著分化(余弦相似度从 0.987 降至 0.637 后部分回升至 0.783),说明中间流形成了与最终流不同的内部表征。同时,最终流对中间流分配了可观的注意力权重(对首条流 E0 的注意力峰值达 0.52),构成了从中间流到预测流的读取通路。在词表空间上,中间流的 top-1 Token 与最终流不同的比例最高约 63%,且 probe 熵普遍高于最终流——中间流在最终预测收敛前保留了更宽的候选分布。这些证据说明中间 stream 确实在执行有意义的中间计算,而非简单的冗余。
真正的意义在于扩展路径的多样化
过去几年,大模型的 scaling 主要沿两个维度推进:训练时扩参数(更大的模型)和推理时扩计算(更长的思维链、更多的采样)。Hidden Decoding 提出的是第三条路径——训练时扩展每个 Token 的内部计算量,不改变模型骨干,通过继续预训练在已有 checkpoint 上叠加。
这条路径的吸引力在于成本结构。从零训练一个更大的模型需要完整的预训练投入;Hidden Decoding 的 HD4 续训只需要基座模型训练 Token 量的约 5%。如果在已有前沿模型上做增量提升是目标,这种方式比重新训练一个更大的模型便宜一个数量级。
但也存在明确的边界。目前的实验均使用早期 SFT 后训练、未结合 RL,这意味着公布的基准数字代表的是方法的下限而非上限。团队在博客结尾披露了更强后训练后的自回归基线表现(WeLM-617B 在 FrontierMath 达 56.68、MathArena Apex 达 60.24、Terminal-Bench 2.1 达 74.2),Hidden Decoding 能否在这些更强基线上维持甚至扩大增益,是验证这条路径天花板的关键测试。
下一步看 RL 结合和更强基线上的增益
团队在博客中明确了后续方向:将在更强的自回归基线上进一步验证 Hidden Decoding 的增益,并将其与 RL 充分结合。如果 Hidden Decoding 带来的提升能与 RL 后训练的提升叠加而非相互替代,这条扩展路径的实用价值将更加明确。另一个值得观察的变量是推理端的表现——目前论文给出的吞吐数据显示,小 batch 下 HD4 可以利用闲置算力实现接近基线的解码速度,但大 batch 高并发场景下的吞吐损失仍是实际部署需要考量的因素。WeLM 作为微信 AI 助手"小微"的底层模型,服务于 14.32 亿月活用户,部署成本敏感度极高,Hidden Decoding 能否在这个量级上落地是一个独立于学术基准的工程验证。
 AI 速览