7月15日消息,阿里巴巴正式发布实时语音交互对话模型 Qwen-Audio-3.0-Realtime,围绕语音推理、Agent 工具调用、共情对话和双工交互四个方向升级,提供推理更强的 Plus 版本与响应更快的 Flash 版本,面向智能客服、教育培训、娱乐互动与情感陪伴等场景。该模型由此前的 Preview 版 Fun-Realtime-AudioChat 升级更名而来,目前已在阿里云百炼上线,可通过 WebSocket 协议调用。需要说明的是,官方援引的 Artificial Analysis 榜单成绩,均基于今年 5 月提交的 Preview 版本,而非此次上线的正式版本,两者是否一致尚无第三方复现结果。
双版本上线,主打"边说边听"的双工节奏
Qwen-Audio-3.0-Realtime 分为 qwen-audio-3.0-realtime-plus 与 qwen-audio-3.0-realtime-flash 两个模型,均通过 WebSocket 接入,支持 Function Calling。按阿里云百炼帮助中心的模型更新记录,两个模型在中国内地的上架时间为 7 月 14 日,官方对外发布日期为 7 月 15 日。
这次升级的核心之一是双工交互。传统语音助手多是"一问一答"的对讲机模式,Qwen-Audio-3.0-Realtime 内置了一个"多模态感知的双工控制"子模型,通过同时分析音频信号、语义内容与说话人声纹特征,判断何时应当回应、何时应当继续倾听。官方给出的场景包括:在餐厅、开放工区等嘈杂环境中不被背景噪声误打断,在多人讨论中锁定主对话对象、忽略旁听者,以及在多说话人之间根据上下文自然切换。面向开发者,Realtime-API 中预留了 audio_prompt 字段,可传入特定用户提前录制的音频,让模型在双工对话中实现声纹级锁定。
共情表达与 Agent 调用同步升级,底座用蒸馏兼顾"快"与"聪明"
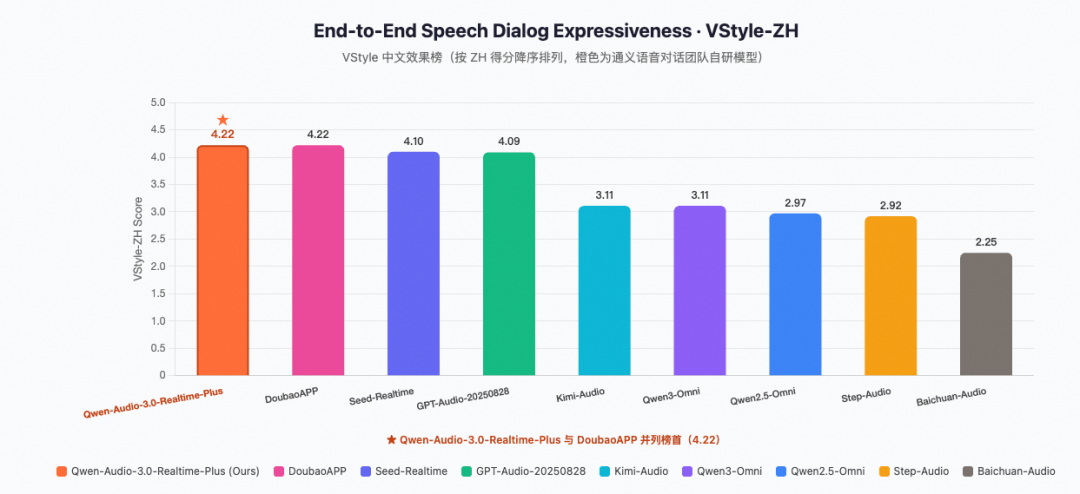
在语音表达上,模型可根据对话语境调整语气、节奏、音调和情感,并识别与生成笑声、叹息、犹豫等副语言信息,同时提供音色克隆能力用于自定义音色。官方称其在 S2S 语音指令遵循公开 Benchmark VStyle 上取得 SOTA。
Agent 能力方面,模型无需显式指令即可自主判断何时调用外部工具,调用结果会自动融入后续对话记忆,支持多轮追问接续使用。该能力基于 FunctionCall 标准协议,可接入 MCP、API 与知识库,官方以路线规划、餐厅推荐、实时资讯与股票查询、日程安排、表格查询等作为示例。为验证复杂业务下的工具调用,阿里在覆盖零售、航空、电信的 TauBench 上做了测试,并将其中的 UserSimulator 改为语音输入。
底座层面,阿里采用 On-Policy Distillation 框架,将文本大模型的推理能力蒸馏至语音模型,并引入多教师蒸馏,分别覆盖口语多轮偏好、通用问答推理、Agentic 工具调用和音频理解四个维度,用以缓解"语音模型智商衰减"的问题。针对日常问答等时延敏感场景,模型可直接生成回复,实现毫秒级响应。
评测成绩亮眼,但口语提示词下有可见掉分
按官方披露,Preview 版本在 Artificial Analysis 的 Speech Reasoning 子项综合排名第一,在对话动态子项取得 SOTA,官方并称综合表现超越 OpenAI GPT-Realtime-2。这些排名对应的是 5 月提交的 Fun-Realtime-AudioChat,属于官方援引的第三方评测结果,正式版本的对应成绩尚未有独立验证。
正式版本自身给出的两组数据更值得关注实际可用性。在 VoiceBench 语音问答基准上,Plus 版标准提示词得 92.5 分、口语提示词 90.5 分,下降 2.0 分;Flash 版分别为 89.8 分和 87.5 分,下降 2.4 分。在多轮音频对话基准 AudioMultiChallenge 上,Plus 版标准提示词 44.0 分、口语提示词 37.6 分,下降 6.4 分;Flash 版为 43.6 分和 38.1 分,下降 5.5 分。标准提示词与口语提示词之间的差值,反映的是模型从"规整文本指令"迁移到"真实口语表达"时的稳定性,多轮场景下的降幅明显大于单轮问答。
真正的看点是 Preview 成绩能否在正式版复现
这次发布容易被读成"语音模型综合排名超越 OpenAI"的叙事,但需要区分两件事:登顶 Artificial Analysis 的是 5 月提交的 Preview 版本 Fun-Realtime-AudioChat,此次上线的是升级更名后的正式版本。官方并未声明两者成绩等同,正式版本在同一榜单上的表现目前没有第三方复现。把 Preview 版的排名直接等同于正式版能力,是这次信息里最容易误读的地方。
更有参考价值的是官方主动披露的口语提示词掉分。多数语音模型的对外成绩用的是规整提示词,而真实用户是口语化、带犹豫和省略的表达。AudioMultiChallenge 多轮场景下 5 到 6 分的降幅,说明"实验室分数"和"真实对话体验"之间仍有距离。阿里把这组对比一并公布,反而是这次材料里可信度较高的部分。
接下来要看正式版的第三方复测和真实负载表现
后续最值得观察的有两点。一是正式版本能否在 Artificial Analysis、VoiceBench 等公开榜单上由第三方复测出与 Preview 版相当的成绩,这决定了"综合排名第一"是一次性提交结果还是稳定能力。二是双工控制和声纹级抗干扰在真实开放场景下的实际表现,餐厅、多人会议、客服呼叫中心等环境的打断检测准确率和响应时延,需要开发者接入后的实测来验证,官方给出的场景描述目前仍是厂商自述。对开发者而言,Plus 与 Flash 之间的时延、成本和推理深度取舍,也要等实际调用数据出来才能判断如何选型。
 AI 速览