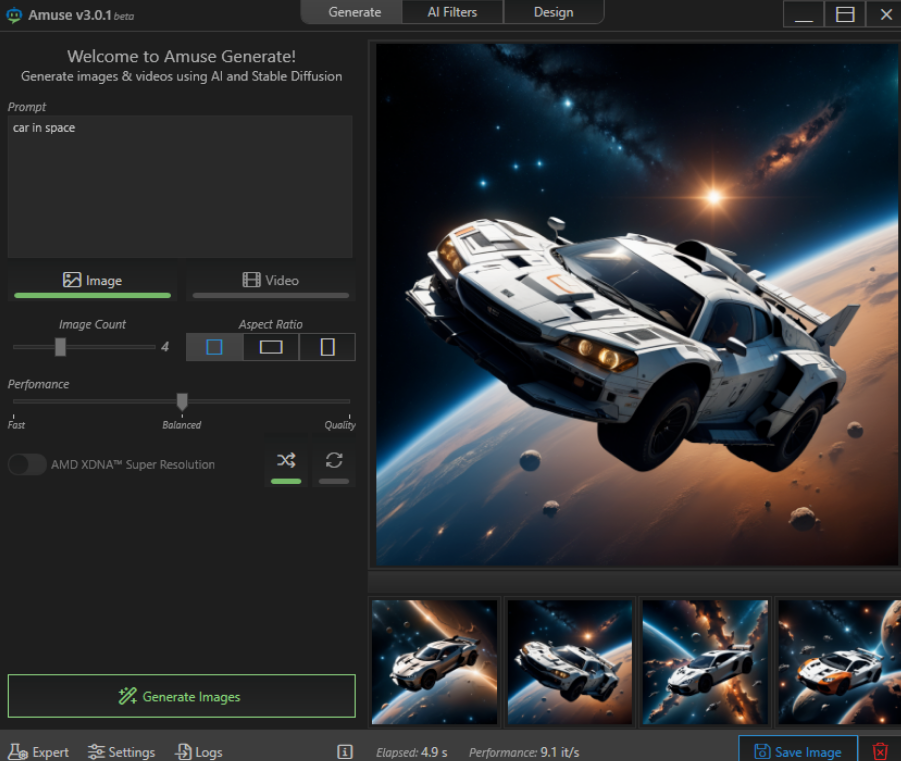
Amuse AI是由TensorStack联合AMD打造的一款免费、开源、本地运行的AI创作桌面软件,基于Stable Diffusion等100余种主流模型,支持文生图、图生图、文生视频、图生视频、语音生成与识别等全场景AI创作功能。所有计算均在本地完成,无需联网、无需订阅、数据完全隐私。截至2026年7月,Amuse已迭代至3.4.0版本,成为AMD显卡用户最常用的免费AI创作工具之一。本文将从功能、使用方法、硬件要求、优缺点等角度进行全面解析。
Amuse AI是什么
Amuse AI是由AI基础设施公司TensorStack与AMD联合开发的本地AI创作桌面客户端,专为Windows平台设计。它本质上是一个"本地AI工作室"——将Stable Diffusion、FLUX、CogVideoX等100余种主流AI模型集成到一个图形化界面中,让用户无需命令行操作、无需云端调用即可在自己的电脑上完成AI绘画、视频生成、语音合成等创作任务。
Amuse AI采用Apache 2.0开源协议,源代码托管在GitHub(TensorStack-AI/AmuseAI),所有AI推理运算均在用户本地设备上完成,生成的图像和视频不会上传至任何服务器,不包含任何遥测或数据收集代码。
技术架构上,Amuse AI基于ONNX Runtime和DirectML实现跨GPU品牌的兼容:
- AMD显卡用户:通过DirectML调用Radeon GPU和Ryzen AI NPU,借助AMD XDNA架构实现超分辨率无损放大等独占功能。
- NVIDIA显卡用户:通过CUDA加速(需CUDA≥12.8),支持RTX系列显卡的高效推理。
- 模型管理:内置模型管理器,支持从HuggingFace、Civitai等平台一键下载和切换Checkpoint、LoRA、VAE等模型文件。
Amuse AI的核心定位是"替代云端AI服务的本地方案"——相较于Midjourney、DALL·E等需要付费订阅且依赖网络的云端工具,Amuse AI完全免费、完全离线、完全隐私,特别适合对数据安全有要求或网络条件受限的创作者。
Amuse AI的主要功能
Amuse AI集成了图像生成、视频生成、音频处理、编辑工具四大功能模块,覆盖从创意构思到成品输出的完整工作流。
AI图像生成
支持多种图像生成模式,覆盖不同创作场景:
- 文生图(Text-to-Image):输入文字描述即可生成高质量图像,支持中文和英文提示词。在EZ简易模式下可直接输入中文提示词快速出图;在Expert专家模式下可精细调整CFG Scale、采样器、推理步数等参数。
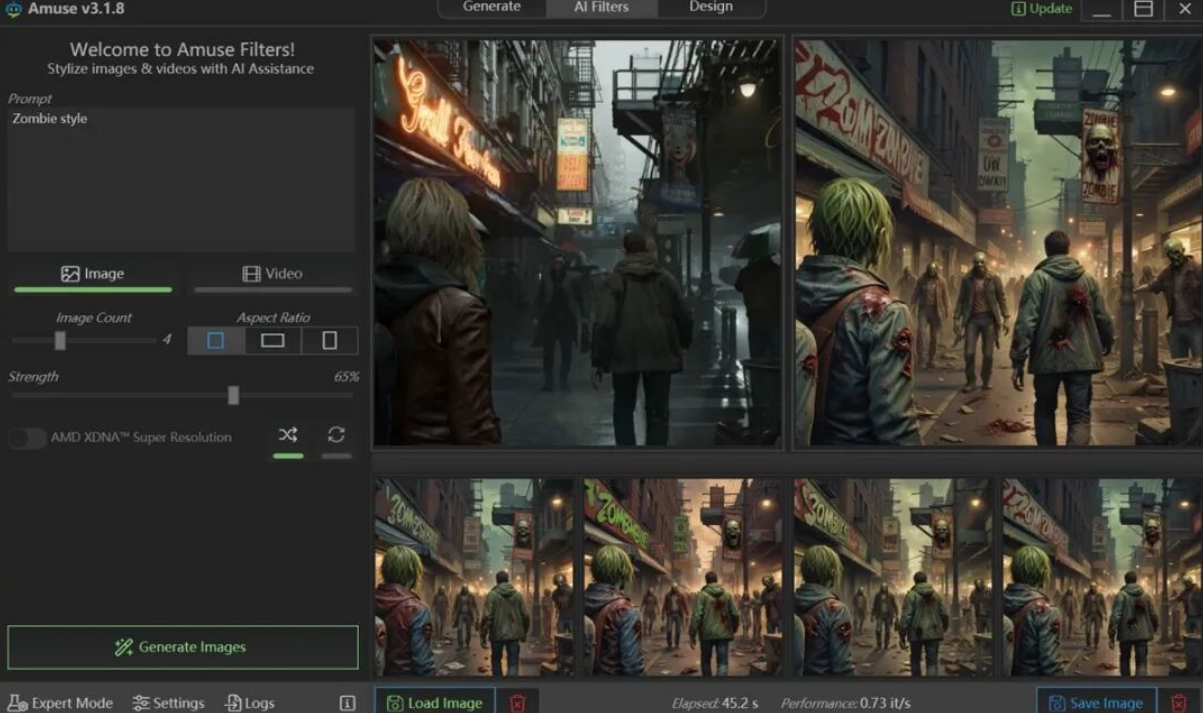
- 图生图(Image-to-Image):上传一张参考图并附加文字描述,AI在保留原图结构的基础上进行风格转换或内容增强,支持调整重绘强度。
- 草图生图(Paint-to-Image):在画布上手绘粗糙草图,AI自动将其细化为精美图像,特别适合概念设计和快速原型可视化。
- 局部重绘(Inpainting):用蒙版标记图像中需要修改的区域,AI仅重绘选中部分,可用于去除多余物体、修复瑕疵或替换局部元素。
- 图像扩图(Outpainting):在图像边缘扩展画面,AI自动补全背景内容。
AI视频生成
Amuse AI集成了多种视频生成和处理模型:
- 文生视频(Text-to-Video):通过CogVideoX等视频生成模型,输入文字描述生成短视频片段。
- 图生视频(Image-to-Video):将静态图片转化为动态视频,适合老照片动态修复、静态插画动起来等场景。
- 视频转视频(Video-to-Video):对现有视频进行AI风格重绘,可将实拍视频转换为动画或油画风格。
- 视频补帧(Frame Interpolation):在两帧之间智能插入过渡帧,实现慢动作效果或提升视频流畅度。
- 视频超分辨率放大(Video Upscaler):利用AI算法将低分辨率视频放大至高分辨率,减少模糊和噪点。
AI音频处理
- 语音生成(Text-to-Speech):将文字转换为自然语音,支持多语种。
- 语音识别(Speech-to-Text):集成OpenAI Whisper模型,支持将音频文件转写为文字。
辅助与编辑工具
- ControlNet全套:支持OpenPose(姿态控制)、Canny(边缘检测)、线稿生图等多种ControlNet模式,精准控制生成结果的构图和姿态。
- 自定义AI滤镜:用户可以创建和保存自定义滤镜,批量对图像应用一致的风格效果。
- AMD XDNA超分辨率:AMD硬件独占功能,可将512×512的图像通过AI算法2倍无损放大至1024×1024,保留细节清晰度。
- REST API接口:支持通过API进行程序化图像生成,可集成到自动化工作流或第三方应用中,支持任务队列、进度查询和结果下载。
- 素材图库管理:内置作品相册,分类保存生成图像和工程参数,方便回溯和管理创作历史。
Amuse AI怎么安装和使用
下载与安装
访问Amuse AI官方网站(amuse-ai.com)或GitHub Releases页面,下载最新版本的安装包(约250-800MB,因版本而异)。Amuse提供两种安装方式:
- 一键安装包(推荐):下载后解压,双击Amuse.exe即可运行。安装包已内置隔离的Python环境和基础依赖,无需手动配置。
- 从源码构建:适合开发者。需安装.NET 9.0 SDK,通过dotnet build编译。GitHub仓库也提供DirectML专用分支,去除额外依赖。
首次启动与模型下载
首次启动后,建议按以下步骤完成初始化:
- 进入顶部导航栏的Model Manager(模型管理器),切换到"Stable Diffusion"子标签。
- 选择一个基础模型(如Stable Diffusion XL或FLUX.1),点击Download下载。模型文件通常较大(数GB至十几GB),下载时间取决于网络速度。
- 如需视频生成功能,同样在模型管理器中下载CogVideoX等视频模型。
- 模型下载完成后,切换回Image Generation页面,在模型选择下拉框中选中已下载的模型,点击Load加载。
EZ简易模式(新手推荐)
适用于初学者和快速出图场景:
- 无需配置模型环境、采样器、CFG等参数,系统自动选择最优默认设置。
Expert专家模式(进阶用户)
解锁完整控制参数,适合对生成质量有精细要求的用户:
- 100+模型自由切换,支持加载自定义LoRA和VAE。
- 可调整CFG Scale(提示词引导强度)、采样步数、采样器类型(DPM++ 2M Karras、Euler等)、随机种子等参数。
- 支持Xformers优化推理,在开启后VRAM占用可降低约30%。
REST API 使用(开发者)
Amuse AI内置可选的REST API服务,启动后默认监听5000端口,支持文本生图和图像超分辨率等任务的程序化调用。API支持任务队列、进度轮询和结果下载,适合集成到自动化创作管线中。
Amuse AI的系统要求与硬件推荐
由于所有AI推理在本地完成,硬件配置直接影响生成速度和使用体验。以下是官方推荐的配置参考:
| | | |
|---|
| | | |
| | Ryzen AI 300系列或Ryzen 8040系列 | |
| | | |
| | | |
| | | |
| | | |
| | | |
需要说明的是,以上为官方推荐配置。在实际使用中,即使配置低于最低要求,部分轻量模型(如Stable Diffusion 1.5)仍可运行,但生成速度会显著降低。FLUX.1模型因参数量巨大,要求24GB显存,属于最高配置门槛。对于16GB显存的显卡用户,可选用SDXL、SD 3.5等模型获得良好体验。
Amuse AI的优缺点和注意事项
核心优势
- 完全免费:无订阅费用、无隐藏收费、无每日生成次数限制。本地生成仅消耗电费和硬件折旧,长期使用成本远低于Midjourney($10-60/月)或Adobe Firefly等订阅制云端工具。
- 数据完全隐私:所有计算在本地完成,提示词和生成内容不上传任何服务器,不包含遥测代码。适合处理商业敏感项目或隐私要求高的创作内容。
- 离线可用:首次下载模型后,即使没有互联网连接也能正常创作,不受网络波动或服务宕机影响。
- AMD深度优化:针对AMD Ryzen AI处理器和Radeon显卡独占XDNA超分辨率功能,AMD硬件用户在其他AI绘画工具中难以获得同等的本地加速体验。
- 模型生态丰富:内置100+模型,支持从HuggingFace和Civitai导入社区Checkpoint、LoRA,模型选择范围远超单一模型的云端工具。
- 开源可控:Apache 2.0协议开源,开发者可审查代码、定制功能,无供应商锁定风险。
主要局限
- 硬件门槛高:需要独立显卡才能获得可用的生成速度。FLUX.1等高端模型要求24GB显存,远超普通消费级显卡配置。集成显卡或老旧设备用户体验较差。
- 仅支持Windows:目前无macOS或Linux官方版本,Mac用户需借助虚拟机或其他方案。Apple Silicon版本据称在开发中,但尚未正式发布。
- 初次配置复杂:软件界面全英文,模型下载需访问HuggingFace等境外站点(可能需要代理),首次安装下载的模型文件总量可能超过20GB。
- 更新频繁且体积大:版本迭代活跃,每次更新可能需要下载数百MB安装包,存储空间占用持续增长。
- NVIDIA优化不如原生CUDA工具:虽然支持NVIDIA显卡,但相较于ComfyUI、Automatic1111等原生CUDA工具,Amuse在NVIDIA硬件上的推理效率略逊一筹。
使用注意事项
- 初次使用需要耐心:首次启动后需逐个下载所需模型,建议在网络条件好的时段进行,预留30分钟以上的初始化时间。
- NVIDIA用户注意CUDA版本:如果使用NVIDIA显卡,需确保系统已安装CUDA 12.8或更高版本。可通过NVIDIA官网下载最新CUDA Toolkit。
- AMD用户注意NPU驱动:使用Ryzen 8040系列处理器的用户需安装最新的OEM MCDM和NPU驱动程序,否则NPU加速功能无法启用。
- 磁盘空间管理:建议为Amuse分配至少50GB的专用存储空间,定期清理不用的模型文件可释放空间。
- 内容合规:Amuse默认启用内容审核(Content Moderation),可在设置中关闭。用户生成内容需遵守当地法律法规,不得用于生成违法或侵权内容。
- 版权说明:Amuse本身为Apache 2.0开源协议,但用户加载的第三方模型(如从Civitai下载的LoRA)可能附带各自的许可条款,商用前需确认模型授权范围。
- 避免高峰期使用:虽然推理在本地进行,但模型下载依赖境外服务器,建议避开网络高峰期下载大文件。
本文信息基于Amuse AI官方文档、GitHub仓库(TensorStack-AI/AmuseAI)及多方评测整理,数据截至2026年7月。软件功能和硬件要求可能随版本更新而变化,具体以官网(amuse-ai.com)最新信息为准。
 AI 速览