在 2026 世界人工智能大会上,由中科院自动化所牵头技术攻关、中科闻歌负责产业化落地的磐石 2.0 正式发布,推出国内首个面向科学理解、预测与生成的多模态统一推理模型 S1-Omni,以及贯穿科研全流程的 ScienceOne 一体化平台。
第三方盲测结果显示,该体系在真实科研任务中的表现超越 GPT-5.5、Claude Science 等国际主流产品,标志着 AI for Science 正式从单点工具迈向系统级科学智能新阶段。 一、赛道痛点:通用模型难以适配科研精准性需求
当前 AI for Science 领域主要形成三类技术路线,但均存在明显天花板:领域专用模型在蛋白质预测等单任务上做到极致,但能力被严格限定在单一方向;
工具增强型通用模型依赖外部工具链切入科研场景,模型本体缺乏对科学规律的本质理解;
科学语言模型仅停留在符号表征层面,未形成完整推理能力。
三类路线的共同局限,是科学智能始终碎片化分布在独立模型与工具系统中,无法形成统一能力。更深层的矛盾在于,通用大模型基于统计概率的底层逻辑,输出偏向 “近似正确”,无法满足科研领域对精确性、可溯源性、可验证性的核心要求。
科研结论需要完整可追溯的推理链路,错误必须可定位修正,这正是通用模型的天然短板,也是磐石 2.0 重点突破的方向。
二、S1-Omni:三大机制构建统一科学推理能力
S1-Omni 是磐石 2.0 的核心技术底座,通过三大核心机制实现科学多模态统一推理,打造真正 “懂科学” 的模型能力。
一是统一科学数据编码,在保留蛋白质序列、化学 SMILES、材料 CIF、光谱数据等不同模态固有结构与特性的基础上,将其映射到共享科学表征空间,实现跨模态协同建模,而非粗暴抹平领域差异。
二是科学知识对齐训练,将科学规律、实验事实与专家经验融入数据构建、样本校验与训练全流程,让推理基于真实科学证据而非统计语感,大幅提升结论的可解释性。
三是领域定向解码,基于统一推理底座,针对不同任务匹配对应专业解码器,输出性质预测、结构重建、三维生成等符合领域规范的原生结果。
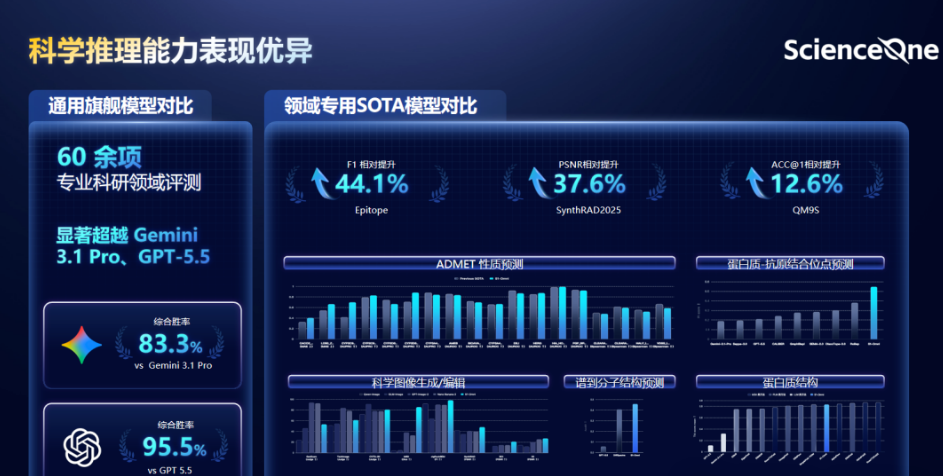
依托百万级高质量多模态推理语料库,模型在 60 余项科学基准任务中表现突出,95.5% 的任务性能超越 GPT-5.5,83.3% 超越 Gemini 3.1 Pro,在药物 ADMET 预测、蛋白质位点识别等任务上达到甚至超过专用模型水平。 三、ScienceOne 平台:打造科研全生命周期操作系统
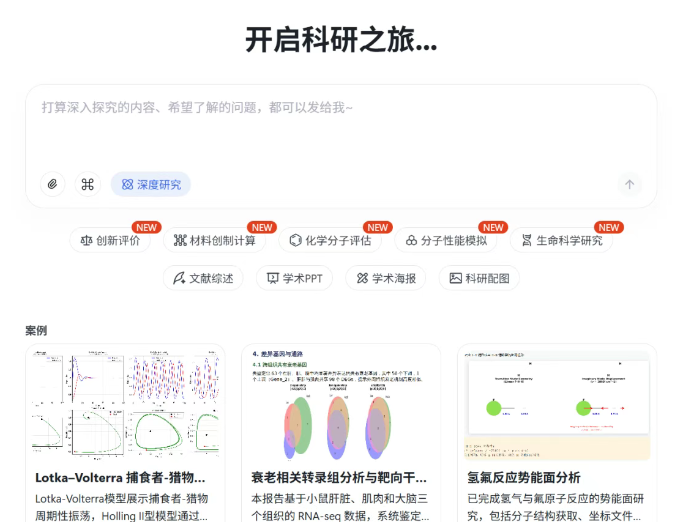
模型能力之外,磐石团队同步推出 ScienceOne 一体化科研平台,将 S1-Omni 的能力深度嵌入真实科研工作流,解决 “模型强、落地难” 的行业痛点。
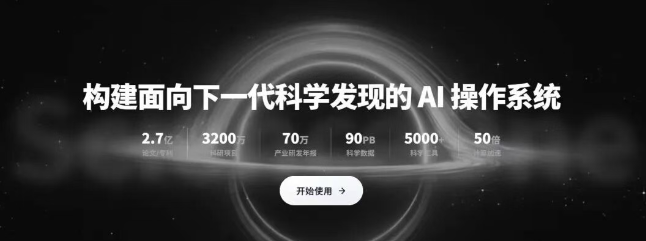
平台向下整合 2.7 亿篇论文专利、3200 万全球科研项目、90PB 大科学装置数据等海量科研资源,向上通过智能体调度各类专业工具与技能,覆盖文献分析、假设提出、方案设计、建模仿真、验证分析、成果表达六大核心科研环节,定位为科研领域的智能操作系统。
科研人员仅需通过自然语言描述需求,平台即可自主调用对应技能完成全链路任务,将研究者从数据清洗、代码调试、资料检索等事务性工作中解放出来,把精力真正聚焦于核心科学问题本身。
四、实测验证:真实科研任务表现领跑国际竞品
第三方盲测结果充分验证了磐石 2.0 的实际落地价值。
在量子信息领域的去极化噪声对 Bell 态纠缠影响研究中,磐石可自主完成电路搭建、噪声仿真、数值演算到可视化报告的全流程,精准输出密度矩阵与纠缠度专业指标,理论严谨性远超停留在概念解释层面的通用模型。
在乳腺癌意义未明变异(VUS)分析任务中,磐石可自动打通多组学数据库,完成变异注释、致病性排序与蛋白结构标注,直接输出可支撑论文与实验设计的科研结论,能力覆盖从数据整理到科学推理的完整闭环,显著领先仅能完成基础数据整理的通用竞品。
整体而言,磐石 2.0 的发布是 AI for Science 领域的重要里程碑。它打破了科学智能碎片化的现状,将懂科学的模型与可落地的系统深度结合,让 AI 从单点辅助工具升级为可全程协作的科研搭档。随着技术持续迭代,这套统一科学智能体系有望大幅降低科研门槛,加速各领域的科学发现进程。
 AI 速览