7月20日消息,字节跳动 Seed 团队发布音频创作模型 Seed Audio 1.0 的完整官方介绍,确认模型已在火山方舟体验中心上线,体验入口为语音模型下的"Doubao-音频生成-1.0"。该模型 6 月 23 日在火山引擎 FORCE 原动力大会上发布,当时已同步开启 API 邀测和个人用户体验额度。本次官方博客的增量在于:首次披露技术路线细节、100ms 精度的时间控制、20+ 语种支持和三组内部评测结果,模型的可用状态也从发布会的邀测口径转为面向创作者的正式上线。
定价方面,火山方舟已公布该模型的 API 价格:按调用后付费刊例价 0.3 元/分钟,预付费资源包折合单价最低 0.24 元/分钟。API 侧,该模型已在火山方舟上线可用,火山引擎官方文档库已公开音频生成的 HTTP 接口文档。尚不能下定论的部分同样明确:所有评测数据均为官方自评,尚无第三方复测。
从发布会亮相到完整能力披露
相比 6 月发布会释放的信息,本次博客补上了几块此前缺失的拼图。技术路线上,Seed Audio 1.0 训练了一个通用声学编码器,将对白、音效、环境声等不同音频要素映射到统一声学表征中联合建模,官方称这是其实现"完整声音场景生成"而非多素材拼接的基础。控制精度上,模型先将创作意图拆解为包含角色、台词、情绪和音效进入时机的结构化时间线,创作者可在 prompt 中指定各声音的时间安排,官方称当前时间控制支持 100ms 间隔精度,这一指标此前未公开。
生成时长上,单次可生成约 2 分钟音频,并可基于参考音频继续延长,官方称延长后仍能保持角色音色与表达方式一致。语言覆盖从发布会未明确的状态更新为 20+ 语种,包括中文、英文、日语、韩语、西班牙语、印尼语、德语、法语、泰语、越南语等,同一音色可跨语种迁移。此外,官方还披露了一项"单音色、多角色"能力,同一音色可通过差异化演绎塑造不同人物。
首次公开的评测数据应该怎么读
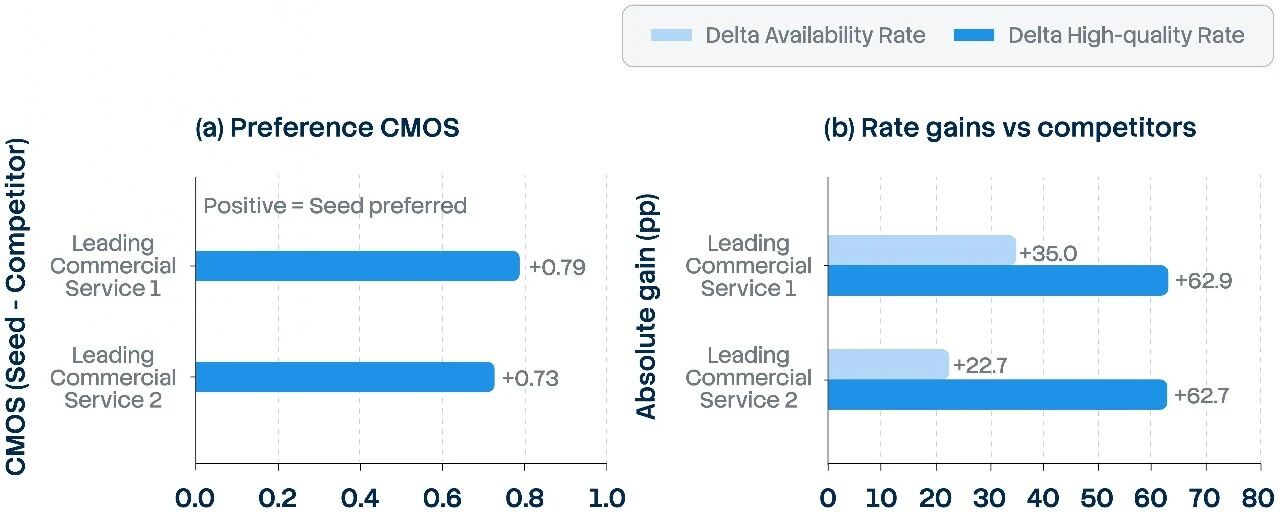
官方这次从三个维度给出了评测结果。文本生成音色能力上,Seed Audio 1.0 在 AB 主观评测中"表现出显著优势",但官方未点名对比模型,也未披露样本量和评测人数。多场景创作能力上,官方按影视、电视节目、短剧、动漫、播客对话、直播带货、网络创作、话剧和语音合成九个场景拆分评测,称多数场景的音频可用率已达 90% 以上,"可用率"的具体判定口径没有说明。多语种能力上,大部分语言的音频自然度 MOS 超过 4 分,复杂音频生成的指令遵循方面,除越南语外其余语言 MOS 均高于 3.5 分。
这三组数据的可信边界是:全部来自官方内部评测,没有第三方复测,也没有公开可复现的评测集。它们可以用来判断官方自测的能力轮廓,不能当作横向对比结论。
此前的三个问号,回应了两个半
ChooseAI 在 6 月 23 日的报道中提出过三个待验证问题,本次披露可以逐一核对进度。关于单次直出的质量上限,官方用多场景可用率做了部分回应,但自评数据无法替代真实工作流检验,这个问题要等用户实测。关于零样本生成的可控性,100ms 时间控制和"单音色、多角色"把可控性从音色层推进到时间轴和演绎层,属于实质性回应,对视频配音、广告片这类对口型、卡节奏的商用场景尤其关键。关于 API 开放和定价,这两个缺口目前都已补上:API 已在火山方舟上线可用,官方文档库公开了音频生成的 HTTP 接口文档;定价则不在博客而在计费文档里。
据火山方舟的模型定价信息,豆包音频生成模型 1.0 按调用后付费刊例价为 0.3 元/分钟,按模型原始输出时长计费,精确至秒折算,倍速不影响计费时长;预付费资源包为创作版四档,从 200 分钟 57 元到 200 万分钟 48 万元,折合单价 0.24 元到 0.27 元/分钟。按后付费价格计算,一条 2 分钟成片级音频的生成成本约 0.6 元,与配音演员、音乐授权加音效库的传统组合成本相比,差距在数量级以上,有声书和播客场景的成本账已经算得过来。计费规则上还有两点值得留意:接口传入参考音频不产生音色费用,注册固定音色则需按音色槽位另行付费。 另据火山引擎豆包语音计费说明(最近更新 7 月 8 日),该模型正式版默认支持 5 并发,增购价格为 300 元/并发/月,这一并发口径进一步说明 API 已经不是邀测状态下的限量试用,而是按正式商用规格在运营。
整体看,这次上线把"单次端到端直出"与"分轨生成再合成"两条路线的争论推入了可实测阶段,这对行业比对参数披露更有意义。而 20+ 语种与 ElevenLabs 的 70+ 语种相比仍有明显差距,生态、API 成熟度和企业合规上的差距也没有因为一次上线而改变。
接下来看真实可用率和产品化落地
短期内的观察点有三处。一是体验中心和 API 开放调用后的第三方实测结果,尤其是官方"多数场景可用率 90% 以上"的口径能否在真实使用中得到验证。二是产品化落地的节奏,定价和 API 都已就位,按 6 月发布时的媒体报道,该模型后续还将接入剪映、即梦、番茄等产品,这条路径的推进速度直接影响它的实际渗透率。三是官方在博客中预告的下一步方向:支持视频参考等更多模态输入、长音频与分轨生成、与可控翻译结合的多语种控制。其中分轨能力值得单独留意,端到端直出与分轨可编辑并不矛盾,如果 Seed Audio 后续同时给出两条路径,专业用户的接受门槛会明显降低。  AI 速览