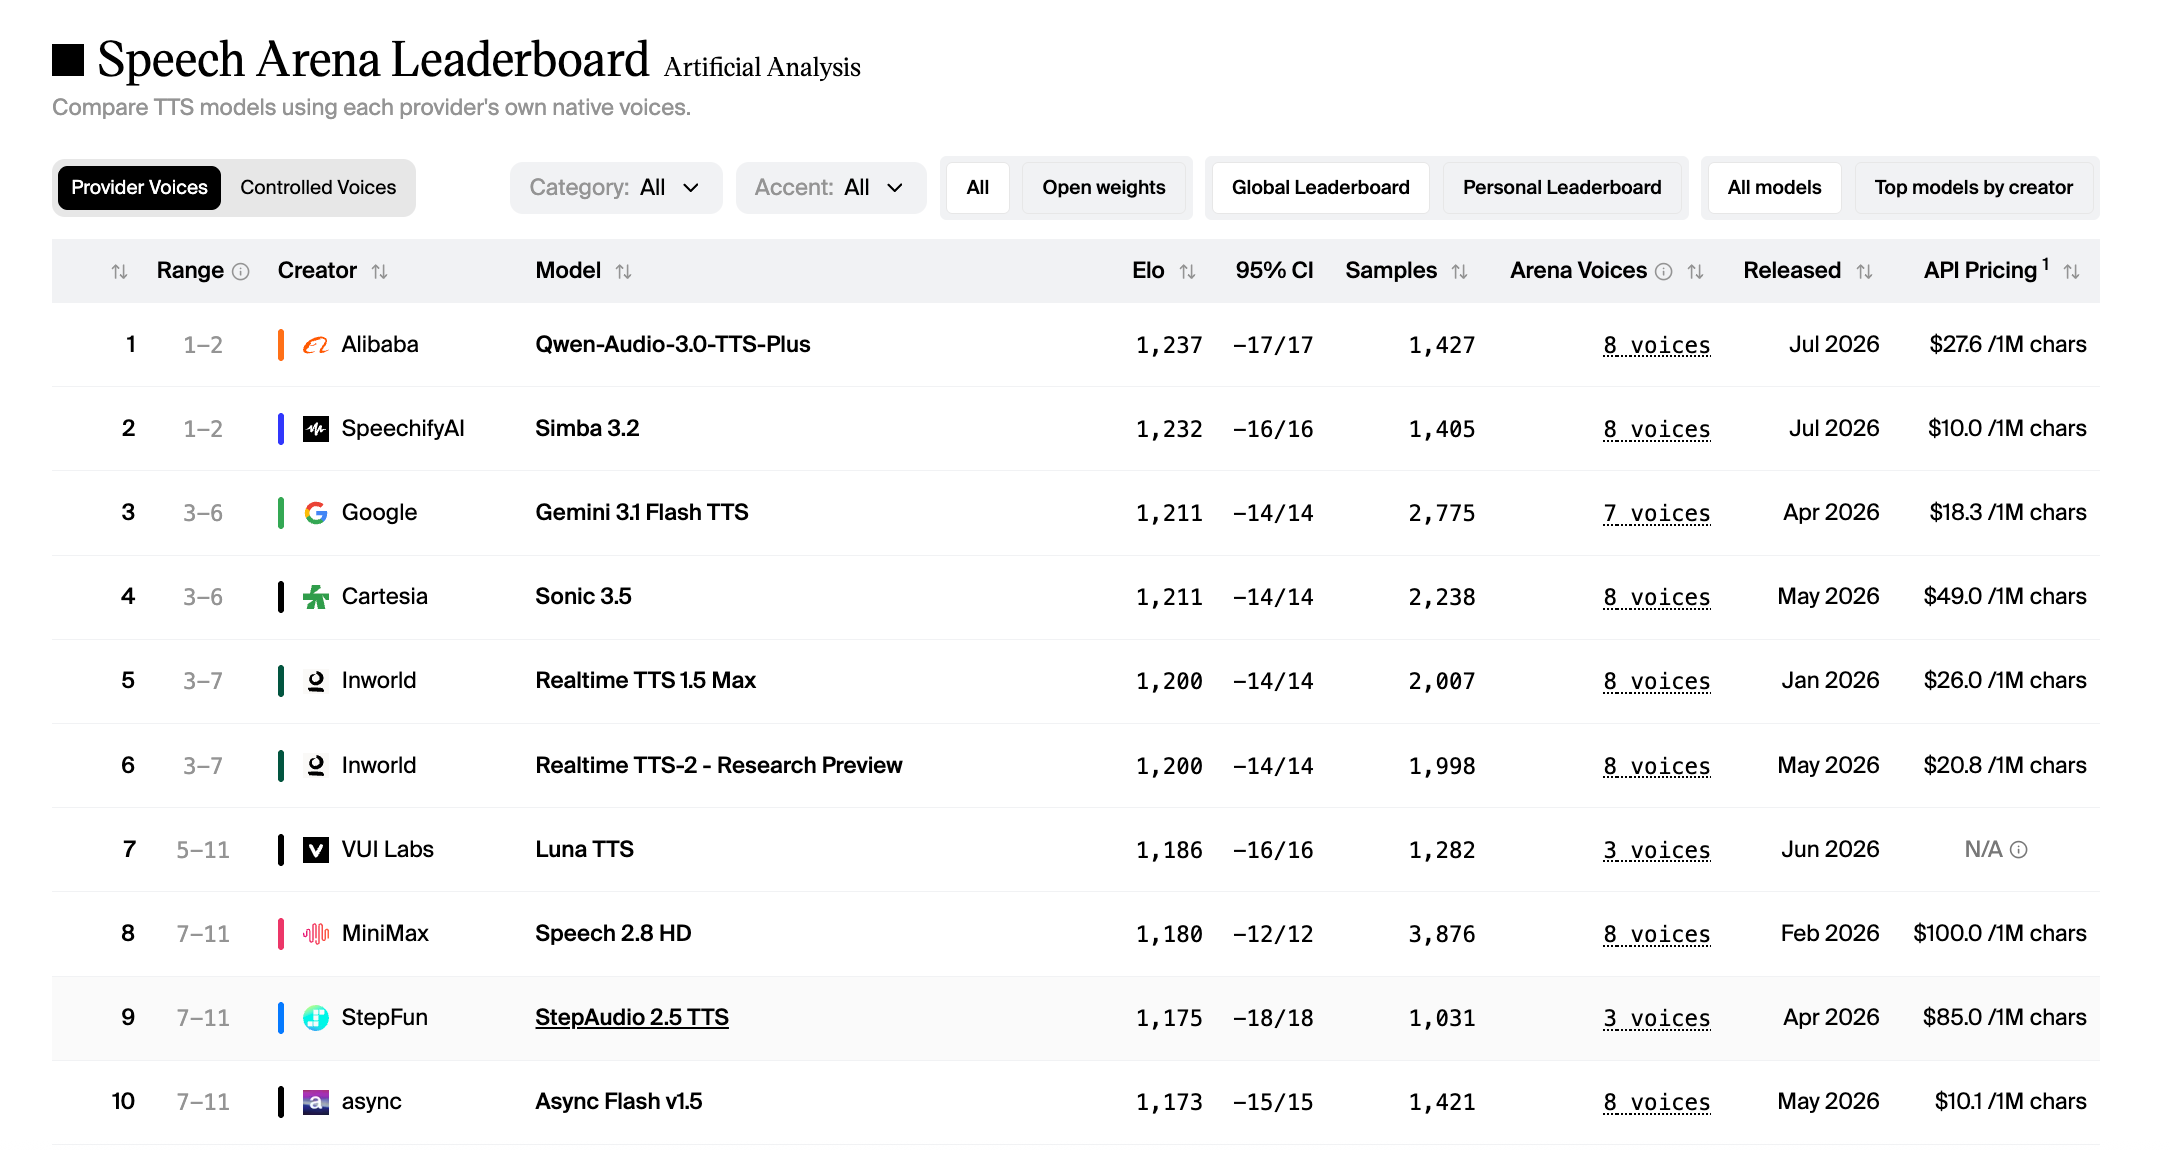
7月20日消息,阿里千问正式发布语音合成大模型 Qwen-Audio-3.0-TTS,包含两个版本:Flash 面向实时交互,首包延迟在 300ms 左右;Plus 面向高质量生成,在自然度和音色还原度上表现更佳。官方称,本次更新把重点放在生产环境中的四个问题上:更广的语言覆盖、更自然的指令控制、更精细的标签控制,以及参考音频不清晰时的鲁棒性。目前,在全球第三方权威榜单 Artificial Analysis 中,Qwen-Audio-3.0-TTS-Plus 位列第一。模型已在阿里云百炼开放;部分方言、小语种精品音色及 48kHz 高清输出仍在陆续上线,其中 48kHz 功能预计于 7 月 24 日正式开放,具体以控制台实际展示为准。
Flash 压延迟,Plus 压音质,能力一并开放调用
Qwen-Audio-3.0-TTS 以双版本形态交付。Flash 服务实时交互场景,首包延迟约 300ms;Plus 服务高质量生成,侧重自然度与音色还原。官方同步给出配套精品音色库,将多语种、多方言、指令控制与细粒度表达能力沉淀为可直接调用的音色资源,覆盖指令风格音色、20 种方言音色、细粒度控制音色以及 14 款以上小语种音色。面向严肃创作场景,音频输出品质从 24kHz 提升至 48kHz;单次语音合成支持长达 3 分钟,可覆盖长文本播报需求。Plus 与 Flash 均可在阿里云百炼接入,对应模型入口已公布。
16 种语言与 20 种方言并行推进,客观指标给出对照
多语种方面,模型面向全球场景专项优化,覆盖中文、英文、日语、韩语、德语等 16 种语言。评测基于 CV3-Eval 的 multilingual benchmark。在 WER/CER(越低越好)上,官方称 Qwen-Audio-3.0-TTS 系列展现最强的整体多语言可懂度,在 16 种语言中有 10 种取得最佳表现;Flash 平均 WER/CER 最低,为 3.87,Plus 为 3.96,两者平均表现均优于对照系统。在说话人相似度 SS(越高越好)上,Plus 在全部 16 种语言中均排名第一,平均 SS 达到 82.75;Flash 为 80.44。官方据此认为,系列模型在多语言环境下具备较强且稳定的音色还原能力。
中文方言侧,官方称通过更高质量的方言数据、更丰富的种类覆盖,以及专门的方言强化训练阶段,有效缓解通用语音强化学习中容易出现的「方言特色弱化」问题。目前模型支持 20 种高质量方言,覆盖广东、重庆、东北、甘肃、贵州、浙江、河北、河南、湖北、湖南、江西、宁波、宁夏、青岛、陕西、山西、山东、上海、四川、云南,使合成语音在韵律、声调和口语化表达上更接近母语者。
可控性拆成两层:自然语言导演,标签管到呼吸与情绪
不同场景对语音风格的需求差异很大。官方称,Qwen-Audio-3.0-TTS 支持 Free-style 自然语言指令控制,无需掌握专业声学或标注知识,即可通过自然语言灵活定义情绪、角色、场景、语速等维度,让合成结果与预期高度一致。客服、直播、有声书等差异化语气需求,被明确写进这一能力的适用场景。
在自由文本指令之外,模型还支持在文本中直接嵌入结构化标签,例如 [gasp] 、 [giggles] 、 [angry] ,对语气、情绪和 breath 类细节做精准调控。官方称这种方式特别适合需要精确控制非语言细节的叙事、游戏、影视配音等场景,标签与语音自然融合,可灵活组合构建复杂情感表达。发布材料亦列出耳语、笑场、情绪转折、上下文驱动的语气选择,以及长文本中保持节奏、清晰度与音色一致性等能力点。 复杂声学鲁棒性针对真实参考音频,而不是理想录音
真实业务中,参考音频往往来自复杂环境。官方称 Qwen-Audio-3.0-TTS 对此做了专项优化,通过针对性的真实声学仿真训练,将语音增强能力原生注入复刻流程,使模型能够在嘈杂环境中自动过滤干扰、保留音色;复杂场景下的复刻清晰度和感知质量显著提升,即使参考条件不佳,合成语音依然保持高质量。高混响场景下可有效抑制混响干扰,合成更干净清晰;高噪声场景下抗噪能力更强,语音质量显著优于前代。
榜单第一之外,更值得看的是生产向控制是否成立
这次发布容易被读成又一次「听感登顶」。Artificial Analysis 上 Plus 位列第一,说明其在第三方盲测偏好框架下已被认可,信息量足够。但官方材料真正反复强调的增量,并不只是榜单位次,而是把 TTS 从「能念出来」推进到「可按业务意图被导演」:自然语言指令负责风格与角色,行内标签负责呼吸、笑声与情绪转折,多语种与方言负责覆盖,受损参考音频鲁棒性负责复刻能否进生产。对开发者和内容团队来说,选型变量会从单一自然度,扩展到指令服从、标签精度、方言正宗度,以及参考音频不理想时是否仍可用。
需要克制的地方在于,部分方言、小语种精品音色与 48kHz 输出仍在百炼陆续上线,能力矩阵与控制台可见范围暂时不完全等同;客观指标来自官方披露的 CV3-Eval 结果,真实业务负载下的延迟、长文本一致性和标签服从率,仍要以接入后的实测为准。
接下来要看 7 月 24 日交付与控制台可见范围
短期关键节点是 7 月 24 日 48kHz 功能是否按期正式开放,以及方言、小语种精品音色分批上线是否补齐到官方宣称的覆盖范围。同步值得观察的,是 Flash 在真实交互链路中的首包表现是否稳定落在约 300ms 量级,以及 Free-style 指令与细粒度标签在客服、有声书、游戏配音等场景中的可复现程度。Qwen-Audio-3.0-TTS 现已全面开放;在滚动上线项落齐、业务侧复测出现之前,它更适合被看作一次把「表达控制」写进生产 TTS 主能力的版本升级,而不是语音合成问题已被一次性关闭。
 AI 速览