7月22日消息,OpenAI 连续公布了两组 Codex 产品更新:Codex 代码审查支持读取仓库 AGENTS.md 中的自定义规则,并在审查发现中引用对应规则;围绕长对话、侧边栏、审查和侧边聊天的体验更新。同时,OpenAI 披露,Codex 用户约 1000 万,较ChatGPT Work 发布增长400万。两组更新指向同一个方向:Codex 正在从单轮请求的编码工具,转向承载团队知识、支撑多任务并行的开发平台。
AGENTS.md 审查规则:把评审经验变成可执行的仓库知识
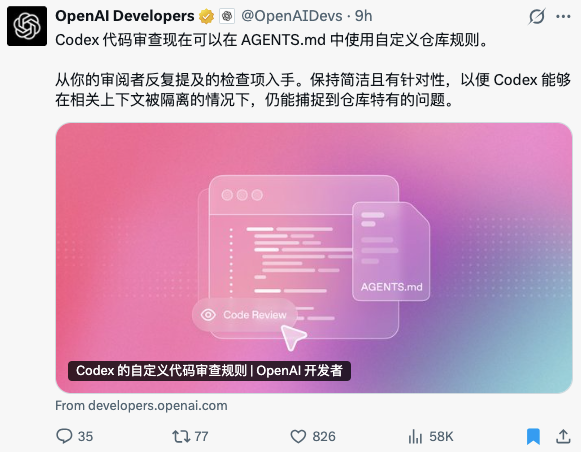
Codex 的审查功能现在可以读取仓库 AGENTS.md 中的规则,并在每条审查发现中引用命中的具体规则。官方建议的写法很具体:仓库级规则放在根目录的 AGENTS.md,服务级规则放在对应目录的嵌套 AGENTS.md 中;规则内容从评审员反复向团队解释的检查项入手,保持简洁、按代码归属限定作用范围,格式化这类机械检查则留给 CI。
官方给出的评测数据是:规则引导的审查恢复了 98% 的必需自定义发现,而未使用规则的基线对照组只有 58.3%。这个差距说明,通用审查能力的天花板不在模型本身,而在模型拿不到的那些团队约定——哪些接口必须保持向后兼容、哪些目录的改动需要额外审查、哪些写法在这个仓库里是禁区。AGENTS.md 本质上是把资深评审员的隐性经验显式化、版本化,让审查标准随仓库一起走,而不是随人走。对团队来说,这件事的实际意义是:代码审查的竞争点正在从"模型能不能发现问题"转向"团队知识能不能沉淀进审查流程"。
体验更新:围绕多任务并行的摩擦力做减法
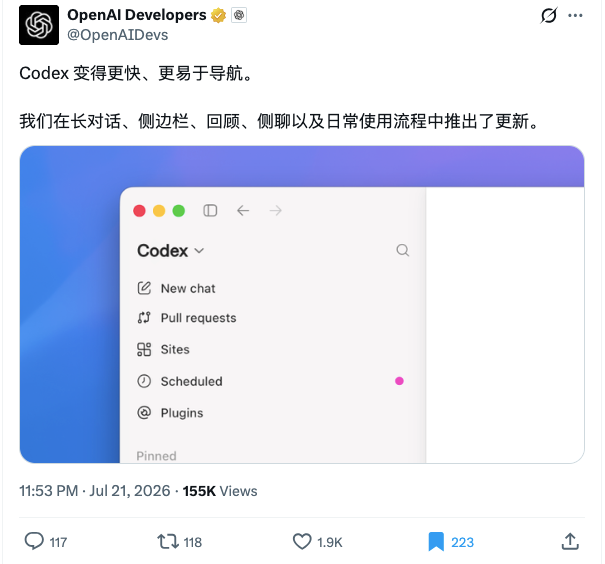
7月21日发布的体验更新主题是"更快、更易导航",集中在几个高频痛点上:长对话、侧边栏、审查和侧边聊天的流程改进;审查树中可以直接显示文件状态;侧边聊天和子代理的活动状态显示更快,排队中的后续问题可以直接转为侧边聊天,无需复制粘贴。此外还有一组细节优化:切换任务时草稿保留在身边,搜索快捷方式更快定位,路径导航栏可点击跳转,预览会在正确的任务中打开,自动化功能遵循本地时间。
这批更新单看都不大,但方向一致:它们服务的不是"写一个函数"的场景,而是开发者同时挂着多个任务、多个会话、多个审查的并行工作方式。智能体编码的使用形态已经从单轮请求转向多任务调度,产品摩擦力的主要来源也随之从模型能力转向会话管理。这组更新没有对应的官方博客长文,信息来自 OpenAI 开发者官方账号的社媒发布。
写作功能同向更新:先提问,再动笔
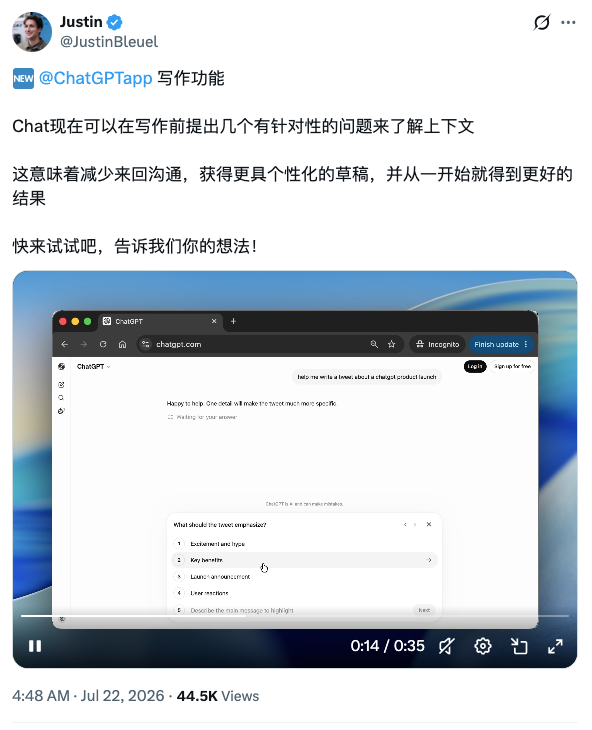
OpenAI 员工 Justin Bleuel 在 X 上宣布了 ChatGPT 写作功能的更新:写作前,Chat 会先提出几个针对性问题了解上下文,演示中可见"受众与目标""关键要点""语气"等选项,官方说法是减少来回沟通、产出更个性化的草稿,从一开始就得到更好的结果。。
这条更新看起来属于另一个功能线,但产品逻辑和 Codex 的 AGENTS.md 规则完全一致:执行之前先补上下文。写作功能向用户主动索取上下文,AGENTS.md 让团队把仓库上下文预置给模型,两者都在把"一次性提示词"变成"先对齐再执行"的两步流程。
用户数据是背景:合计口径 1000 万,增长机制自带传播设计
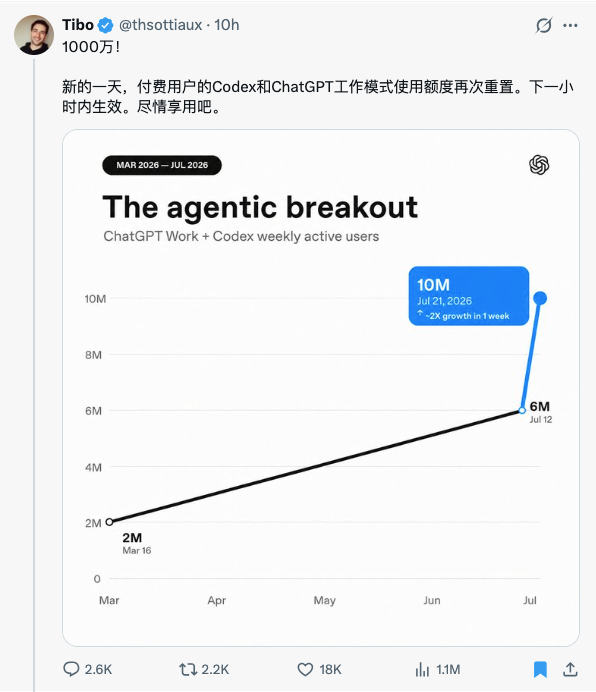
Sam Altman 称两者合计用量单周增长 2.5 倍,Codex 用户约 1000 万。口径上需要说明:Codex 已于 7 月 9 日并入 ChatGPT 桌面版,ChatGPT Work 同日发布,两者同属 ChatGPT 产品内的智能体功能,OpenAI 按同一个"智能体"口径合并统计。
增速背后有一个官方设计的机制:每新增 100 万用户,就为付费用户重置一次使用额度。该机制 5 月由 Altman 公布,7 月 16 日用户突破 900 万时已执行过一次重置。按已公布的机制推断,突破 1000 万当次也会触发重置。
更新的真正指向:Codex 在从工具变成团队开发流程的默认入口
把这些动作放在一起看,用户数据说明需求侧已经起来,而两组产品更新回答的是"起来之后靠什么留住"。AGENTS.md 规则解决的是粘性问题:团队的评审知识一旦写进仓库,迁移成本就不再只是换一个模型 API。体验更新解决的是规模问题:当一个开发者同时推进的任务从一两个变成五六个,会话和审查的管理效率就成了产品的实际天花板。额度重置机制则持续为增长端供能。三层动作对应的是平台化产品的三个必要条件。
行业对照上,Anthropic 同一天为 Claude Code 桌面版上线了 iOS 模拟器公测,把智能体编码的边界推向移动端开发环境。两家的路径差异已经清晰:OpenAI 在打磨审查与协作这一层,试图成为团队开发流程的默认入口;Anthropic 在扩展智能体能操作的设备与环境。对开发者来说,选择的依据正在从模型能力榜单,转向哪家的工作流更贴近自己的日常。 接下来要看规则生态的采用率和合并口径的拆分
目前最值得观察的有两件事。一是 AGENTS.md 审查规则的真实采用率:98% 的数字出自官方评测,真实仓库中规则编写质量参差不齐,能否复现这个提升,要看开发者社区接下来几周的反馈,以及是否出现共享、复用审查规则的实践。二是 1000 万用户口径的拆分:Codex 与 ChatGPT Work 各自占多少、付费转化如何,决定了"接近翻倍"的含金量,也决定了 OpenAI 后续会把资源压在哪条线上。体验更新则要留意它是否指向更大的产品动作:侧边聊天、子代理状态、任务草稿这些改动,像是在为多智能体并行的下一版交互做铺垫。
 AI 速览