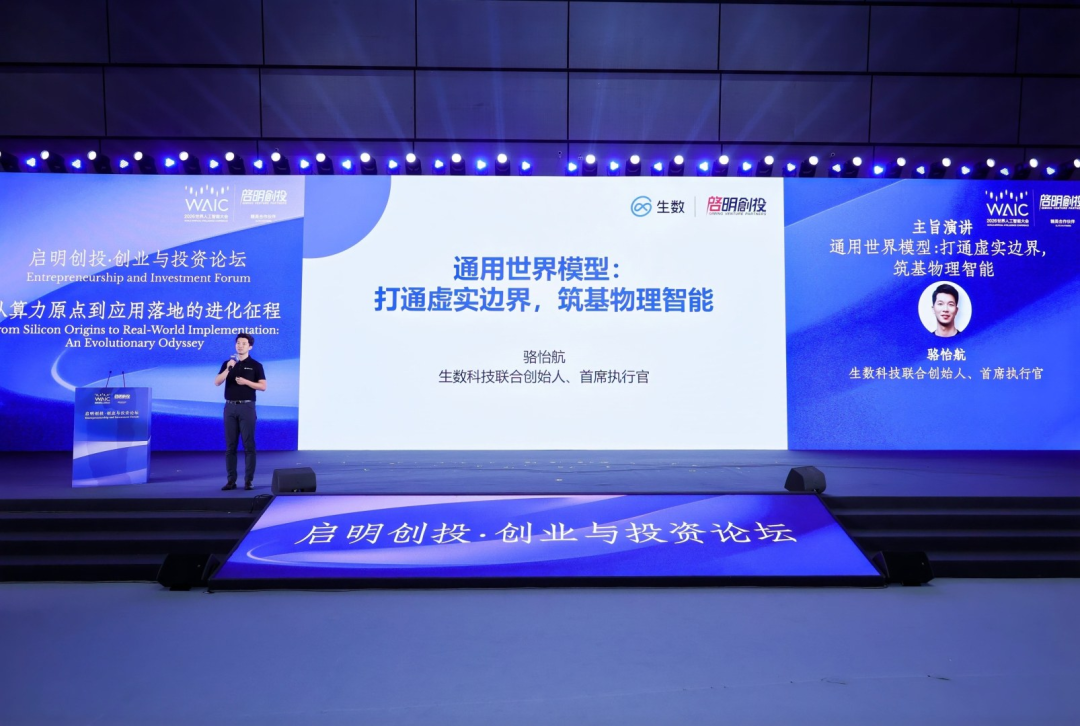
2026 世界人工智能大会启明创投创业论坛上,生数科技联合创始人骆怡航发表主题演讲,提出行业核心判断:大语言模型完成了文本智能跃迁,而通用世界模型将成为下一阶段 AI 发展主线,打通数字内容与物理机器人两大场景,实现机器从 “读懂文字” 到 “理解真实世界” 的能力升级。
一、行业范式切换:语言模型存在能力边界,世界模型补齐物理认知短板
过去大语言模型仅依托文本知识库,只能处理静态文字信息,无法适配机器人、自动驾驶、动态视频等实时变化的物理场景。
人类智能包含大量视觉感知、运动预判、行为决策能力,仅靠文本模型只能发挥一小部分智能潜力。真实世界是动态、存在因果关联的复杂系统,智能体需要完成感知环境、预判变化、根据行动推演结果、持续调整决策全流程。
语言模型无法完成这套闭环,而世界模型的核心价值,就是搭建统一体系,把感知、预测、行动融合为一体,补齐 AI 对物理规律、时空变化、因果逻辑的认知短板,是迈向物理 AGI 的核心底座。
二、核心路线:通用化是世界模型规模化落地唯一路径
当下不少厂商开发场景专属世界模型,单机器人、单赛道单独训练,数据、研发、部署成本极高,难以规模化复制。
参考大模型成功路径,通用世界模型必须先通过海量多元数据完成统一预训练,沉淀空间、运动、因果通用底层能力,再迁移适配各类细分场景。
行业竞争的核心不再是单一任务跑分高低,而是模型的泛化能力、规模化成本与智能涌现潜力。统一底层基座可以适配数字创作、工业机器人、家用具身等完全不同的载体,避免重复造轮子,大幅降低全行业落地门槛。
三、视频是构建世界认知核心数据载体
文字是现实抽象符号,单张图片仅记录瞬时状态,只有连续视频完整记录物体受力、空间变换、行为因果等世界底层规律。
模型预测下一帧画面的过程,本质就是学习真实世界的转换逻辑。因此视频是搭建世界认知的核心入口,在此基础上还可融合仿真数据、第一视角操作、机器人真机交互数据,完善对物理世界的完整建模。生数科技以此搭建统一基座,同一套底层认知能力,分别向数字、物理两大方向做解码输出。
四、一体两翼产品布局,覆盖数字与物理全场景
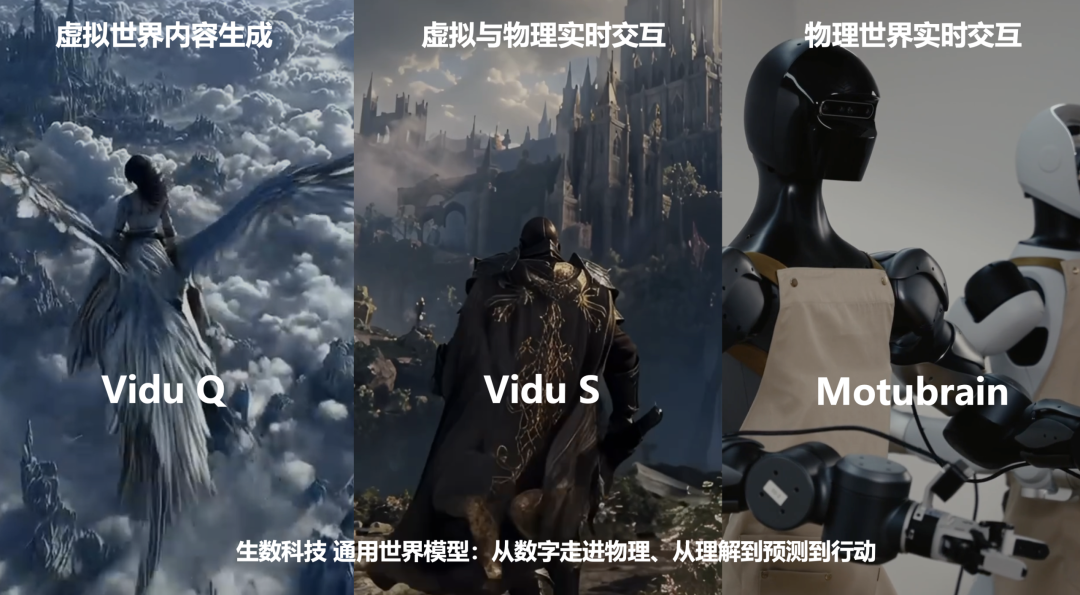
生数科技依托通用世界模型基座打造三条产品线,共享统一时空、因果建模底层:
- Vidu Q 系列:离线数字内容生成,强化人物、场景、物理逻辑,支撑影视、虚拟内容创意创作;
- Vidu S 系列:实时交互式视频,适配虚拟人、互动游戏等连续动态数字场景;
- Motubrain:面向物理机器人,将世界预测能力转化为可执行机械动作,支撑工业、家用具身智能自主规划。 数字虚拟智能体与物理机器人形态千差万别,但底层通用认知完全同源,实现一套模型底座赋能两条赛道。
五、产业长期价值:打通虚实,构建下一代 AI 基础设施
大模型实现文字交互,视频模型实现视觉创作,而通用世界模型将推动 AI 具备自主预判、自主行动能力。
未来各类机器人都会成为物理世界智能体,自主完成复杂长周期任务。通用世界模型是衔接数字、物理世界的核心基础设施,打破虚拟内容和具身智能的技术割裂,让 AI 不再局限于信息问答,真正能够观察世界、推演变化、自主行动,开启人工智能全新发展周期。
 AI 速览