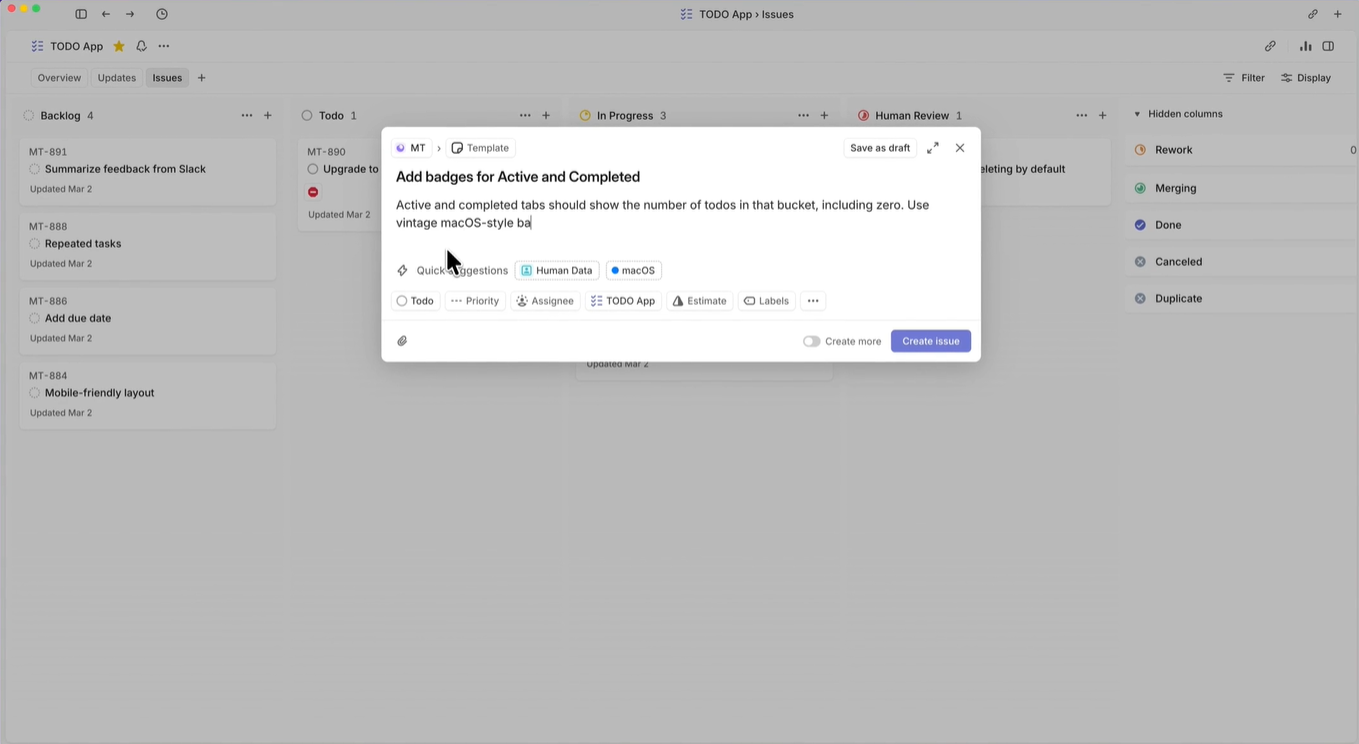
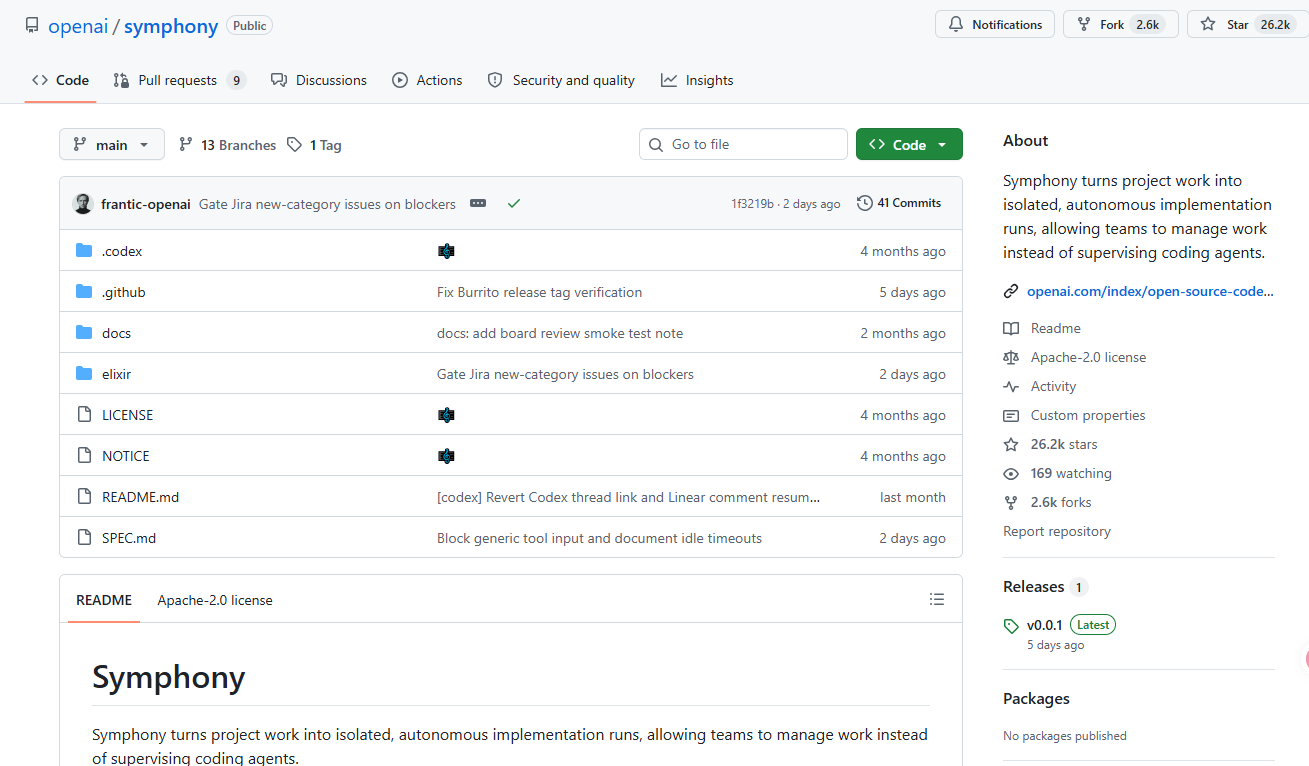
Symphony是由OpenAI于2026年4月开源的多Agent编排系统,核心理念是将项目管理看板(如Linear)转化为编程Agent的"控制平面"——每一个未关闭的任务都会自动触发一个独立的AI Agent,在隔离环境中自主完成代码编写、测试、提交PR等全流程工作。OpenAI内部团队使用后,已合并到主分支的PR数量在3周内增长了500%,GitHub已获21,000+ Star。小编将从定义、核心功能、使用方法、竞品对比、注意事项等角度为您系统梳理。
Symphony是什么
Symphony是OpenAI推出的开源Agent编排规范与参考实现,定位为"Codex编排系统"而非独立产品。其本质是一份SPEC.md文件——定义问题和预期解决方案的语言无关规范——配合一套基于Elixir(BEAM/Erlang VM)编写的参考实现。官方明确表示不会将其作为独立产品维护,而是鼓励开发者根据规范用任意语言自行实现。
Symphony解决的核心痛点是"AI编程的瓶颈不是模型能力,而是人类注意力"。传统AI编程模式下,工程师通常只能同时管理3-5个Codex会话,超出此范围后上下文切换成本急剧上升。Symphony通过将任务追踪系统转化为Agent控制平面,让工程师从"操作员"转变为"任务定义者"——只需创建工单,Agent自动接手并完成,人类只负责最终审查。
Symphony基于Harness Engineering(驾驭工程)哲学设计,包含四大系统:
- 约束系统:规定Agent能做什么、不能做什么,工作空间隔离确保单个任务的代码变更不污染整个仓库
- 信息系统:通过WORKFLOW.md和项目文档确保Agent了解完成任务所需的全部上下文
- 验证系统:Agent自主运行端到端测试、CI检查、QA冒烟测试
- 修正系统:Agent崩溃自动重启、卡住自动重试、CI失败自动变基和修复冲突
Symphony的核心功能
工单即控制平面
Symphony最核心的设计是将Linear或GitHub Issues等项目管理工具直接转化为Agent的指挥系统。每一个带有指定标签(如agent)的开放工单,都会自动创建一个隔离的Agent工作空间,由Codex在headless模式下持续轮询、执行、重试和自愈。工单状态机驱���整个开发流程:In Progress → Agent开始工作 → Review → PR提交 → Done。
Agent还可以自行创建子任务——在实现或审查过程中发现超出当前范围的改进点时,会直接创建新的issue供团队后续评估。多个Agent可并行工作,通过工单间的依赖关系(DAG)自动排序执行,互不阻塞。
工作空间隔离与安全
每个工单对应一个独立的git worktree和进程级隔离环境。Agent只能访问目标仓库、测试框架和Shell,无法触及同主机的其他仓库、用户主目录或密钥文件。如果一个Agent崩溃或跑偏,影响范围被严格锁定在工单目录内,不会污染整个代码库。基于BEAM VM的Actor Model实现并发:每个Agent工作空间是一个独立Actor,天然隔离,崩溃不影响整个编排系统。
WORKFLOW.md驱动策略
Symphony不将工作流硬编码在系统内部,而是通过仓库中的WORKFLOW.md文件定义Agent应遵循的开发流程——检出新分支、编写代码、运行测试、提交PR、添加视频演示等。这是以前只有人类工程师才遵循的隐式流程,现在被明确文档化,Agent严格遵循。当团队需要调整工作流时,只需修改WORKFLOW.md即可。
长时间任务自动容错
Symphony设计用于处理跨数小时甚至数天的大型任务,内置完整的容错与恢复机制:Agent崩溃时监督树(Supervisor Tree)自动重启;CI失败时自动变基、解决冲突、重试不稳定检查;任务状态变化时自动停止无效运行;所有操作通过指数退避策略处理瞬时故障。这种"永远不睡觉"的调度能力使其特别适合大型单体仓库中将PR推到主分支的"最后一公里"。
多角色协作与透明轨迹
Symphony扩大了可以发起工作的角色范围。产品经理和设计师可以直接在Linear中提交功能请求,无需检出代码仓库或管理Codex会话——只需描述需求,就能获得一个包含功能视频演示的评审包。每个Agent的完整执行轨迹(Token消耗、耗时、重试次数、执行结果)均被记录,团队可对Agent的工作效率进行量化分析和审计。
Symphony怎么用
Symphony的使用方式与传统工具截然不同——它不是"安装一个软件",而是根据规范构建或部署属于自己的编排系统。官方建议的安装方式甚至是"让Codex根据SPEC.md自行构建Symphony",Codex已在Elixir、TypeScript、Go、Rust、Java、Python六种语言中成功实现。
标准部署流程如下:
- 环境准备:安装Elixir/Erlang(参考实现需要BEAM VM),或选择社区贡献的其他语言实现
- 获取SPEC.md:从openai/symphony仓库获取最新规范文件,这是整个系统的"宪法"
- 配置集成:连接Linear API Key(需要issues读写权限)和Codex App Server(继承codex CLI会话),设置SYMPHONY_WORKSPACE_ROOT指定工作空间根目录
- 编写WORKFLOW.md:在目标仓库中定义Agent应遵循的开发流程——从代码编写到测试运行到PR提交的全链路
- 启动编排器:运行Symphony服务,连接Linear团队,系统自动拉取带agent标签的开放工单并开始调度
- 以工单驱动工作:在Linear中创建工单,添加agent标签——Agent自动接手、写入PR链接和视频演示、将工单移至Review状态
社区已涌现多种实现方式:基于Charm CLI的Go版本、基于Claude SDK构建的版本等,开发者可根据自身技术栈灵活选择。 Symphony的价格与竞品对比
价格模式
Symphony框架本身完全开源免费(Apache-2.0协议)。实际使用成本主要来自Codex API调用费用和基础设施投入:
| | |
|---|
| | |
| ChatGPT Plus订阅含基础额度,超出按Token计费 | |
| | |
| 多Agent并行跑大型Feature,月度费用可达数万美元 | |
| 运行Symphony的开发机/云服务器、Linear订阅 | |
Codex API采用Token计费制,ChatGPT Plus($20/月)、Pro 5x($100/月)、Pro 20x($200/月)等订阅方案包含不同的Codex云任务额度。企业团队建议先从小规模试点开始,量化单Agent单任务的Token消耗后再做预算规划。
核心竞品对比
选型建议:已确定使用OpenAI模型栈且需要在真实代码库中7×24自主完成完整Feature开发的企业团队,Symphony是当前最适合的方案;需要混用多厂商模型或工作流极其复杂的场景,优先考虑LangGraph;追求快速原型验证和角色分工,CrewAI体验最佳。
Symphony的注意事项
- 项目工程化水平是上限:Symphony是"放大器"而非"魔法棒"——测试必须自包含(不依赖外部数据库/网络服务)、文档必须机器可读、架构必须模块化。如果项目测试跑不通、文档靠口口相传,Symphony不仅帮不上忙,反而可能放大混乱
- 锁定OpenAI生态:Symphony深度绑定Codex App Server和OpenAI模型,无法直接使用Claude或Gemini。切换到其他模型需要大量修改,对于已适配其他AI编程工具(如Cursor、GitHub Copilot)的团队存在迁移成本
- 非所有任务都适合:Symphony擅长常规实现工作(修复Bug、更新依赖、标准化CRUD),但对于高度不确定或需要强判断力的任务(新架构设计、复杂业务逻辑),仍需工程师直接使用交互式Codex会话
- 需要DevOps投入:部署Symphony不是"装个插件"——需要配置Erlang/Elixir环境、Linear集成、Codex App Server、沙箱工作空间等。团队需要具备一定的运维能力,维护成本高于开箱即用的SaaS工具
- Agent质量控制需持续迭代:初期Agent可能产出完全偏离预期的结果。正确的做法不是手动修补产出,而是将失败暴露的问题转化为防护措施和技能——改进WORKFLOW.md、添加端到端测试、增强Code Review规则等,这是一个持续优化的过程
- Codex API费用不可忽视:虽然框架免费,但Codex API按Token计费。每个Agent运行一次完整Feature实现可能消耗数十万甚至数百万Token,大型团队的月度费用可能达到数万美元,需提前做好成本预算和配额管理
- 系统仍在快速演进:Symphony作为开源规范而非成熟产品,官方不承诺长期维护。社区版本可能存在不一致性,依赖的Codex App Server也在持续更新,团队需关注兼容性变更
以上内容基于OpenAI官方博客(2026年4月)、openai/symphony GitHub仓库、行业技术媒体及社区实践报告整理。Symphony是开源项目,大家可以多关注本站,获取最新的项目消息。
 AI 速览