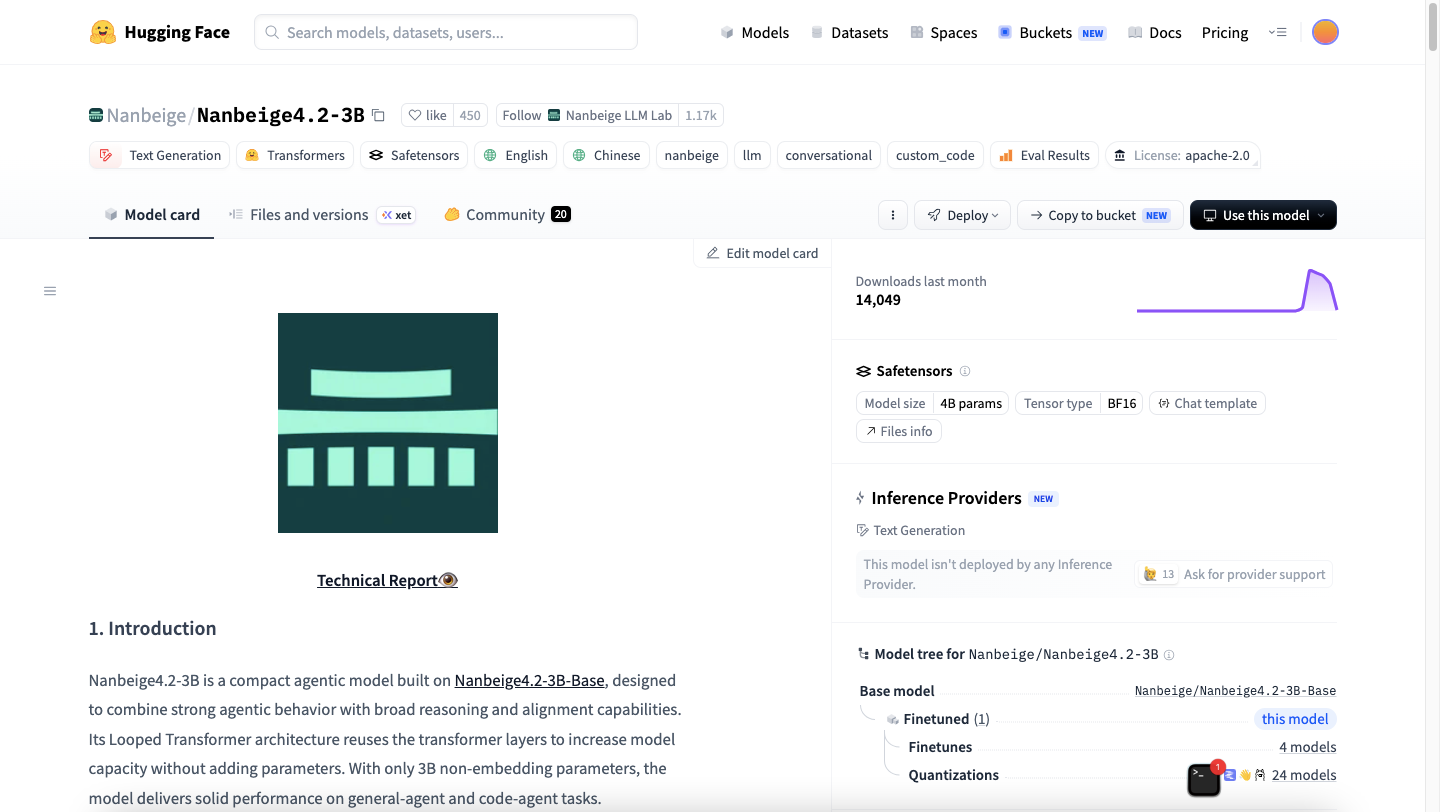
7月27日消息,BOSS 直聘旗下南北阁实验室近日开源 Nanbeige4.2-3B,模型权重和代码已在 Hugging Face 上以 Apache 2.0 许可发布。该模型非嵌入参数约 3B(总参数约 4B),官方自测在 SWE-Bench Verified 上得分 63.6,超过 Qwen3.5-9B 的 53.1 和 Gemma4-12B 的 44.2。
用 22 层跑两遍,把处理深度翻倍
Nanbeige4.2-3B 在架构上的核心选择是 Looped Transformer:模型只有 22 层 decoder,但推理时将隐藏状态送回同一组层再跑一遍,相当于用一套权重做了 44 层深度的计算。这种设计的思路是在不增加参数量的前提下提升有效容量。模型卡将这一机制称为 LoopSplit,并搭配了 mHC 深度注意力和拼接 n-gram 嵌入等技术。训练方式上,官方描述为监督微调加混合奖励(包含过程奖励和结果奖励)的强化学习,预训练数据量约 28 万亿 Token。
Looped Transformer 并非全新概念,近期有论文指出简单地重复 transformer 块通常会导致性能下降,需要专门设计的训练方案配合。Nanbeige4.2-3B 从训练阶段就引入了循环结构,与后挂的朴素复用不同,但这仍然是一个需要在独立测试中验证的架构声明。
官方 benchmark 覆盖面广,但都是自测
模型卡提供了一份涵盖 19 个指标的对比表,对手选的是 Qwen3.5-9B、Qwen3.5-4B、Gemma4-12B 和 Gemma4-E4B。在代码 Agent 类任务上,Nanbeige4.2-3B 的 SWE-Bench Verified 63.6、SWE-Bench Pro 46.9、Terminal-Bench 2.0 44.1 均领先所有对比模型。推理类指标同样如此,GPQA-Diamond 87.4、LiveCodeBench-V6 72.5 也高于两个更大的对手。在通用 Agent 测试 GDPval 上得分 74.3,Qwen3.5-9B 为 61.9,Gemma4-12B 为 68.5。
需要留意的边界:所有评测均在 thinking mode 下进行,SWE-Bench Verified 使用的是 OpenHands scaffold,GDPval 等通用 Agent 测试使用了南北阁自研的 scaffold。不同 scaffold 对结果的影响不可忽略,这也是社区要求独立复现的主要原因。Ground Truth 的分析还指出,「超越四倍参数量对手」的说法在参数口径上不够严谨——Gemma4-12B 的 12B 是总参数,Nanbeige4.2-3B 的 3B 是非嵌入参数,同口径对比是 4B 对 12B,约三倍而非四倍。
对本地部署开发者有实际意义
从使用角度看,这个模型的吸引力在于尺寸。3B 非嵌入参数意味着 BF16 权重可以装进单张消费级 GPU,量化后甚至可以在纯 CPU 上运行。模型支持 256K 上下文窗口,内置 XML 和 JSON 两种格式的工具调用模板,发布时就提供了 vLLM、SGLang、llama.cpp 和 Ollama 的部署配置。对做本地 Agent 或代码辅助工具的开发者来说,一个能在笔记本上运行、且在代码修改任务上有不错分数的开源模型,确实是 Qwen3.5-4B 和 Gemma4-E4B 之外值得试的选项。
南北阁实验室的前作 Nanbeige4.1-3B 今年 2 月曾登上 Hugging Face 全球文本模型趋势榜第一。从 4.1 到 4.2 的迭代加入了 Looped Transformer 架构,并更新了训练数据量。这是 BOSS 直聘这家在线招聘平台在小参数开源模型上的第二次集中发力。
关键还是独立测试
官方自测的数字很强,但代码 Agent 的 benchmark 对 scaffold、采样策略和 thinking mode 配置高度敏感。63.6 这个分数能否在社区独立复现中站住脚,是决定 Nanbeige4.2-3B 从「引人注目」变成「可以信赖」的分水岭。在 Reddit r/LocalLLaMA 上,目前最多的反应也是同一个词:needs independent testing。
 AI 速览