7月31日消息,MiniMax 正式发布全模态生成模型 MiniMax H3。这是该公司今年1月在港交所上市后,视频生成产品线的首个大版本:一个模型统一理解文本、图像、视频、声音组成的多模态上下文,输出原生双声道音视频,最高支持 15 秒 2K 分辨率。官方同时给出两个激进口径——默认提供 2K 分辨率,2K 下每秒价格不到主流模型的三分之一,768P 下不到二分之一;并计划近日开放模型权重。
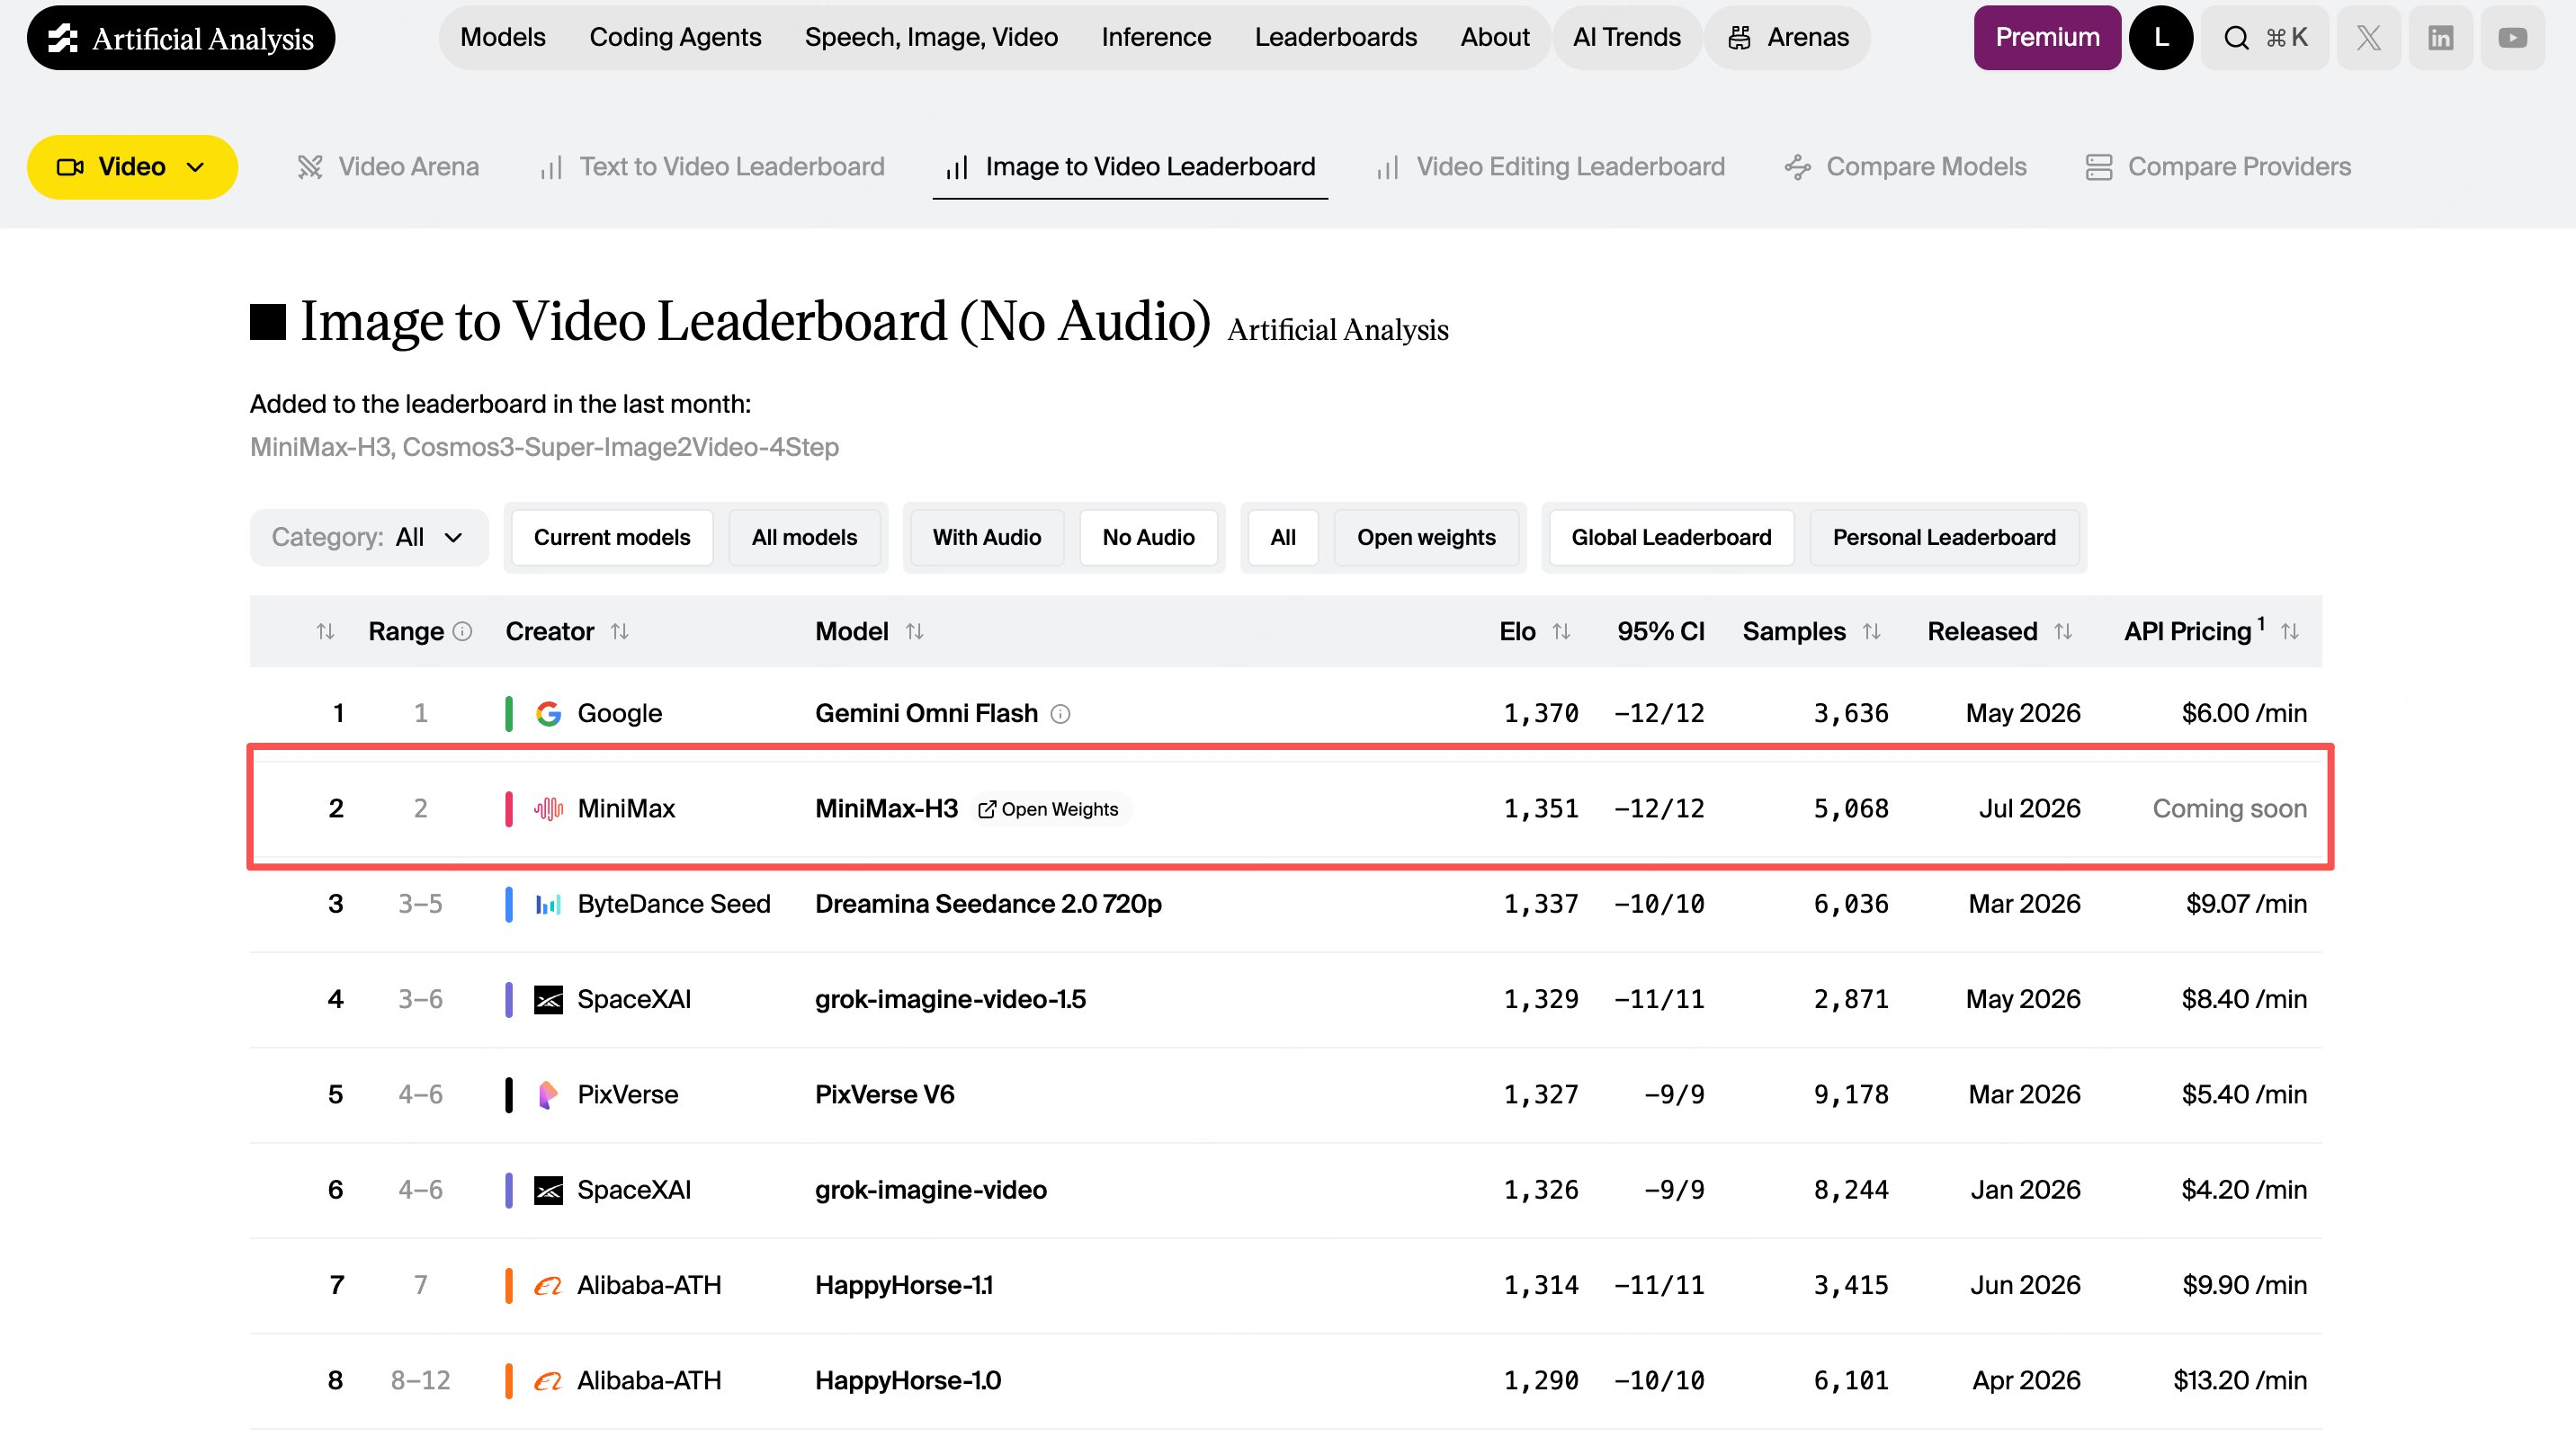
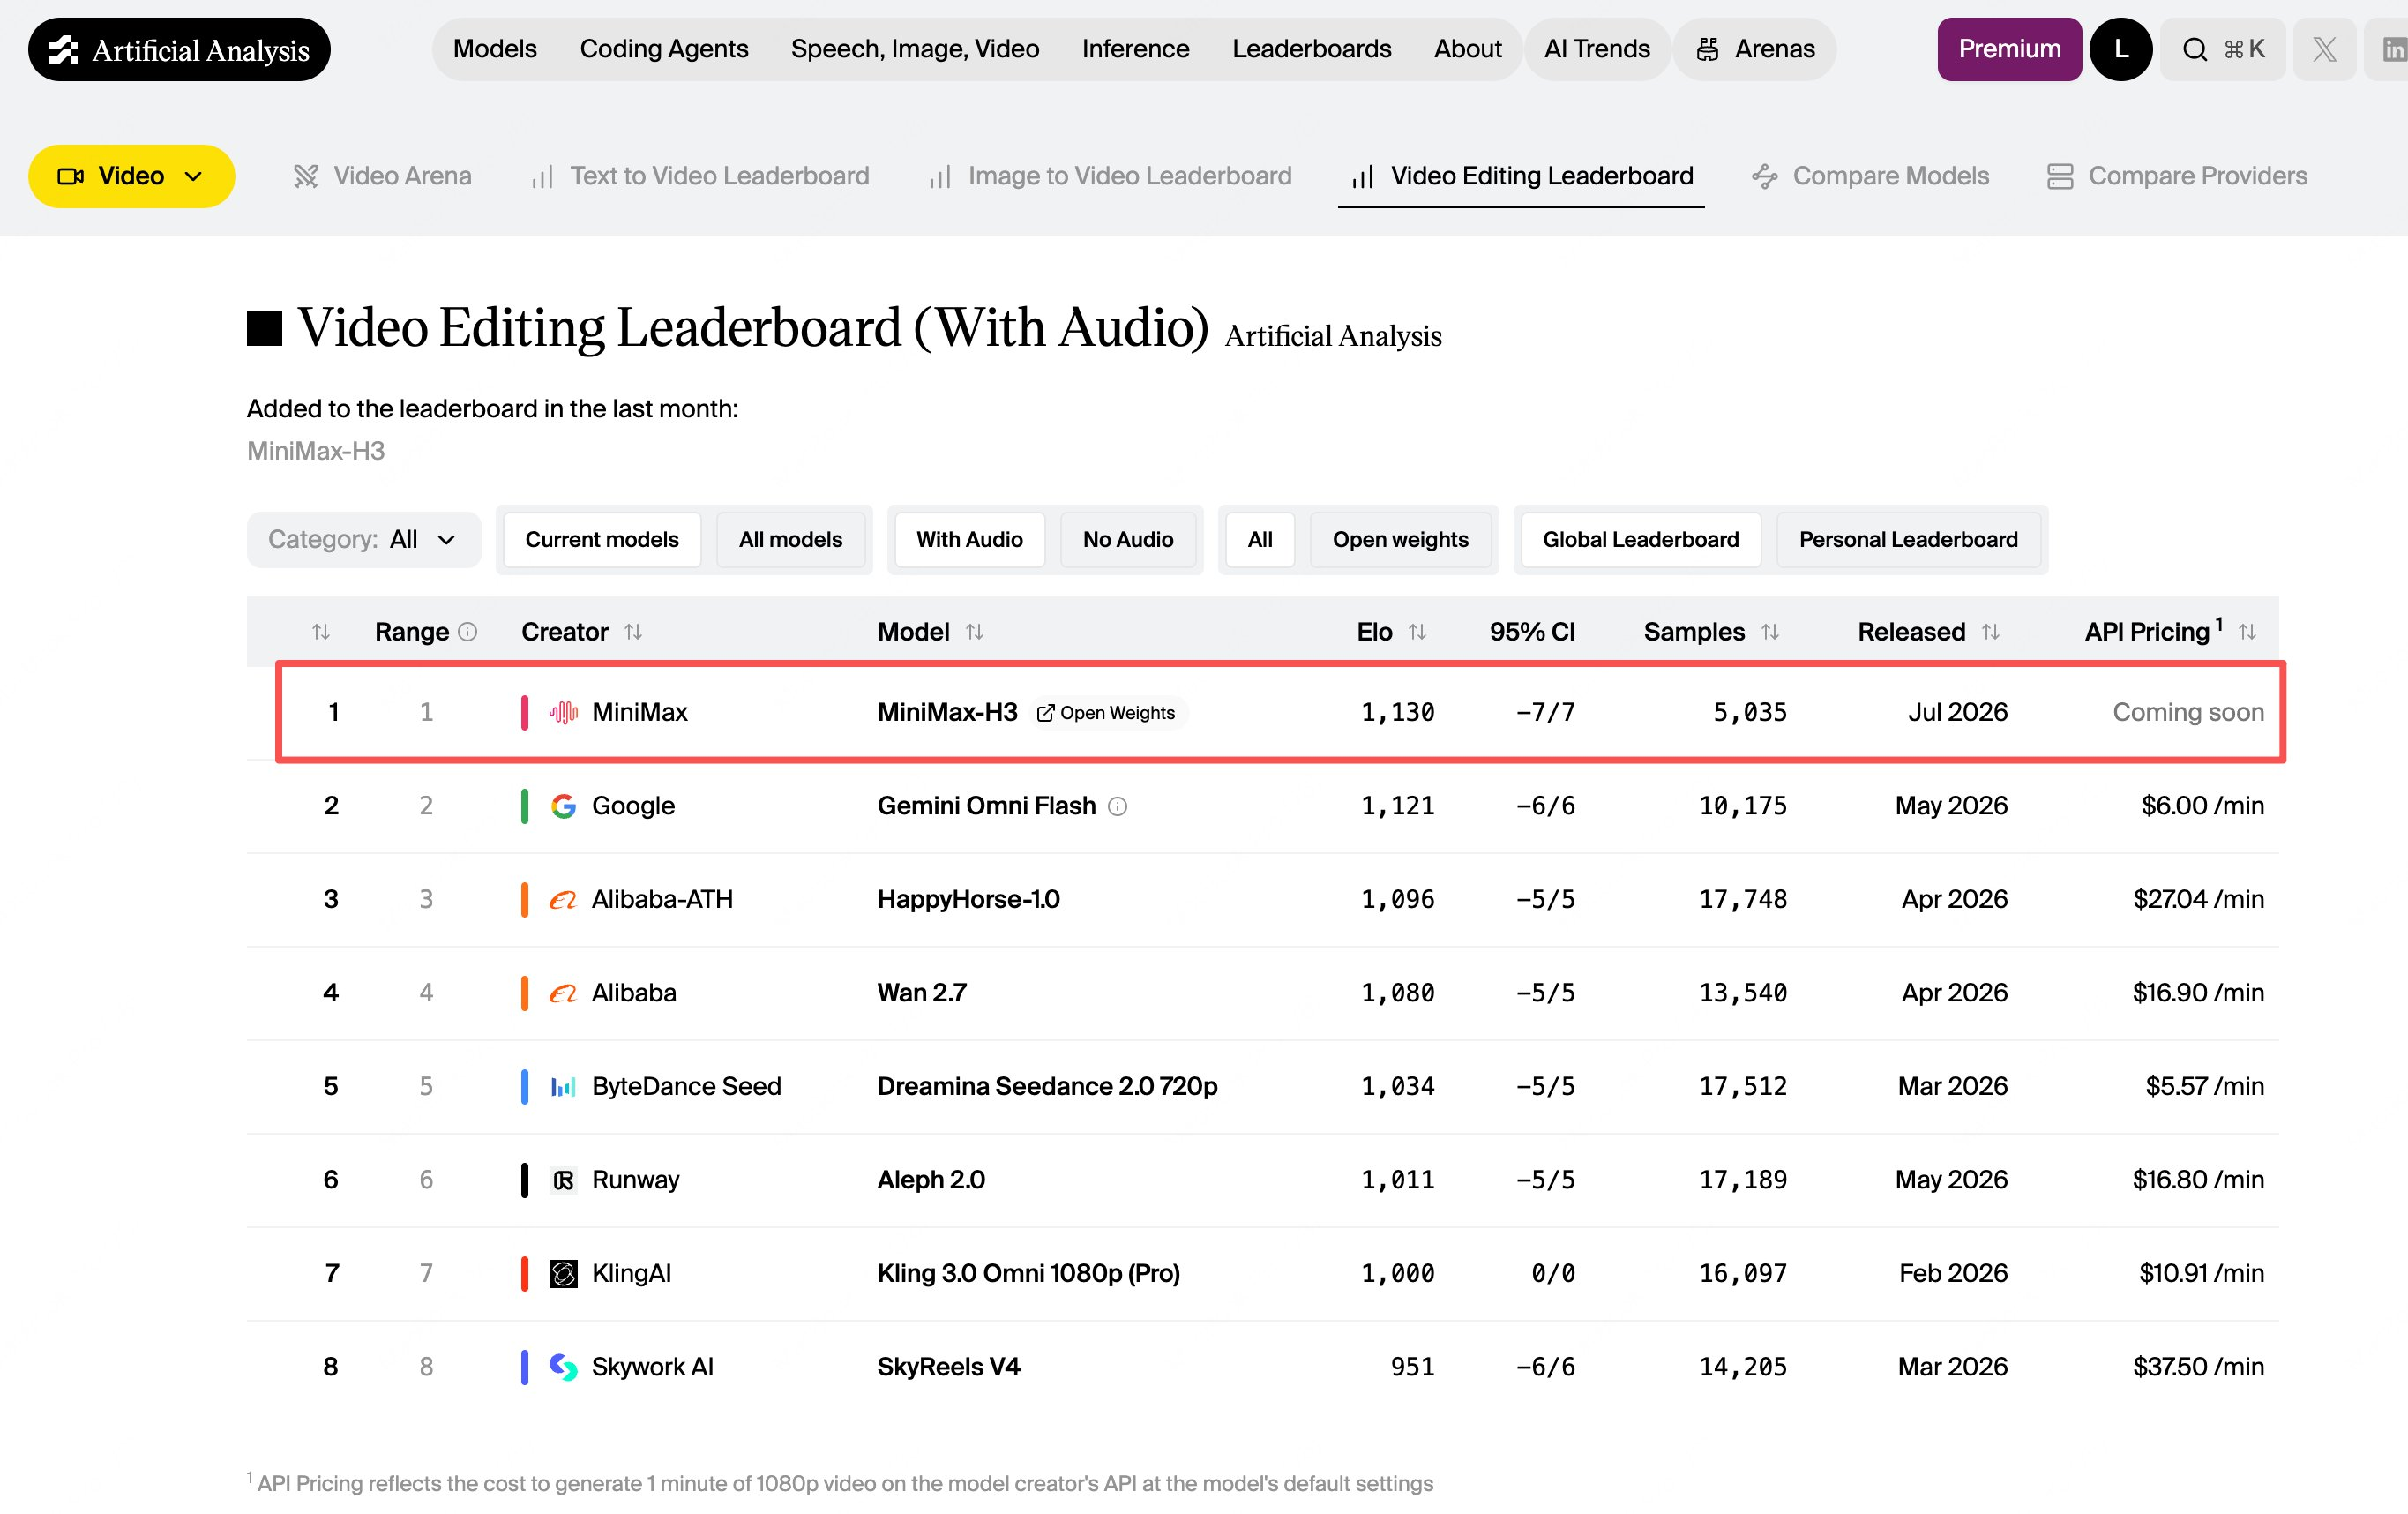
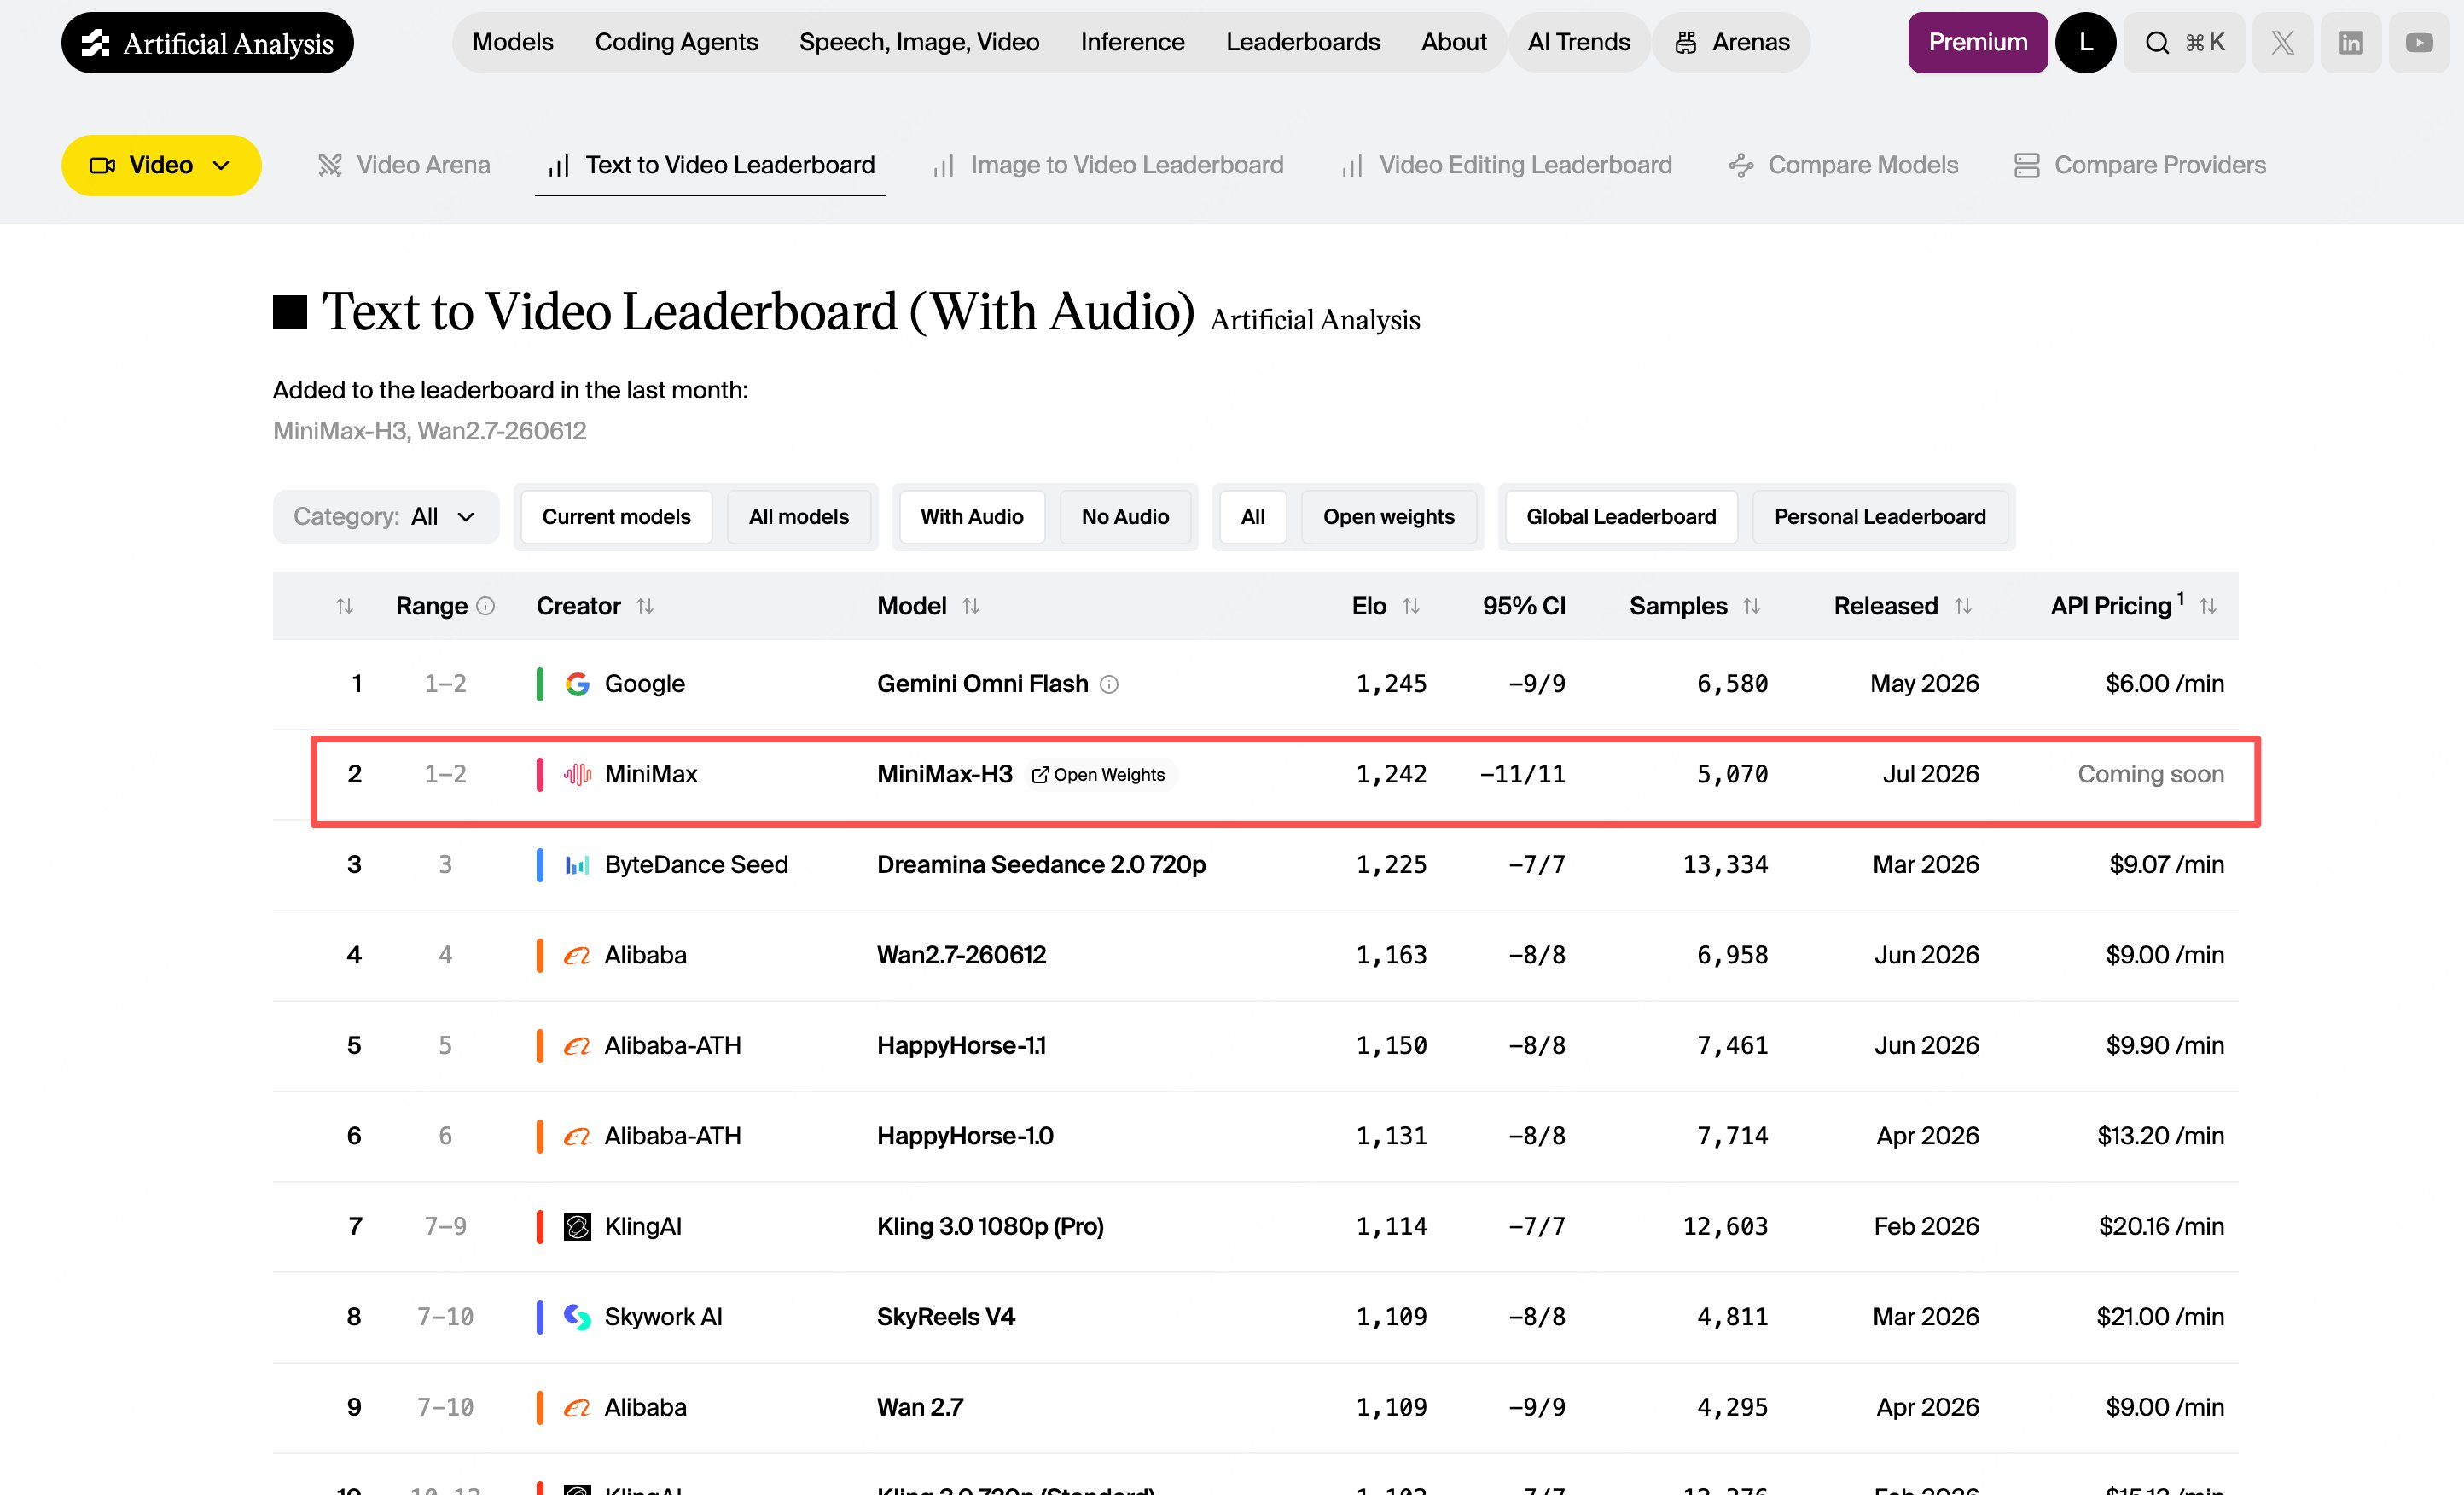
发布当天,第三方测评机构 Artificial Analysis 的视频竞技场已收录 H3:视频编辑榜列第 1,文生视频(带音频)榜列第 2、与榜首谷歌 Gemini Omni Flash 的差距在统计误差之内,图生视频(无音频)榜列第 2。
需要注意的边界有三处:官方没有点名"主流模型"是谁;权重开放目前仍是计划而非事实;H3 入榜仅数日,样本量明显小于老牌模型,具体名次仍可能漂移。
一个模型装下此前拆开的所有生成任务
MiniMax 在官方发布稿中把 H3 的第一设计纲领称为"任务的统一和泛化"。在此前两代海螺模型(2024年8月的 Video-01、2025年6月的 Hailuo 02)上,图片、视频、音频生成被拆成文生视频、图生视频、首尾帧、主体参考、动作参考、视频编辑等细分功能,声音生成也按人声、音效、音乐分开研究。H3 把这些任务收进同一个模型:文生视频时联合生成原生双声道音频并支持多镜头建模,参考和编辑则统一为由自然语言描述的广义任务,图片、视频、音频之间可以互相作为上下文输入。
官方给出的一个示例是:参考一段视频的希区柯克镜头运动,让一张图片中的人物唱歌,歌声再参考另一段音频。用户用自然语言描述三个素材与目标视频的关系,模型自行完成跨模态理解。官方称,根据前期邀测反馈,H3 在指令遵循、文字与品牌信息呈现、V2V Motion Transfer(视频到视频动作迁移)等方面表现较好,面向广告、品牌、电商、产品设计、游戏等商用场景。
支撑这些能力的技术改动,官方点名了四项:Contextual Omni Representation 用泛化的 Caption 描述上下文与目标的关系;H3-VAE 的压缩率带来 4 倍序列长度收益,是原生 2K 的基础;理解与生成异构的训练架构将训练吞吐提升了近 30%;2K 输出不走专用超分模块,而由基模对自己的低分辨率结果做上下文内重新生成。这些数字均为官方口径,详细技术报告尚未发布。
价格口径激进,但权重和官方 API 都还没落地
价格是 H3 发布中最有攻击性的部分。官方称 H3 默认提供 2K 分辨率,2K 下每秒价格不到主流模型的三分之一,768P 下不到二分之一。官方没有点名对照对象。目前第三方 API 平台 EvoLink 已上架 H3,2K 档定价 0.13 美元/秒;作为参照,Google Veo 3.1 标准版为 0.40 美元/秒,快手可灵 3.0 有声 1080P 为 1.2 元/秒,字节 Seedance 2.0 约 1 元/秒。不过截至发稿,MiniMax 开放平台的官方计费页尚未列出 H3,官方 API 定价还没有正式口径。 开放权重同样停留在承诺层面。官方表述是"计划在未来几天内,在符合相关法律法规的前提下,开放模型权重",给出的理由包括推动开源社区、加速国产芯片适配和方便用户定制,并称 H3 设计初期就考虑了多款现有国产芯片的兼容性。MiniMax 此前在语言模型上已有开源先例:M2 于 2025年10月开源,M3 于今年6月发布并开放权重。H3 若兑现,将是视频生成方向少见的高规格开放权重模型。
榜单进了第一梯队,对手已经不是 Veo
发布当天的 Artificial Analysis 视频竞技场给出了第三方参照。文生视频(带音频)榜上,H3 以 1242 的 Elo 评分列第 2,与第 1 名 Gemini Omni Flash 的 1245 分差距在统计误差之内;图生视频(无音频)榜上以 1351 分列第 2,同样仅次于 Gemini Omni Flash;视频编辑榜以 1130 分列第 1。可灵 3.0 和 Seedance 2.0 的最高档位均排在其后,Veo 3.1 已落到文生视频榜第 11 位。需要注明的是,H3 入榜仅数日,5000 余个样本对应的置信区间明显宽于样本过万的老牌模型,名次尚未锁定。
排在 H3 前面的 Gemini Omni Flash,与 H3 走的是同一条路线。谷歌今年5月在 I/O 大会发布这一全模态模型,输入文本、图像、音频、视频,输出带同步音频的 720p 视频,6月30日以预览版进入 Gemini API,价格约 0.10 美元/秒。它与 Veo 3.1 并行,目标都是把多模态任务收进单一模型。H3 不是这条路上的第一个,它的差异在默认 2K 和开放权重承诺。
单项功能上,H3 大多是追平而非首创。多镜头叙事方面,可灵 3.0 Turbo 单次已支持最多 6 个分镜,Seedance 2.0 也支持多镜头,Veo 3.1 仍是单镜头;动作迁移方面,可灵早有动作控制功能,Seedance 2.0 支持视频参考输入,Veo 3.1 没有对应能力;原生同步音频三家都有,但没有公开资料标明竞品输出是否为双声道立体声,H3 的"原生双声道"是否构成独有卖点,目前无法对照确认。
把统一、价格和开放权重放在一起看,H3 的位置才清楚。默认 2K 是当前独一档,竞品的默认或主力档位普遍在 720P 至 1080P,Gemini Omni Flash 也只输出 720p;开放权重则是谷歌路线上没有的选项。这套组合更接近大语言模型过去两年的竞争方式,而不是视频生成此前的单点功能竞赛。
视频生成开始重复大语言模型走过的节奏
H3 发布说明的变化是:视频生成的竞争焦点正在从"谁的单项功能多"转向"谁能把任务统一进一个模型,并把价格打下来"。MiniMax 不是这条路上的第一个,谷歌 Gemini Omni Flash 今年5月已把统一路线跑通,Seedance 2.0 的全模态参考、可灵 3.0 的 Omni 档位也在合并任务。H3 的位置在于把任务统一、默认 2K 和开放权重承诺组合在一起,并在发布当天拿到了第三方榜单的第一梯队位置。
这对广告、电商等内容生产方是直接的好消息:官方口径下 2K 生成的每秒成本不到主流模型的三分之一,且商用所需的文字呈现、品牌信息控制被作为卖点打磨。对维持高价的闭源模型是压力:Veo 3.1 标准版每秒 0.40 美元,而第三方平台上 H3 的 2K 价格为 0.13 美元/秒。对国产芯片生态也是一个具体信号:头部视频模型开始在设计阶段主动兼容国产芯片,而不只是事后适配。对谷歌来说,Omni Flash 验证过的统一路线第一次出现了开放权重阵营的跟随者。
但结论只能到这里。H3 的榜单位次基于数日的小样本,仍可能漂移;官方 API 定价未出,"不到三分之一"的对照对象不明;权重能否按"未来几天"兑现、开源协议如何,都要等官方下一步动作。在这些落地之前,H3 改变的是定价和发布策略的参照系,生成质量的最终排序还没有定格。
 AI 速览