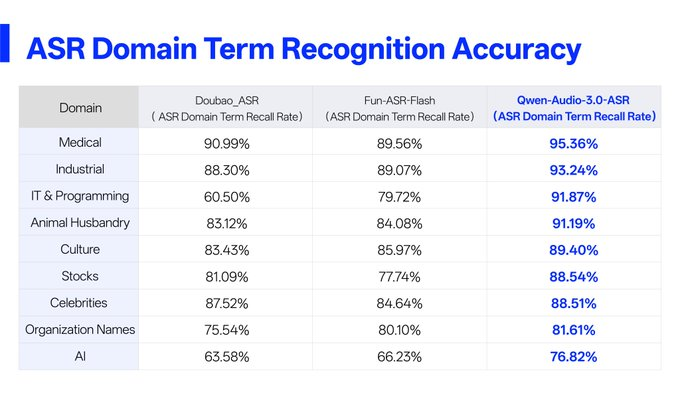
7月31日消息,阿里巴巴正式发布语音识别大模型 Qwen-Audio-3.0-ASR-Flash 系列,包含 Flash、Flash-Streaming、Flash-Filetrans 三个版本,分别面向非实时转写、实时语音识别与录音文件转写。官方模型页显示,该系列支持上下文感知、自定义热词与行业术语识别,能把语音润色为结构化文本,定价 0.00022 元/秒起。
三个版本分工:实时、录音与非实时共用一套能力
三个版本的定位在官方模型页与 API 文档中分开标注。Flash 面向非实时转写,单次处理 5 分钟以内、10MB 以内的音频,官方文档注明不支持 SDK 调用,单价 0.00022 元/秒;Flash-Streaming 走 WebSocket 实时出字,媒体称其理论出字延迟约 300 毫秒,单价 0.00033 元/秒;Flash-Filetrans 面向离线整段音视频转写,采用异步任务加轮询的方式,文档写明支持上下文增强与垂直行业热词强化,单价 0.00022 元/秒。
能力上三个版本共用同一套基础。上下文感知可将此前文本带入转写,官方称支持 5 分钟以内音频的上下文;自定义热词通过 vocabulary_id 绑定词表;语音润色直接输出结构化文本。官方页面还列出覆盖 30 种语言(含官话等七大方言与 20 余种地区口音)、针对古诗词的专项优化,以及标点预测与数字、日期、金额的自动归一化。据当日媒体报道,研究团队从医疗、IT 编程、股票、社会名人等领域持续挖掘专业词汇建设词库。
行业词指标与定价:内部测试口径,与 fun-asr 同价
模型在医疗场景的行业词听中率突破 95.36%,热词听中率在全部测试集达到 90% 以上、多数场景突破 99%;工业术语召回率为 93.24。
定价上,Flash 与 Flash-Filetrans 均为 0.00022 元/秒(约合每分钟 0.013 元),Flash-Streaming 为 0.00033 元/秒。这一价格与阿里云既有 fun-asr 模型相同,并非降价,增量落在行业词与上下文一侧。以各厂商公开价对照,OpenAI Whisper 与 gpt-4o-transcribe 为 0.006 美元/分钟(按当前汇率估算约合 0.04 元/分钟),Google Speech-to-Text V2 标准档为 0.016 美元/分钟(约合 0.12 元/分钟),Deepgram Nova-3 预录档为 0.0077 美元/分钟(约合 0.06 元/分钟),Flash 的价格量级低于三者。
同价换能力:行业词与上下文成为竞争维度
对开发者与企业客户,这次发布的可感变化在接入成本。0.00022 元/秒的价格量级低于 OpenAI、Google 与 Deepgram 的公开价,热词定制与上下文免去了自建词库和二次校对的工作;对国内 ASR 服务商,行业词听中率被放进发布口径做卖点,意味着词库建设从可选功能变成默认能力,垂直场景的识别质量会成为对比的新维度。
与 fun-asr 同价而不是降价,说明这一轮阿里选择的是能力升级:同一价格档位里,行业词、上下文与结构化输出是新增量。这些增量的证据目前只到发布方内部测试为止,95.36%、93.24% 与 99% 这些数字没有第三方复现,官方模型页也未列出,判断竞品差距和实际可用性仍需要独立评测。媒体报道还引用该模型曾以 1.7% 错字率在 Artificial Analysis 上排名全球第一,这一历史成绩未注明测试时间,不构成对本次发布状态的结论。
 AI 速览