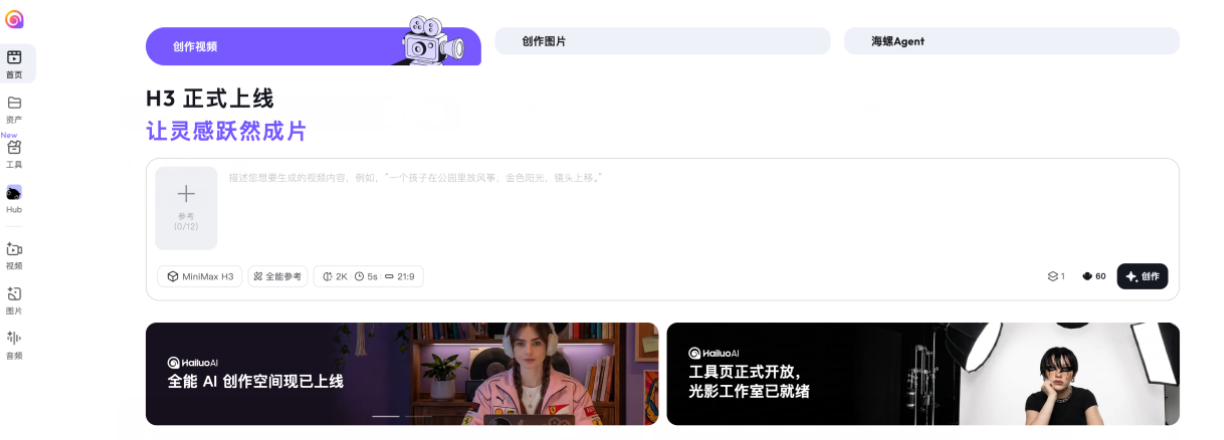
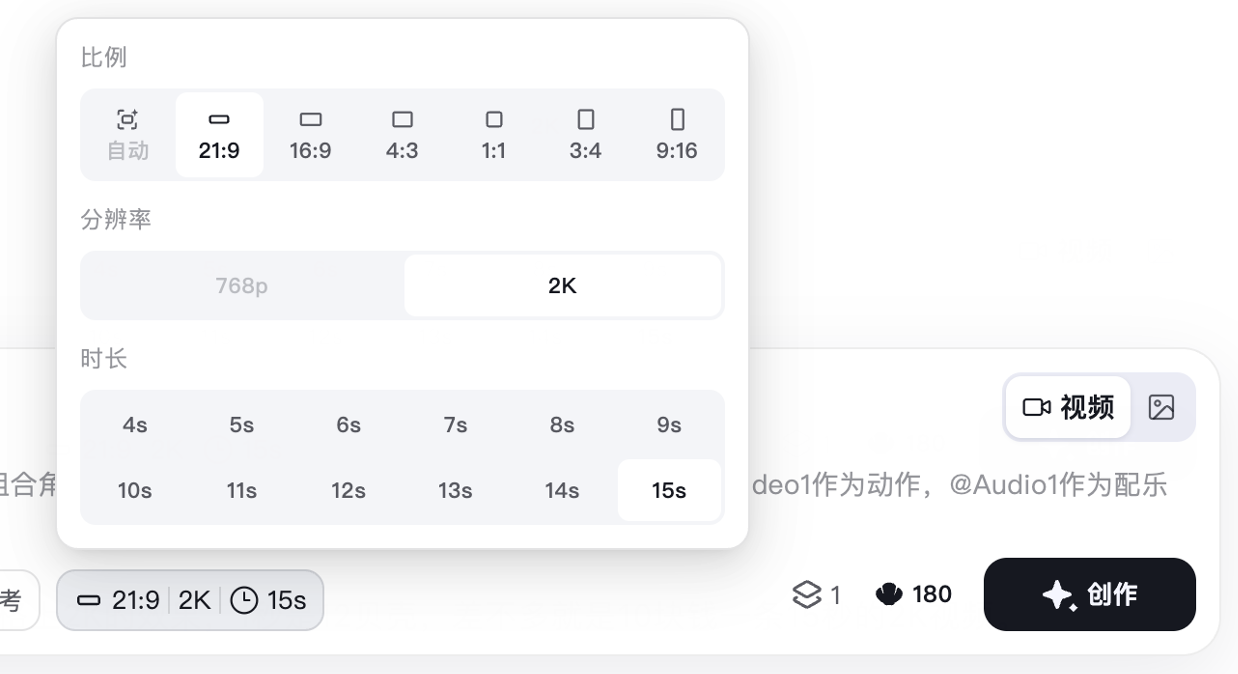
MiniMax H3在线体验最简单的入口就是MiniMax Hub,打开网页选中H3模型,输入文字加参考图片或视频就能直接生成带原声的2K视频,不用装任何软件——这是目前国内全模态生成这块比较能打的一个模型。下面把具体怎么用、它强在哪、跟其他AI视频工具比区别在哪都讲一下。
一、MiniMax H3是个什么模型
H3不是个聊天模型,它是MiniMax(稀宇科技)在2026年7月31日刚发布的通用全模态生成模型,能同时理解文本、图像、视频、声音这几种模态混在一起的上下文,输出的是带原生双声道的音视频,最高能做到15秒2K分辨率。它是Hailuo系列往下走的第三代,前两代Hailuo 01和02分别解决了系统搭建和架构效率的问题,H3这代主打的是把多模态素材揉在一起统一生成。
二、MiniMax H3在线体验的操作步骤
想试玩的话,官方渠道是去MiniMax Hub,登录账号后在模型列表里找到H3,界面上会有Playground这种在线试用区,不用写代码直接在浏览器里操作。
具体到怎么输入,H3支持你同时丢进去参考图片、参考视频、参考音频这几种素材,把它们当成"身份锚点"——比如一个角色的样貌、一个产品的外观、一种视觉风格,通过文字描述清楚它们跟目标视频之间的关系,H3自己去完成这套复杂的跨模态理解和生成。官方举的例子挺直观:"参考视频1的镜头运动方式,让图2里的人物唱歌,歌声参考音频3",这种一句话描述清楚多个素材关系的用法,是H3区别于普通文生视频工具的地方。要注意的是,至少得传一张图或者一段视频作为素材,光传音频不带图像视频是不支持的。
如果你是开发者想接入API,第三方云平台像Atlas Cloud也接入了H3,同一个API key就能调用,跟平台上其他视频、图像、语音模型共用一套调用逻辑,从别的视频模型迁移过来基本就是换个模型字段的事,鉴权和结果获取方式都不用改。
三、MiniMax H3功能优势在哪
H3最大的技术亮点是把2K视频的超分辨率处理方式换了个思路。常规做法是先生成低分辨率画面再套个超分模块放大,H3不这么干,它是让基础模型对自己生成的低分辨率结果做in-context的重新生成,相当于复用H3本身已经具备的生成能力去"重画"一遍,官方说这样能做出传统超分方案做不到的细节效果。
另外它还加了个Caption能力,专门定制了一套全模态理解管线,处理一份素材大概要消耗10万token的推理量,最后精炼出平均4000token左右的描述,这块决定了模型对复杂指令、品牌文字信息呈现的准确度。前期邀测反馈显示,它在指令遵循、文字与品牌信息呈现、视频到视频的动作迁移(V2V Motion Transfer)这几项上表现比较突出,适合广告、电商、产品设计、UI/UX、游戏这类商业场景。
价格这块也是个卖点,官方给出的数据是2K分辨率下每秒价格不到主流同类模型的三分之一,768P分辨率下大概是别家720P价格的一半,第三方平台披露的具体数字大概是2K每秒0.14美元、768P每秒0.10美元,性价比确实拉开了差距。
四、跟其他AI视频工具比,区别在哪
市面上做视频生成的AI不少,可灵、Vidu、PixVerse、国外的Sora这些走的路子基本是纯视频生成,输入文字或图片,输出一段没声音或者声音是后期配上去的视频片段。H3的差异化在于它是"全模态统一生成",图像、视频、声音是在同一次推理里一起处理并输出的,不是先出画面再单独拼音轨,这个原生同步音视频的能力在同类产品里不算普遍。 另外一点是H3在设计初期就考虑了国产芯片的适配问题,官方也提到计划在近期开放模型权重给开发者定制,这跟很多闭源视频模型的封闭生态是不一样的路线,如果你关心自部署或者芯片生态兼容性,这算是个额外的考量维度。
MiniMax H3在线体验说到底就是打开MiniMax Hub选中模型直接试,核心优势是原生同步音视频、in-context超分、多模态素材融合生成外加价格优势,跟纯视频生成工具比起来,它更适合需要图文声音综合表达的商业创作场景,具体效果和定价这类信息变动比较快,动手之前去官网核实一遍最稳妥
 AI 速览