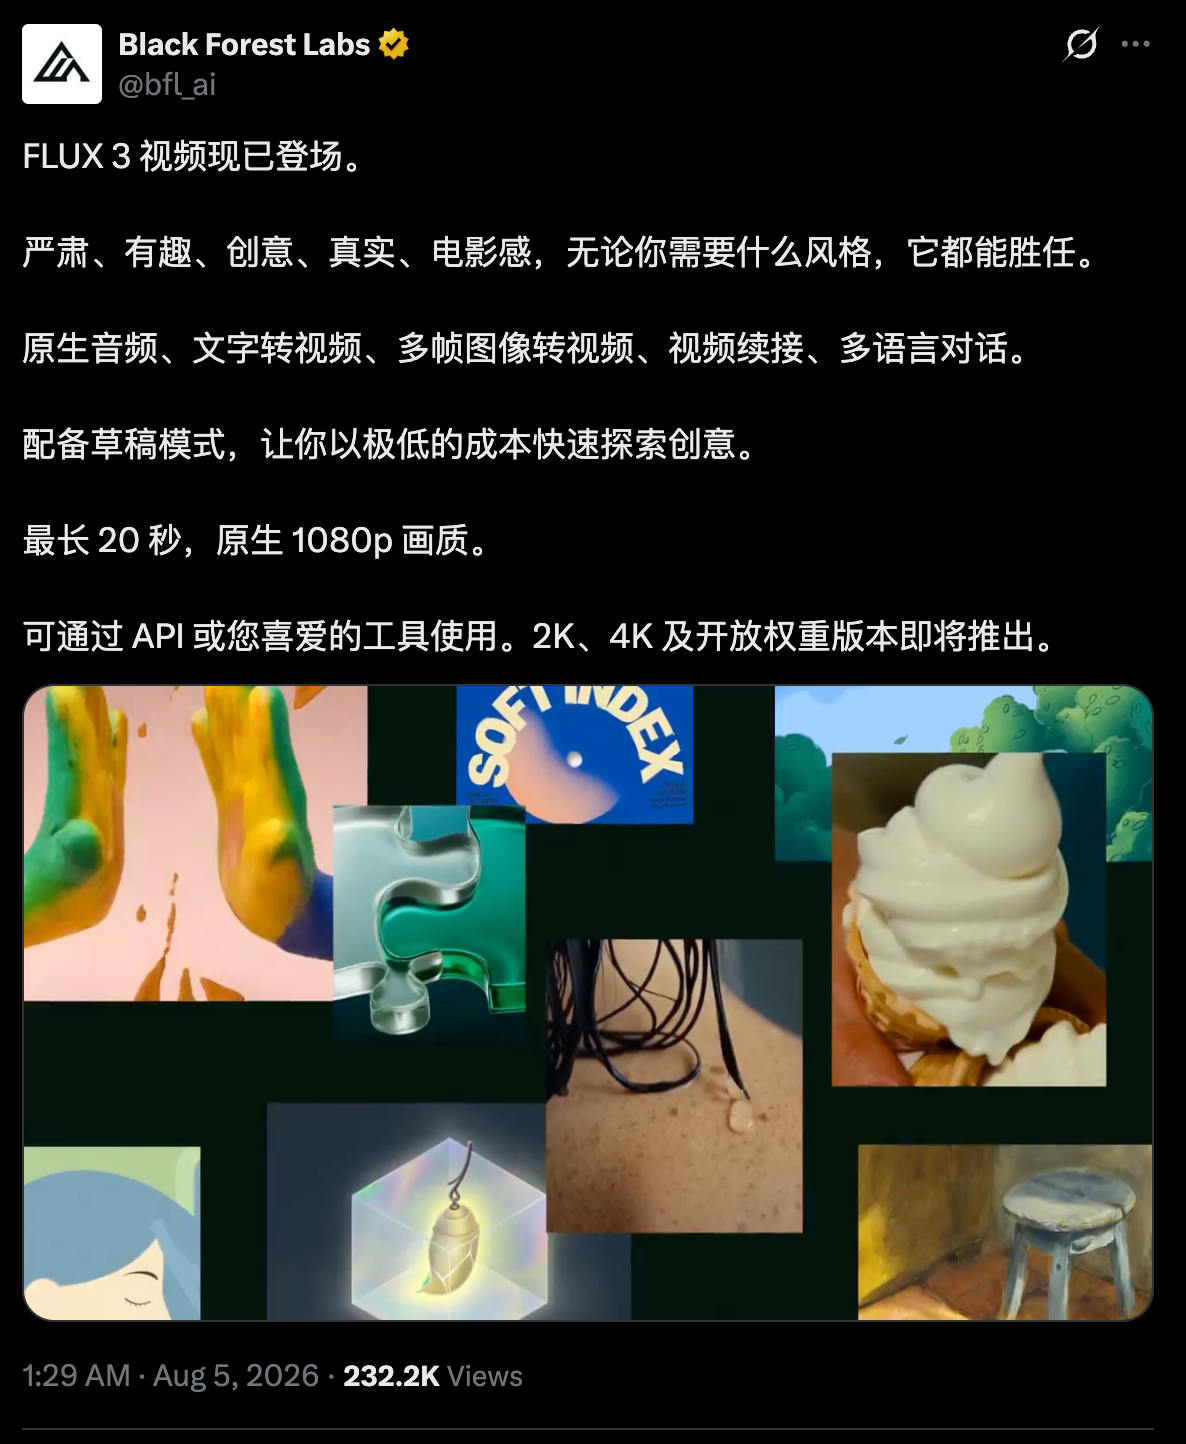
8月5日消息,Black Forest Labs 宣布 FLUX 3 的视频生成能力正式开放,通过 BFL API 与精选合作伙伴提供,官方称这是该能力首次全面可用:单次生成最长 20 秒,画面与音频同步产出,支持多语言对话。此次开放被定位为视频方向的「Part 1: Generation」,后续还有增强可控性等内容。
文生、图生与视频续接
FLUX 3 Video 提供文字转视频与图像转视频两条入口:文字入口按提示词生成场景,官方称模型在生成自然运动、场景逻辑与音频的同时跟随复杂指令;图像入口支持指定起始帧、结束帧或多个关键帧,由模型按序列连接并遵循预期的视觉语言。
视频续接针对已有素材。用户可输入最长 4 秒的既有视频与音频,模型在衔接处延续运动、镜头、对话与音频;单次生成内可创建多个场景与机位,片段可链式拼接为更长的多镜头序列。官方将文档类与短视频教育内容列为适用场景,称模型结合预训练世界知识与实时信息锚定(grounding)。
原生音频与多语言:对白、音效一次成型
所有输出都带原生音频,对话、音效与环境音随画面同步生成,与多数「先出画面、后期配音」的视频模型不同。
多语言方面,公告列出英语(含多种方言)、中文、西班牙语、法语、德语、日语、葡萄牙语、俄语、意大利语、印尼语、土耳其语、印地语、旁遮普语等,并带精确的口型同步。统一模态模型学习的是同一个「潜在现实」的不同投影:图像捕捉空间结构,视频恢复时间维度,音频揭示声学因果,语言把感知连接到指令。
20 秒为一段:720p/1080p 与草稿模式
规格方面,单次生成最长 20 秒,提供 HD 720p 与 Full HD 1080p 两档,其中 1080p 经放大生成。官方未公布帧率。总公告阶段的初步评估以 10 秒、720p 片段进行,GA 版本把单次生成上限提到 20 秒。
草稿模式以较低成本快速生成预览,确认后模型以全质量渲染同一段视频,保持相同的主体、构图与运动。官方将其定位为创意迭代工具,称成本仅为全质量生成的一小部分。截至发稿,官方未公布具体价格。
官方评测:文生视频领先,图生视频与 Seedance 2.0 持平
官方同步给出内部评测。逐项偏好对比中,文生视频对 Runway Gen-4.5 的胜出率为 77%,对 Luma Ray 3.2 为 93%,对 Grok Imagine Video 为 69%,对 Kling v3 Pro 为 60%,对 Happy Horse v1 为 59%,对 Happy Horse 1.1 为 57%,对 Seedance 2.0 与 Gemini Omni Flash 为 52%。 图生视频方向与文生不同:官方称与 Seedance 2.0 持平、超过其余公开模型。这意味着评测并非全面碾压,文生视频占优,图生视频存在追平者。以上均为厂商内部评测口径,截至发稿,第三方实测结果尚未公开。
统一模态主干:从 FLUX.2 到 FLUX 3
FLUX 3 是统一多模态基础模型,图像、视频、音频与动作预测共用一个主干。官方称其构建于 Self-Flow 技术之上,显著扩大计算与数据规模,目标是统一感知、动作与语言预测("Our goal is to unify perceptual, action and language prediction in the same unified model")。
FLUX 3 是 FLUX.2 系列(Max、FLUX.2、Klein)的下一代,官方称图像方向已显著优于早期 FLUX 版本;6 月时 FLUX.2 Klein 已支持在 ASUS ProArt 笔记本上设备端运行。
开放节奏:视频先行,图像与开放权重排队
8 月 4 日的视频 GA 是第一步。FLUX 3 Image 计划于数周后开放 Early Access;开放权重版本 FLUX 3 Dev 已列入计划、尚未发布;动作预测通过精选研究与商业伙伴先行提供,首个合作方向是机器人的 mimic。官方表示,本次只是视频方向的 Part 1,后续会增强可控性。
对创作者与竞品意味着什么
对使用视频生成工具的用户与团队而言,原生音频把画面、对白、音效变成一次生成的结果,省掉后期配音与配乐环节;草稿模式把单次试错成本压到全质量渲染的一小部分,适合先批量探索创意,再对满意的预览做完整渲染。特别是图生方向 Seedance 2.0 追平,则说明竞争白热化。
 AI 速览