一本技术书翻了一遍,笔记做了满满一页,三个月后除了书名什么都想不起来,真要用里面的方法,翻书比重新查资料还慢。GitHub 上有个叫 book-to-skill 的项目,三个月狂澜1.6万颗星,就是冲着这个毛病来的。
book-to-skill工具简介
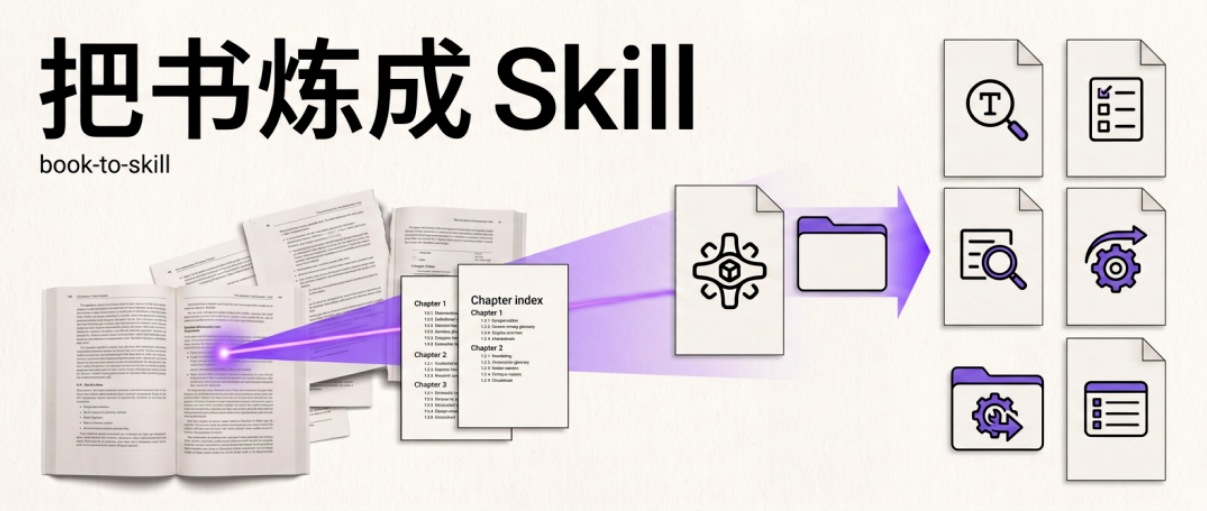
一句话概括:把你自己的书、文档、论文堆,编译成一个 AI agent 能调用的技能(skill)。装好之后敲一句 /book-to-skill ./my-book.pdf,它会把书拆解成框架、决策规则、反模式,还有逐章的文件,官方反复强调这是"结构"不是"摘要"。之后你问到具体主题,agent 只加载对应那一章,基于原文回答,不会瞎编。
它遵循开放的 Agent Skills 标准,同一份 SKILL.md 在 Claude Code、GitHub Copilot CLI、Amp 三个宿主里都能直接用。截至 2026 年 8 月 5 日,仓库已经拿了16.6k颗星、1.8k次 fork,目前仍在GitHub 每日趋势榜,5 月初创建的项目,7 月 27 日还在提交代码,更新节奏不慢。 支持的输入格式挺全:PDF、EPUB、DOCX、TXT、Markdown、reStructuredText、AsciiDoc、HTML、RTF,MOBI/AZW 需要装 Calibre 转一道。
这个Skill适合谁用
这工具不是为了读一次的书准备的。判断标准很直白——一份文档如果你已经翻开过三次,还会翻第四次,它就是候选。
写周报的人可以想想:手头有没有一本方法论的书,每周都要翻出来对照着写?做 PPT 汇报的人,公司是不是有一份品牌规范或者模板手册,每次做页面前都要翻一遍配色和字体规则?处理数据的同事,是不是有份字段定义文档,每次接手新表都要重新确认一遍口径?这些反复被打开的东西,都可以编译成技能,装进 agent 里随时调。
团队场景也一样:内部的架构决策记录、runbook、入门手册,整个 docs/ 文件夹都能折进一个技能,写代码的时候顺手问。研究员手头一堆论文加自己的笔记,也能合并成一个技能,以后有新论文再 fold 进去,不用推倒重做。
book-to-skill安装教程
README 里写了两条安装路径,其中一条是坑,得先说清楚。
直接执行 pip install book-to-skill 会报错——PyPI 上根本没有这个包,README 宣传的这条路目前是断的:
GitHub Copilot CLI 用户对应目录是 ~/.copilot/skills/book-to-skill;如果你想让 Copilot CLI 和 Amp 都能识别,走跨 agent 路径 ~/.agents/skills/book-to-skill。 克隆完先别急着用,跑一次环境自检:python3 scripts/extract.py --check。它会把每种格式该用的提取器列出来,缺什么、装什么都写明白——PDF 这块,pypdf、pdfminer.six、系统级的 pdftotext 三选一装上就够;EPUB 优先用 ebooklib,没装的话自动退回到标准库自带的 zipfile 解析。有博主实测拿 Project Gutenberg 上的《孙子兵法》英译本试过,没装 ebooklib 照样解析成功,13 章一章不差。纯文本、Markdown、reStructuredText、AsciiDoc 这几种格式零依赖,装完就能用。唯一没有退路的是 MOBI/AZW,必须先装 Calibre。
book-to-skill使用方法:编译一次,按需调用
装好环境,接下来可以参考下面这段提示词:
第一步,把文件指给它,/book-to-skill ./my-book.pdf,也可以指一个文件夹、一个通配符,或者一份文件清单。
第二步,它把内容蒸馏成一套技能文件,生成在 ~/.claude/skills// 目录下:SKILL.md 放核心心智模型加章节索引,大概 4,000 token;chapters/ 目录下每章一个文件,每份约 1,000 token,按需加载;glossary.md 收录全部关键术语,按字母排序并标注章节出处,约 1,500 token;patterns.md 整理技巧、算法、设计模式,约 2,000 token;cheatsheet.md 是决策表和速查规则,约 1,000 token。 第三步,日常用的时候敲 /my-book-slug 加上你想问的主题,比如 /my-book replication,agent 只读对应那一章,基于原文回答。
这套设计省下的账,项目自带工具能算。拿《孙子兵法》做过实测:全书 81,278 token,整本塞进上下文的方式每轮都要重复计费这么多;agent 临时翻目录再翻章节的"发现循环"方式,一次性成本 5,440 token;book-to-skill 编译后只要 5,000 token(核心 4,000 加对应章节 1,000)。对比整本塞上下文,省了 16.3 倍。不过这本书章节短,相对"临时翻书"的优势只有 1.1 倍——官方在章节更长的书上测过,Think Python 2、Working Backwards、AI Engineering 三本书,相对临时翻书的优势能到 2.4–15.6 倍,相对整本塞上下文稳定省 24–51 倍,章节越大优势越明显。
编译本身要花钱,官方按 Claude Sonnet 4.5 的价格算过:Think Python 2 约 0.88 美元,Working Backwards 约 0.96 美元,Pro Git 约 1.23 美元,Moby-Dick 约 1.42 美元。一本书大概一美元出头,只花一次。 这工具不是万金油,读一次就扔的书没必要折腾,章节短的书也省不了多少 token。但你要是有一两本翻烂了的工具书,或者一堆天天要查的内部文档,花一美元编译一次,之后每次对话只付几千 token,这笔账划算。
 AI 速览