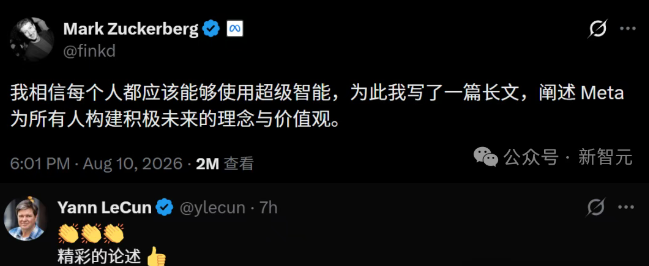
2026 年 8 月,Meta 超级智能实验室同步释放两大行业重磅动作:正式开源 30B 参数的智能体模型 Muse Glimmer,支持消费级显卡与 MacBook 本地离线运行;CEO 马克・扎克伯格发布《未来属于每个人》万字长文,直指闭源 AI 阵营的 “末日论叙事” 与权力垄断,提出 “超级智能属于所有人” 的核心主张,以技术开源 + 理念输出双线冲击当前大模型行业格局。
一、技术破局:30B 大模型落地消费级个人设备
长期以来开源模型存在明显矛盾:能力强的大模型显存门槛极高,普通电脑无法运行;能本地跑的小模型,智能水平难以支撑复杂任务。Muse Glimmer 的核心目标就是打破这一僵局,实现高性能智能体完全离线、本地运行,兼顾隐私安全与使用便捷性。
为了将 30B 模型塞进个人设备,Meta 采用两项核心技术。
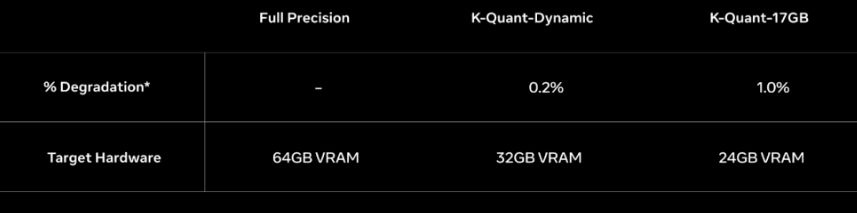
一是4-bit 极致量化压缩,将原本需要 55GB 以上显存的模型权重压缩至 20GB 以内,且智能体任务性能几乎无衰减,24GB 显存显卡、32GB 统一内存的 MacBook 均可流畅运行,还能预留空间支撑视觉编码器与上下文缓存。
二是DFlash 投机解码技术,内置轻量草稿模型预判生成内容,再由主模型并行验证,在不损失质量的前提下,RTX 5090 上生成速度提升 3.1 倍,彻底解决本地大模型生成卡顿的痛点。
二、能力定位:旗舰蒸馏的原生智能体模型
Muse Glimmer 并非普通对话大模型,而是专为智能体工作流优化的端侧模型,由 Meta 顶级闭源模型 Muse Spark 经过逻辑蒸馏训练而来,完整继承了旗舰模型的核心能力。
它具备五大核心智能体能力:
端到端任务执行,在代码开发、资料检索、问题排查等复杂测试中表现优异;
精准工具调用,可自主判断何时使用计算器、检索本地文件或运行代码;
失败自恢复能力,遇到报错不会中断,可自动诊断问题、调整参数重试;
长程多步推理,能制定连贯执行计划,不会中途遗忘任务目标;
多模态理解,可直接解析截图、图表与文档。
在同量级基准测试中,其综合表现与 Gemma4-31B、Qwen3.6-27B 持平,智能体专项操作表现突出。更关键的是模型采用Apache 2.0 开源协议,个人与企业均可免费商用,目前权重已上线 Hugging Face,后续将全面接入 Ollama、LM Studio 等主流本地运行工具。
三、理念交锋:扎克伯格反对 AI 权力集中
万字长文中,扎克伯格未直接点名竞品,却系统性反驳了闭源阵营的核心叙事,成为本次发布最受关注的部分。
首先是抨击 “AI 末日论” 与垄断逻辑。他指出,宣称 AI 极度危险、只能由少数精英公司掌控的观点本身存在固有缺陷,历史上从未有绝对权力能带来持续安全。以超级 AI 律师、AI 网络安全为例,少数人掌握是灾难,全民普及反而会实现权力制衡,真正的安全来自分散而非垄断。
其次是重新定义 AI 对齐标准。他批评部分厂商将公司价值观强加给用户,以 “道德” 为由拒绝合理需求;Meta 主张 AI 应当与用户的个人目标和价值观对齐,而非与企业教条对齐,并承诺为个人智能体提供类似端到端加密的完全私密模式。
最后是公开反对过度 AI 监管。他明确支持模型蒸馏技术,认为从已有模型中学习是开源生态的核心运转逻辑,限制蒸馏与训练数据会削弱美国 AI 生态竞争力;同时提出折中方案,不限制开源模型发布,但实验室可向政府提前分享训练中间检查点。
四、行业影响:重构开源 AI 商业逻辑
Meta 本次动作之所以引发行业震动,核心在于其商业逻辑与闭源厂商完全不同 ——Meta 无需依靠售卖 API 盈利,1450 亿美元的基础设施投入可通过硬件与生态回收成本。 免费商用的 30B 智能体模型,会直接挤压中小开源模型的商业空间,也会对云端低价 API 形成替代。
对开发者与企业而言,本地可运行的高性能智能体意味着私密代码、敏感数据无需上传云端,大幅降低合规风险;对整个行业而言,它推动超级智能从云端垄断走向端侧普及,让个人设备也能承载复杂 AI 任务,进一步加速 AI 去中心化的发展趋势。
 AI 速览