你要是也在为多个Agent协同时的上下文污染头疼,答案可以先划重点:TencentDB Agent Memory这次上的Team Memory功能,把单个Agent"记住我说过什么",升级成了一支Agent团队"共享经验、互相传承",这才是真正解决组织学习问题的路子。
这个项目最近涨得挺猛
5月初写过一篇聊Agent记忆系统该记什么的文章,里面分析过腾讯这个开源项目,那时候刚开源没多久,GitHub才2.6k Star。前两天又打开看了一眼,已经涨到接近20k了,新增了Skill、Wiki、CodeGraph和Team Memory这些功能,开始支持团队级的Agent共享记忆。
多Agent协同,难的从来不是单打独斗
写Codebuddy NPC那会儿就聊过一个问题:AI Coding时代单个Agent能力挺强,但团队协作起来很麻烦,核心就是多Agent协同这块。大多数人的做法是把所有东西丢进一个大项目,让Agent自己读代码读文档搜历史,简单是简单,但项目一大问题就明显了——同一份背景被不同Agent反复读取总结,Token在无限消耗;上下文超过256k之后不少模型能力会衰减,跟当前角色无关的资料进太多,关键约束反倒容易被忽略;新旧需求混一起,模型也未必分得清哪个更有用。一股脑塞给每个Agent,上下文污染基本是躲不掉的。
Team Memory拆成两层来解决
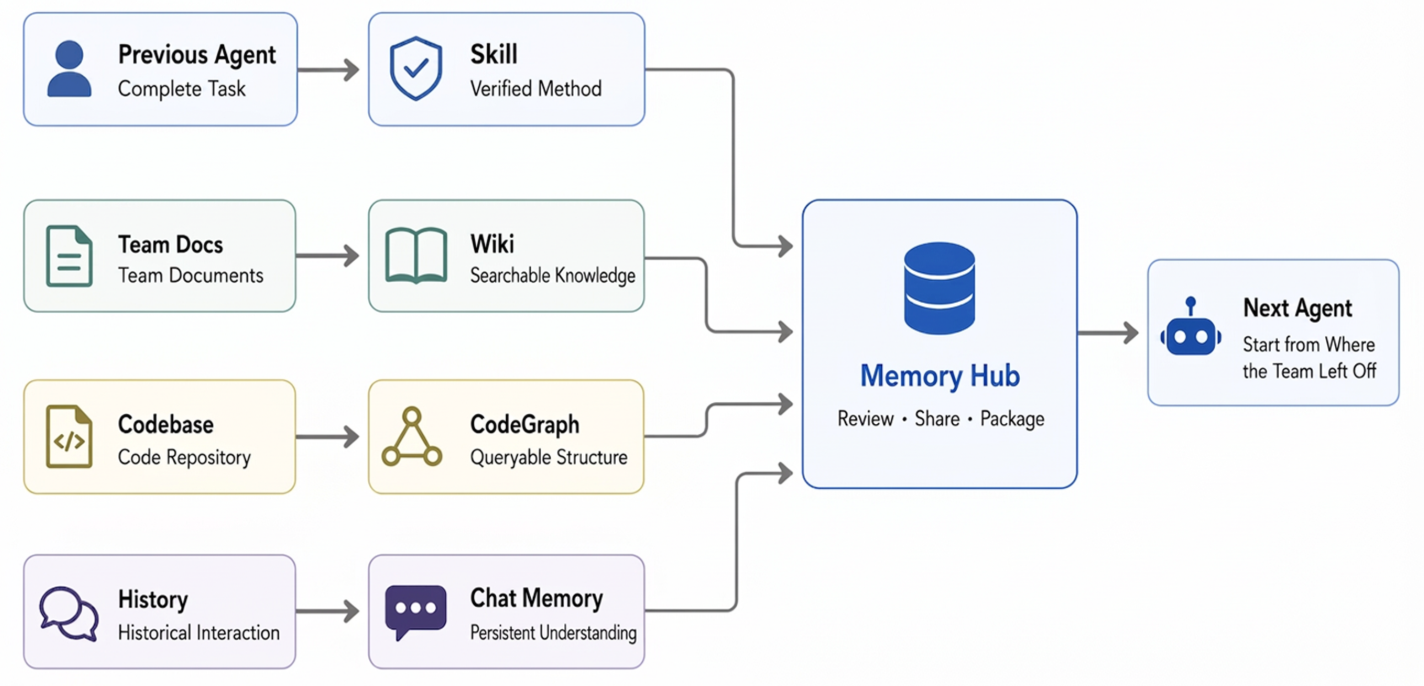
一层是记忆内容层,把信息整理成Chat Memory、Skill、Wiki和CodeGraph;另一层是记忆控制层,管Team、Agent、权限、版本这些。Chat Memory还是L0到L3那套分层——原始记录、原子记忆、场景记忆、长期画像。跑通的操作流程能整理成Skill,写清楚适用场景、触发边界、执行步骤和验证规则;项目文档能组织成Wiki,Agent能顺着页面链接去查;代码交给CodeGraph,保留文件、符号、调用关系和影响路径,帮Agent弄明白改一处可能牵动哪里。
具体怎么用
环境安装不复杂,clone仓库、复制.env文件、填好LLM API Key就能跑起来,一组模型参数管记忆和Wiki的抽取整理,另一组给Agent请求做代理。嫌麻烦的话直接甩给Claude Code、Codex这类工具帮你装,缺Key了它会问你。装好之后在Memory Hub里建Team,加成员加Agent——比如给一个排版网站项目配三个角色,一个读资料梳理需求,一个改代码交付页面,一个负责检查。角色权限可以自定义,不设也能用,但角色分清楚一点,后面分配记忆时更好判断该给谁看。已有项目也能直接导入,代码库绑Git仓库生成CodeGraph,本地文档上传后生成Wiki(这一步看内容量,得等一会儿)。 用Claude Code同步chat memory的话,配好Agent Memory给的url和key就行,启动时会问要不要关联团队资产、关联Agent和Task,选完自动带上之前的相关上下文。做过一次"给公众号排版引擎加新主题"的任务后,管理后台的Skill里真的自动多了一条对应的技能条目——把刚才的开发过程归档成了可复用流程,下次加新主题不用再摸索一遍。用久了chat memory里还会攒下你的技术风格偏好,比如之前定了用SQLite存数据,后面要接入新数据库存素材时,它会提醒你之前的选择,让你自己判断要不要沿用。团队攒下的Chat Memory和Skill默认不会对所有人开放,得用户主动分享或分配给对应Agent才行,这点做得算是比较克制,不会一股脑灌给团队所有人。 单个Agent的记忆解决的是连续性问题,Team Memory这次要解的是组织学习问题——好方法能被提炼、走过的弯路能留下记录、经验能按角色流动、过期内容也能被收回,一支Agent团队才算真的成了团队。模型决定这一轮能走多远,记忆系统决定的是这支队伍走过的路和犯过的错,会不会重蹈一遍。
 AI 速览