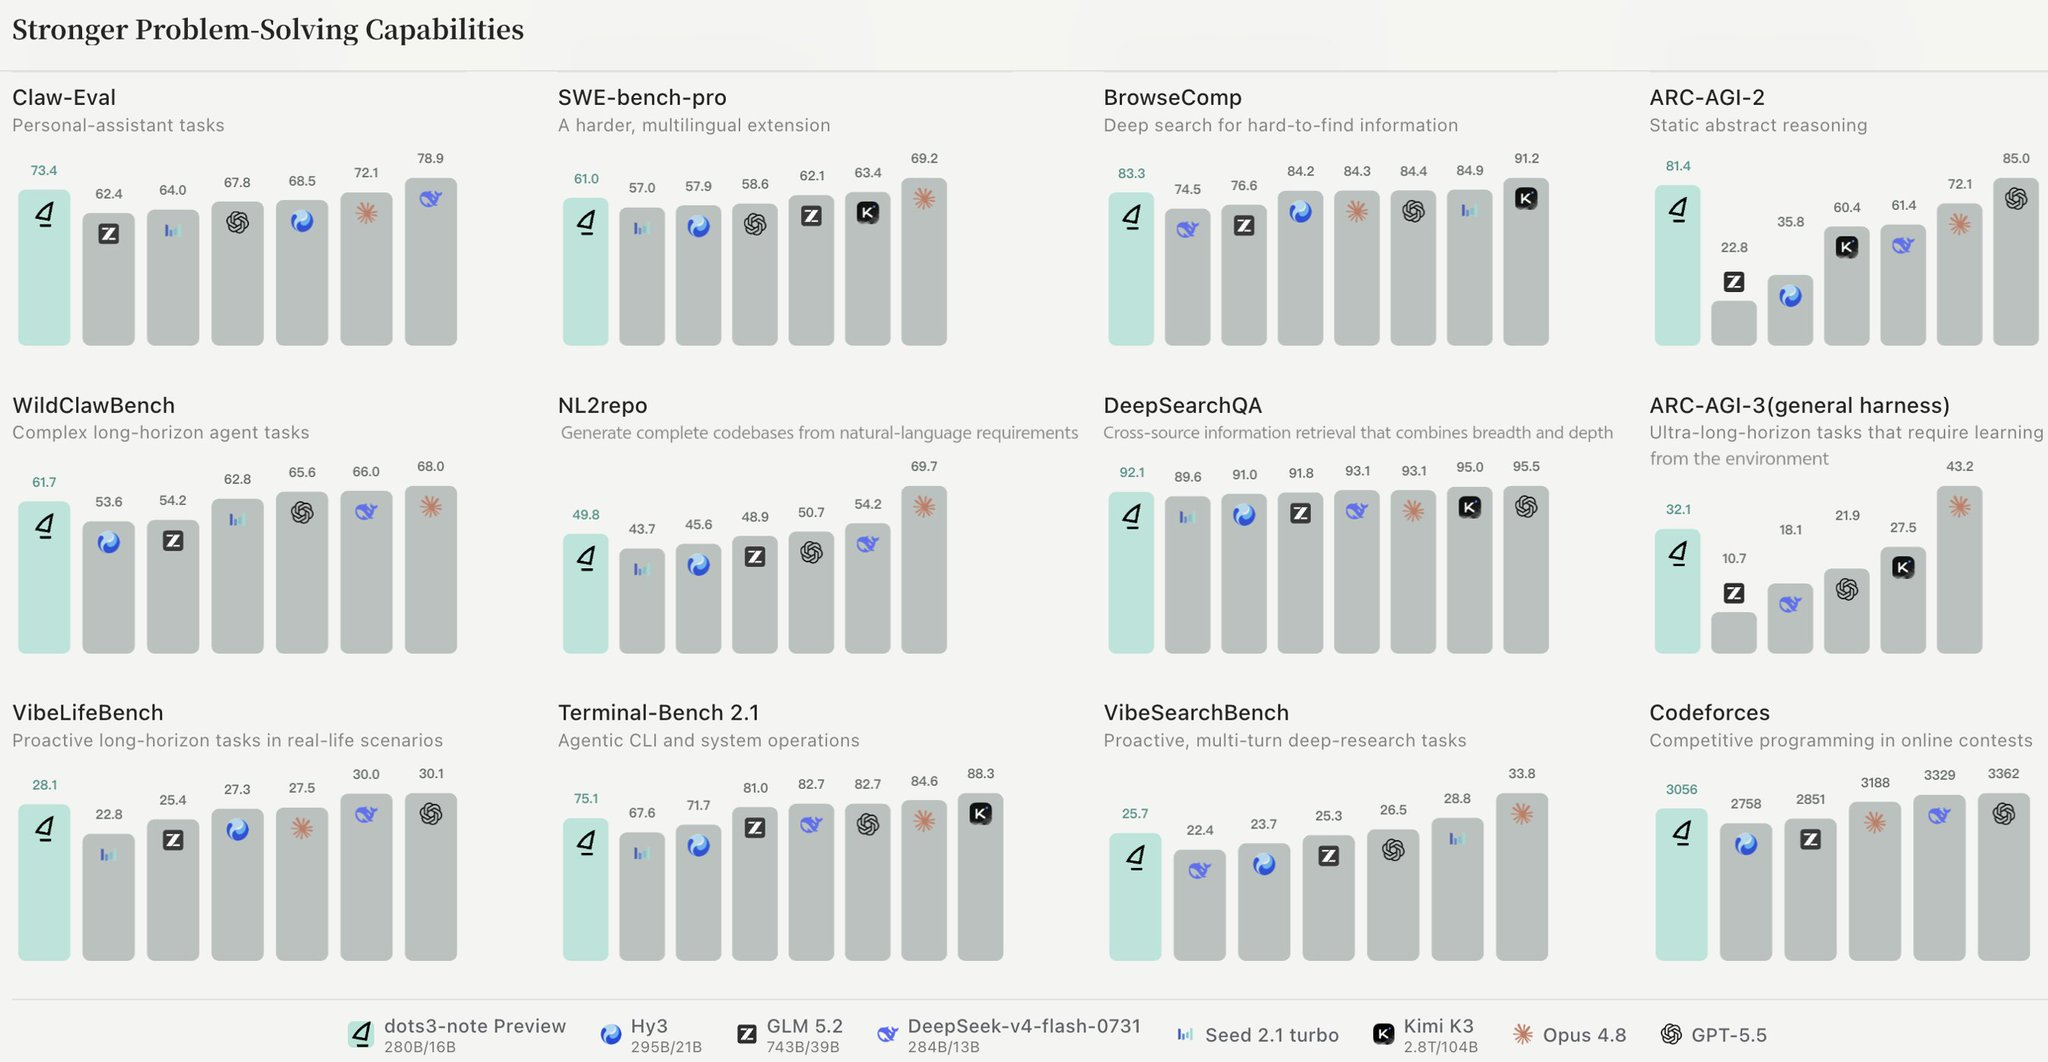
8月15日消息,小红书旗下 Dots 模型实验室(Dots Lab)开源 dots3-note preview。这是 dots3 家族首个开放权重模型:280B 总参数、16B 激活参数的 MoE 架构,512K 上下文窗口,支持文本、图像、视频、音频输入并输出文本,采用 Apache 2.0 许可。与模型一同发布的还有新的强化学习方法 TEMPO,以及 VibeSearchBench、VibeLifeBench 两个面向真实场景智能体的开源评估基准。
dots3-note preview:280B/16B、512K、多模态
dots3-note preview 是 dots3 家族中最轻量的成员,定位为长程开放任务的智能体模型。官方 GitHub 显示,模型采用多模态 MoE 架构:256 个路由专家加 1 个共享专家(top-8 路由),1 个稠密层加 45 个 MoE 层,隐藏维度 5120;注意力由 13 个 DSA(稀疏注意力)层与 33 个 SWA(滑动窗口注意力)层组成;视觉编码器为 7B 总参的 MoE ViT(1.2B 激活),音频编码器为 800M 稠密模型。权重在 Hugging Face 与魔搭上提供 BF16 与 FP8 两种版本,可通过 SGLang 或 vLLM 在单台 8 卡节点上部署,vLLM 已提供原生支持。
模型优化的任务类型包括:通用知识与指令遵循、数学与逻辑推理、工具使用与多步 Agent 工作流、需要探索与记忆更新的交互任务、代码生成,以及图像、文档、图表、音视频理解。官方演示了它完成旅行规划、装修筹备、备婚、店铺运营等长程任务的场景,包括在游戏 Slay the Spire II 中推进到第 33 层、从零解出 ARC-AGI 3(320 步)、端到端构建一个 visionOS 应用(12 个 Swift 文件、1876 行代码)。这些属于官方演示,并非标准第三方评测。
TEMPO:解决长程轨迹的强化学习信用分配
与模型同步公开的 TEMPO 是一种新的强化学习方法,全称 Test-time-scaled Value Estimation with Macro-step Policy Optimization(测试时扩展价值估计与宏步策略优化)。它针对的问题很具体:长程智能体任务单次运行可能超过 10 小时,无价值强化学习(如 GRPO)只在轨迹结束时收到奖励信号,无法进行细粒度信用分配;而 PPO 风格的价值网络做单次固定成本的单次前向,又无法跟上智能体在推理与工具调用上的复杂度。
TEMPO 的解法是把轨迹拆成宏步(macro-step),每个宏步包含若干轮智能体与环境的交互;在每个宏步结束时,模型从 actor 切换为 critic,利用推理、工具调用与测试时扩展来估计当前状态到未来的回报。这样长程任务的价值估计随测试时计算增加而改善,解决了信用分配问题。
VibeSearchBench 与 VibeLifeBench:暴露真实场景短板
VibeSearchBench 与 VibeLifeBench 是两个面向真实场景智能体的开源评估基准,与模型权重一并开放。Dots Lab 推出它们的意图,是让社区能衡量前沿智能体在真实长程任务中的表现——这类评测长期缺失,也是长程 Agent 能力被高估的原因之一。
背景:IMO 满分之后的开源动作
dots3 家族此前以数学能力闻名。7月25日,小红书宣布其内部模型 dots-note-3.0 在第 67 届 IMO(国际数学奥林匹克)官方评审中拿下满分 42/42,超过此前 AI 最佳成绩(Gemini Deep Think 的 35/42),且仅 7 名人类选手同分、金牌线为 29 分。需要说明的是,这一成绩经官方评审但由公司自行公布,采样与访问未被独立审计;同期另有其他模型据称也达到 42/42。dots3-note preview 并非那个数学旗舰,而是家族中更轻、面向长程 Agent 的开放权重版本。 另据媒体报道,dots3-note preview 的架构与 DeepSeek-V3.2 相关(稀疏注意力与滑动窗口注意力混合加多 token 预测模块),该说法属于媒体分析。此外,模型权重实际在 8月6日 就因 vLLM 的一笔 pull request 提前泄露了约 8 天,8月14日 才正式发布。 观察:开源的不只是模型
dots3-note preview 值得注意的地方,在于它把模型、训练方法与评测基准作为一个整体开源。Dots Lab 没有只放权重,而是同时给出 TEMPO 方法说明与两个真实场景基准——对长程 Agent 这个"评测严重不足"的领域,这相当于把衡量尺子也交了出来。
对 Agent 开发者,这是可复现的基准与可部署的开源模型;对长程 RL 研究,TEMPO 提供了一种处理超长轨迹信用分配的新思路;对行业,VibeSearchBench 与 VibeLifeBench 的出现本身就在提醒:前沿智能体的真实场景能力仍缺少可靠度量。需要看到的边界是:dots3-note preview 处于预览状态,官方演示场景并非标准评测,"IMO 满分"属于另一型号且为公司自报。Dots Lab 的开源动作方向清晰,但模型的真实长程能力,要看独立评测与社区在 Vibe 基准上的复现结果。
 AI 速览