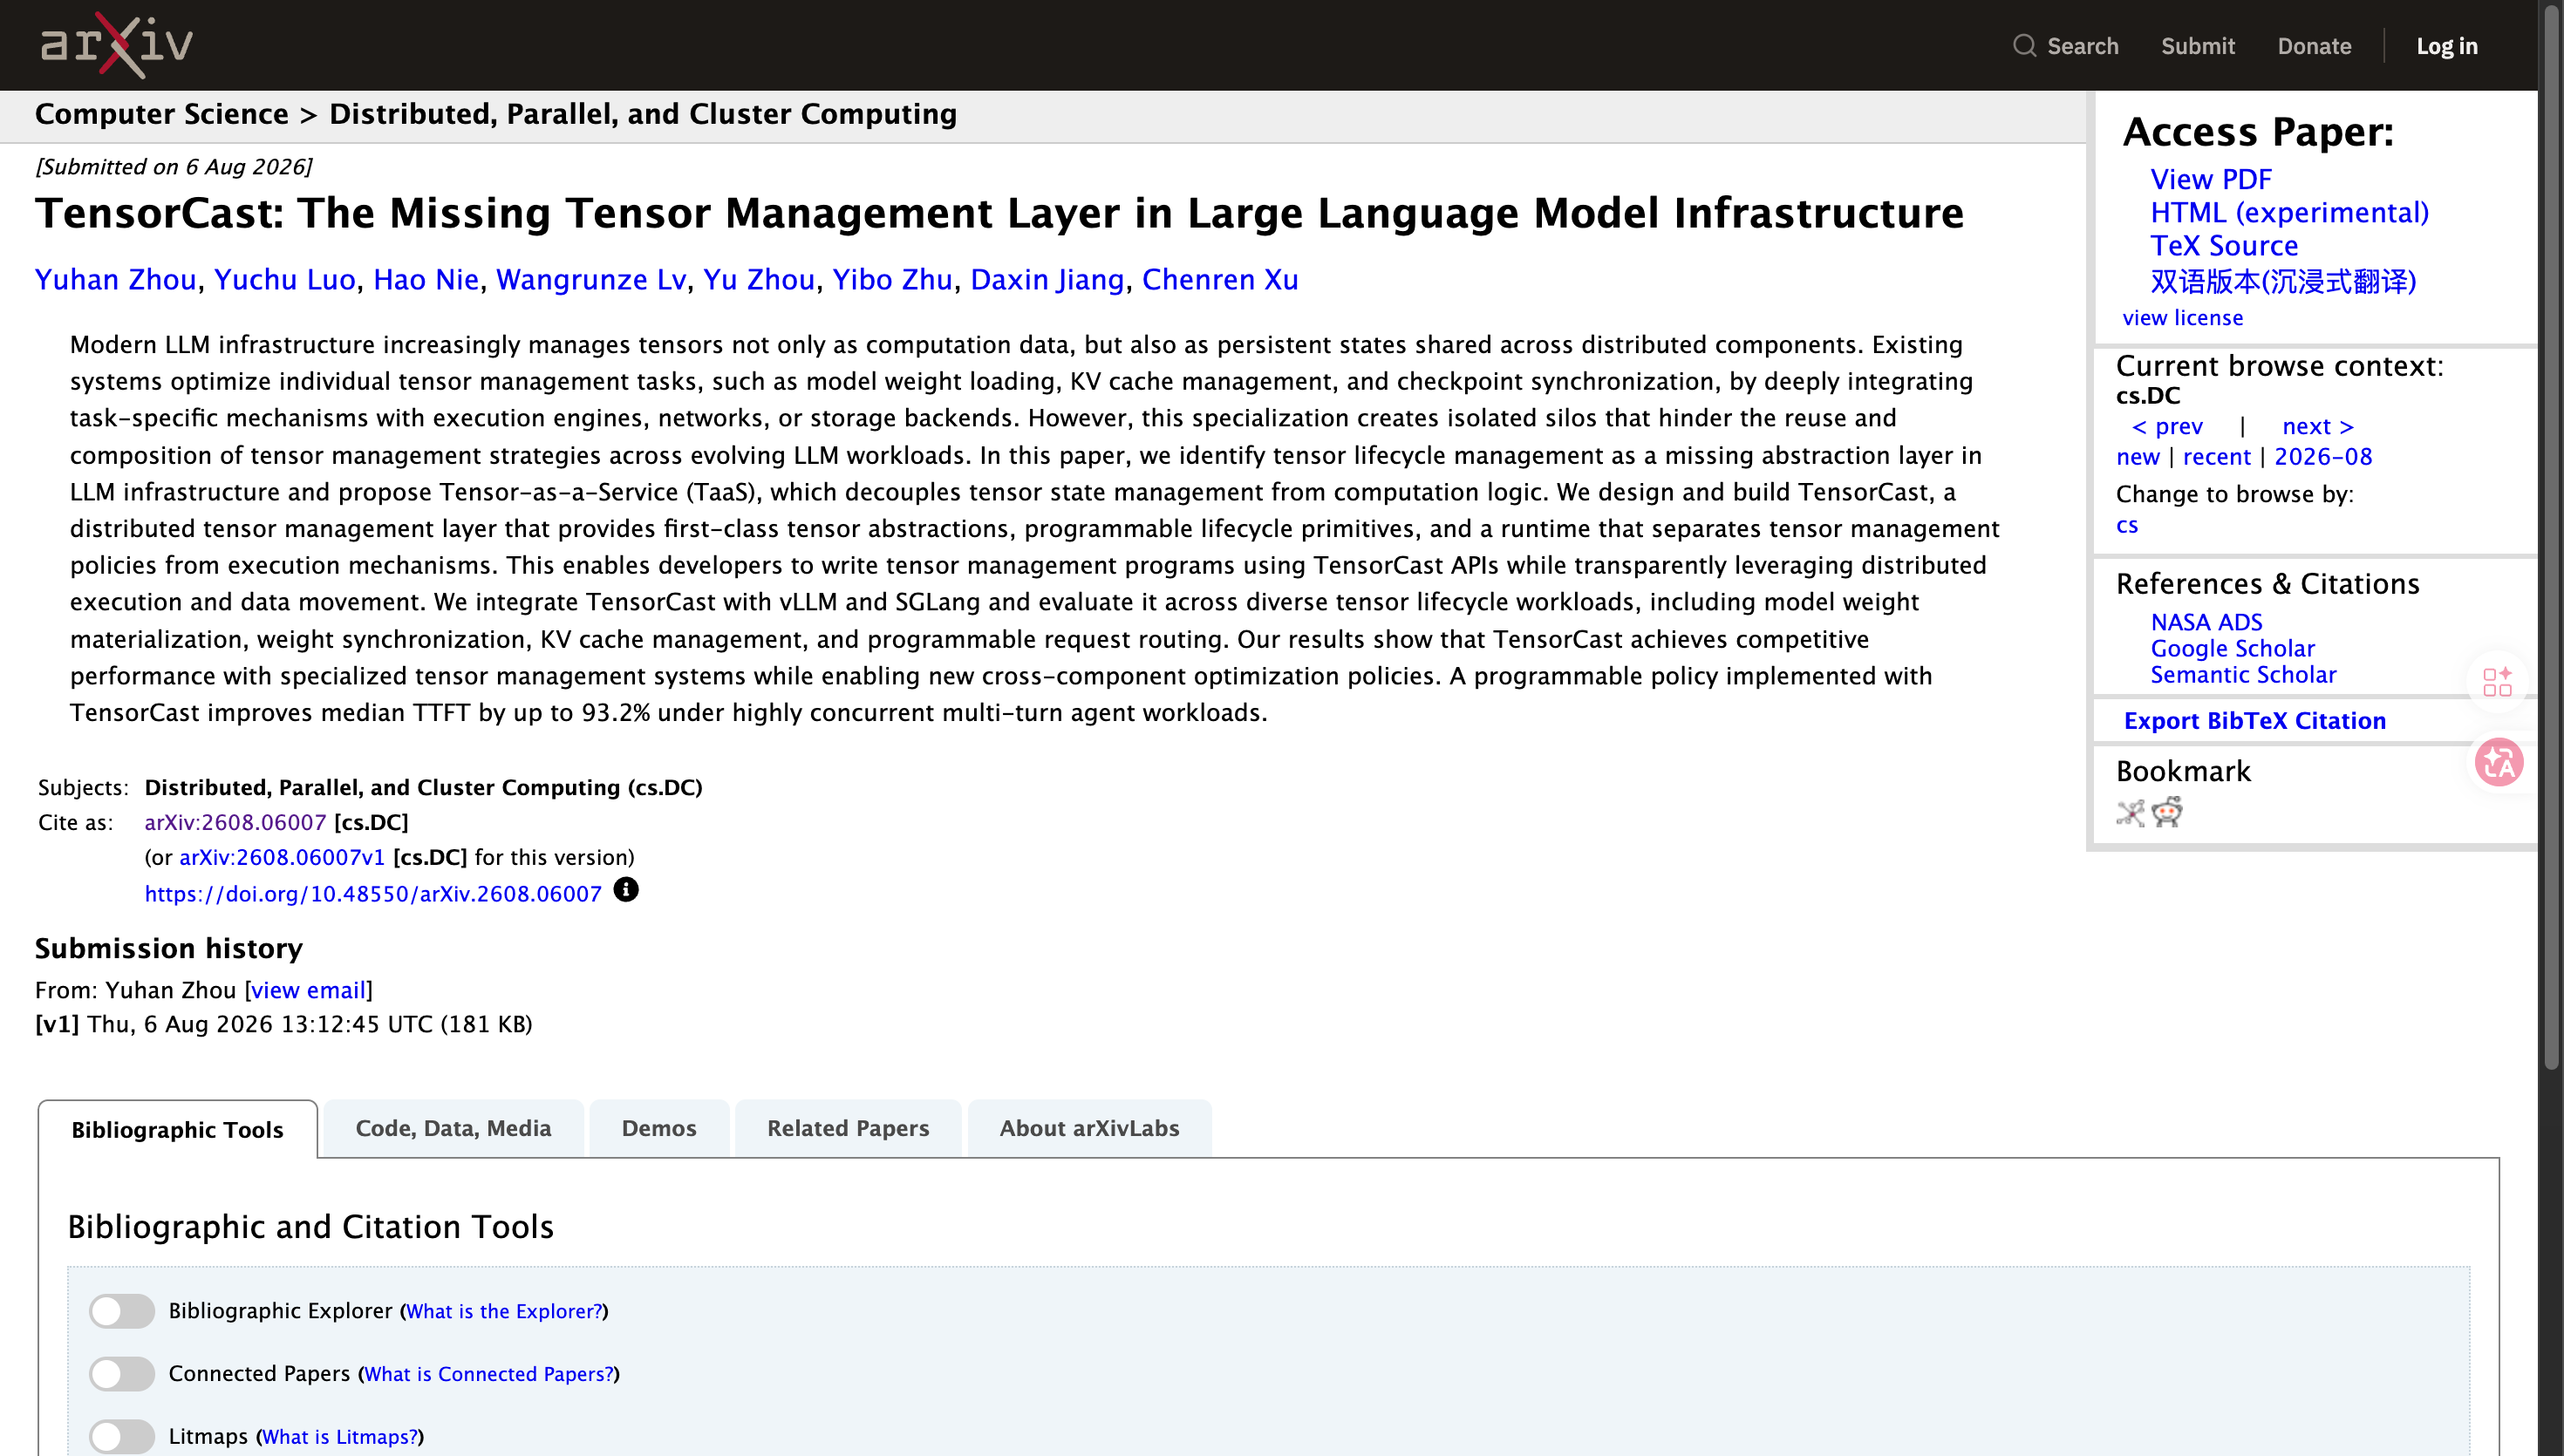
8月17日消息,北京大学与阶跃星辰(StepFun)、北京邮电大学联合发布论文,提出 TensorCast——面向大语言模型基础设施的张量管理层。其核心思想是「张量即服务」(TaaS):把模型权重、KV 缓存等张量状态的管理与计算逻辑解耦,让服务「加载一次、随处使用」。论文实验显示,在高并发多轮智能体工作负载下,中位数 TTFT(首字延迟)最高可降低 93.2%。
张量管理为什么成了基础设施的缺口
论文把问题定位在现代 LLM 基础设施的一个结构缺口上。模型权重、KV 缓存、checkpoint 这些张量,已经从临时的计算数据变成跨节点、跨组件共享的持久化状态。但现有系统各自为政:权重加载、KV 缓存管理、checkpoint 同步分别深度绑定在执行引擎、网络或存储后端里,形成互相隔离的纵向烟囱。改一个调度策略,往往要同时动调度器、缓存系统与执行引擎,跨组件的组合优化也很难表达。
论文的主张是,张量生命周期管理应当成为 LLM 基础设施中一个独立的抽象层,像计算、存储、网络一样被统一管理。
TaaS 的核心设计:张量是一等公民
TaaS 的设计围绕三层展开。第一,张量被赋予一等公民地位:独立的身份、所有权与生命周期语义。第二,提供可编程的生命周期原语——识别(Identify)、放置(Place)、移动(Move)、转换(Transform)、物化(Materialize)等可组合操作。第三,策略与机制分离:开发者用普通程序编写张量管理策略,分布式运行时透明执行,数据面通过 RDMA、零拷贝与流水线做点对点传输,避免控制面成为瓶颈。
落地形态上,TensorCast 已开源并提供 vLLM 与 SGLang 集成,官方文档定位为「高性能分布式张量层」,支持通过 Store Daemon 与 Global Store 在本地或分布式进程间共享张量,GPU 场景走 CUDA IPC 零拷贝映射。
效果数字与边界
论文报告了三组实验结果。可编程请求调度器针对高并发多轮对话 Agent 场景,联合平衡实例负载与 KV 缓存局部性并自动迁移会话状态,中位数 TTFT 最高降低 93.2%。弹性扩容场景下,实例启动(模型加载)时间相比常见分布式文件系统最高降低 228.6 倍(Qwen3-235B-A22B)。KV 缓存接入 SGLang HiCache 后,达到专业系统 Mooncake 相当的性能。
需要说明的是,这些数字来自论文自测,且绑定特定场景与模型:93.2% 针对高并发多轮 Agent 负载,228.6 倍针对弹性扩容的模型加载路径。它们证明的是「张量管理解耦后组合优化可行」,不是所有负载下的通用增益。
张量成为基础设施的一等资源
这篇论文的观察点不在单个数字,而在抽象本身。张量成为一等公民后,负载均衡、KV 缓存局部性、会话迁移这些策略可以写成普通代码自由组合,而不是被锁死在某个系统的实现里。论文选择高并发多轮 Agent 场景做 93.2% 的演示,本身也说明 agent 这类动态负载正在倒逼基础设施层给出新抽象。
TensorCast 目前是研究级发布,代码仓库仍处早期(GitHub 42 个 star,最近更新在 6 月),论文与开源之间存在时差;「达到 Mooncake 相当性能」也是论文口径。它是否会被 vLLM、SGLang 生态广泛采纳,还要看社区验证与后续迭代。目前能确认的,是张量管理作为独立抽象层这一方向,有了来自中国团队的开源落地。
 AI 速览