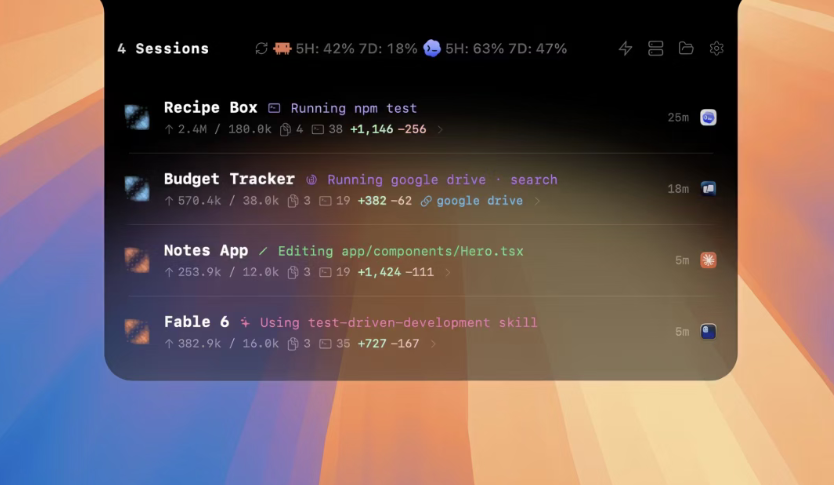
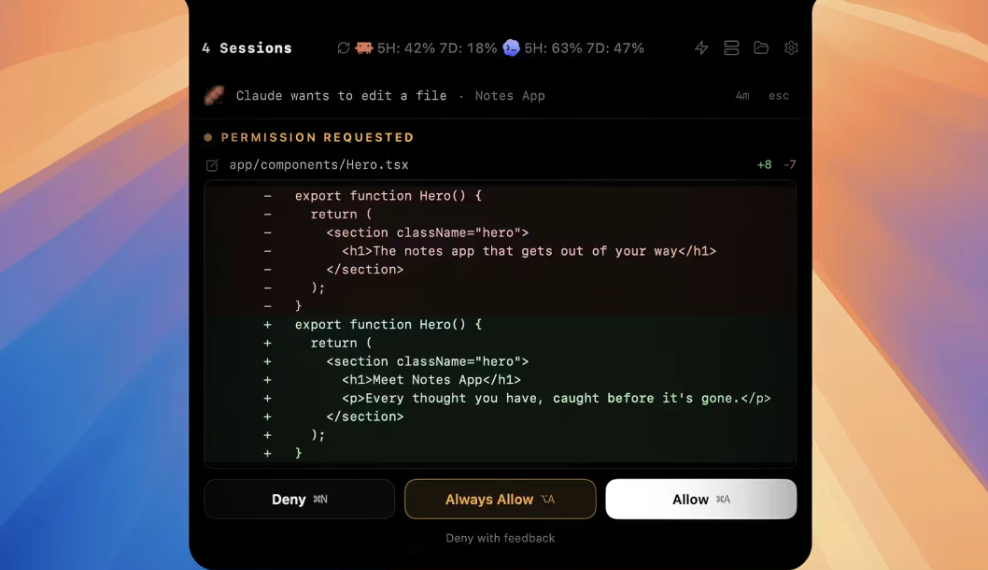
你要是也在开发AI Agent,八成经历过这种崩溃时刻——不是写代码难,是调Bug难,你根本不知道它中间经历了什么。这篇聊聊AgentPeek,一款专门盯着Agent执行链路的调试工具,核心就一句话:把Agent的运行过程变成一张你能看懂的流程图。
先说说这个坑有多深
你精心设计了一个Agent工作流:接收需求、拆解任务、调用工具、返回结果。测试通过,信心满满上线,然后用户反馈来了——"它给我返回了一个完全不相关的结果"。你打开日志,面对的是几十层嵌套的JSON、散落的LLM调用记录、看不出先后顺序的工具执行快照。你试图还原Agent的"思考过程",结果整个过程就像一条没有路标的迷宫,你知道它进去了,但不知道它在哪拐错了弯。
为什么Agent调试这么难
传统调试有成熟的三板斧:指标、日志、链路追踪。但Agent的运行天然不是确定性的,同一段Prompt、同一个模型,跑两次可能走出完全不同的路径。它的每一步"思考"都不是简单的函数调用,而是涉及大模型推理、外部API调用、向量检索、工具执行,再回到模型做下一步决策,环环相扣、层层嵌套。你看到的只是输入和输出,中间最关键的决策链路,是一片盲区。
AgentPeek做了几件关键的事
执行链路可视化是核心能力,把每次运行转化为结构化轨迹,从输入到输出每一步清晰呈现。比如你的Agent本该调用搜索工具,却错误地调用了计算器,在链路图上一眼就能看到——第三步模型做工具选择时,上下文里混入了无关数字信息导致误判,靠翻日志要半小时的事,这里一眼搞定。
实时监控这块,当前执行到哪一步、耗时多少、Token消耗多少、工具调用是否成功,不用等运行结束再去"考古"。开发者视角的调试则更贴近写代码的人真正在意的东西:Prompt输入输出是什么、模型为什么选了这个工具、哪一步延迟最高,定位不是运维仪表盘,更像是Agent开发者的Chrome DevTools。复杂工作流透视这块,多Agent协作、条件分支、循环执行、消息传递和任务委派一目了然,不用靠脑补硬猜。
跟同类工具比起来差在哪
LangSmith跟LangChain生态集成度最高;Langfuse在层级追踪和成本分析上比较突出,开源社区也活跃;Braintrust侧重评估驱动的Prompt迭代;Arize Phoenix在RAG场景的监控能力比较强。AgentPeek的差异化在于把重心放在调试体验本身,不追求做大而全的可观测平台,先解决最痛的那个问题——"我的Agent到底在干什么",界面直觉、上手快,也不绑定特定框架。
谁比较适合试试
如果你用LangChain、CrewAI、AutoGen这类框架开发Agent,工作流超过3个步骤,经常遇到"Agent给了离谱结果但翻半天日志找不到问题",这类场景AgentPeek就是冲着你来的。如果团队正把Agent从Demo推向生产,最耗时间的往往不是写Prompt,而是调试那些偶尔出现、无法复现的奇怪行为,这类轻量级工具能帮团队建立"先看清楚,再优化"的开发习惯。
AI Agent的工程化落地,瓶颈从来不只是模型能力,看不清楚Agent在干什么,才是最大的效率杀手。把Agent开发从凭感觉调Bug变成有据可查的工程实践,这大概是这类调试工具真正的价值所在。正在开发Agent的话,不妨试试,调试一个你看不见的系统,和调试一个你看得见的系统,效率差的不是一点半点。
 AI 速览