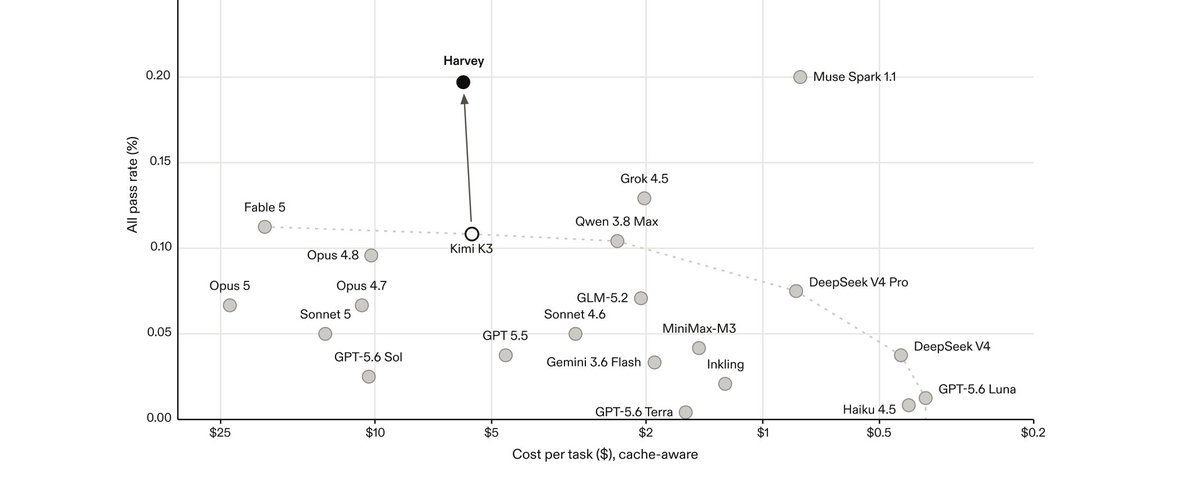
8月21日消息,法律 AI 公司 Harvey 发布首个自研模型 Tenet。Tenet 基于月之暗面的开源模型 Kimi K3,与 Fireworks 研究团队合作,通过异步强化学习在真实法律工作场景中后训练。官方博客给出的初步结果显示,与 Kimi K3 基座相比,Tenet 在 LAB 基准上完成的任务接近翻倍,LAB Contracts 达到领先水平,而成本维持开源模型级别。这是 Harvey 首次公开自研模型,此前其服务依赖第三方模型。 Tenet 是什么:开源基座加垂直后训练
Tenet 是 Harvey 第一个 post-trained open-weight 模型。官方称其研究目标有两个:用开源权重构建前沿法律智能,以及建立让律所构建自己专用模型、拥有自身智能的系统。训练语料由三部分组成:合成数据、公开法律数据与人类专家数据,后者与 Mercor 等合作构建。
后训练在异步强化学习框架下进行,训练环境与 LAB 基准任务结构一致:每个任务包含合伙人的工作请求、客户事项文件与专家评分标准,agent 在沙箱工作区中检索文件、阅读文档并产出工作成果,由 LLM-as-a-judge 按评分标准打分。训练还包含对 harness 的改进,让训练与任务执行更高效。
性能:LAB 完成任务接近翻倍
官方数据显示,后训练让模型在 LAB 留出任务上的完成数量接近基座的两倍,all-pass 率提高 9 个百分点;LAB Contracts 上完成任务多 20%,all-pass 率提高 2 个百分点。LAB Contracts 达到当前领先水平,LAB 整体位列第二。这些提升还泛化到训练时未见过的基准:Mercor 的 APEX Agents(公司法)与 Crosby 的 Redline Bench 上,Tenet 明显优于 Kimi K3 基座。法律知识类基准(LegalBench、CUAD、MAUD 等)的表现则保持稳定,说明 agentic 能力的提升没有牺牲基础的法律知识理解。
成本优势从哪来
官方把成本效率作为第二个主要发现,来源有两层。一是开源权重本身更低的 token 单价;二是在后训练中用奖励塑形激励高效的推理与工具使用,在同等表现下减少推理阶段的 token 消耗。两层叠加,官方对 Tenet 的定位是与最强通用模型表现相当、成本维持开源模型级别,这让律所可以在每个案子上持续运行 agent。
三个子代理:M&A Diligence、Review Tables 与 Firm Knowledge
Tenet 的专门能力以子代理形式提供,各自独立训练,可部署为工具并路由调用。M&A Diligence 面向并购尽职调查这类文档密集的长时程任务,官方称在 LAB Diligence 上取得显著提升。Review Tables 面向高量文档审查与结构化数据提取。Firm Knowledge 面向律所自身知识积累的检索与推理,训练时加入检索上下文、schema 约束与引用要求,让模型理解事务所内部的知识结构。
怎么用:对律所意味着什么
Tenet 目前以研究预览形式发布,官方表示这些能力将逐步并入 Harvey 产品。对律所而言,使用路径首先是现有 Harvey 产品体系:Tenet 的 M&A Diligence、Review Tables 等能力进入产品后,可以在并购尽调、文档审查等场景直接调用。更长远的方向是官方研究目标之二:让律所用开源基座配合后训练工具,构建自己的专用模型,把模型能力沉淀在律所内部。
选型层面的参考是成本结构:Tenet 走的开源基座加垂直后训练路线,token 成本与推理消耗都低于调用领先闭源模型,适合长时程、高频次的 agent 任务。具体效果建议以 Harvey 官方后续的产品化说明为准。
边界与观察
Harvey Tenet 的发布说明垂直 AI 厂商开始走"开源基座加垂直后训练"的路线:不自己训练基础模型,而是在成熟开源基座上用领域数据做深度的后训练。对 Harvey 来说,这既是成本选择,也是让客户"拥有模型"的产品方向。对开源生态来说,Kimi K3 作为月之暗面 7 月发布的开源模型,被海外法律 AI 厂商采用为基座,是国产开源模型进入海外垂直场景的一个样本。
需要留意的是,本文性能与成本数字均来自 Harvey 官方口径;Tenet 目前是研究预览,实际产品化表现待验证。以开源基座构建法律模型的具体收益,还取决于后续产品落地与更多独立评测。
 AI 速览