deepseek v4 pro正式版已经来了——2026年8月13日晚间,官方正式发布DeepSeek-V4-Pro-0813,同步在App、网页端和API三端上线,支持思考与非思考双模式,1M上下文、384K最大输出,跑分比预览版有明显提升,但价格也同步大涨,8月17日起执行峰谷定价,高峰时段输出价格涨到27元/百万tokens,这篇文章把参数、跑分、价格这几块给你捋清楚。 一、DeepSeek V4 Pro发布信息和基本参数
V4 Pro正式版的模型版本号是DeepSeek-V4-Pro-0813,API调用的模型名保持不变。它是DeepSeek V4系列里的旗舰款,走MoE混合专家架构,总参数量1.6万亿,单次推理实际激活参数49B。网页端和App用户可以通过选择"专家模式"来体验这个新版本,默认启用思考模式,也支持按需切换成非思考模式。
技术规格方面,上下文长度依然是100万tokens,最大输出长度384K tokens,这两个数字跟预览版一致,没有缩水。API并发限制是500路,对比同系列的V4-Flash(2500路并发),Pro版本更适合处理复杂任务,Flash更适合高吞吐量场景,两者定位不完全重叠。
二、DeepSeek V4 Pro跑分数据
提升幅度不小
这次正式版最大的看点是跑分涨幅,而且是在模型架构完全没变的前提下,纯靠后训练优化实现的。官方披露的几个关键数据:
DeepSWE(软件工程基准):从预览版的7.3分一路涨到62.7分,官方说法是已经超过Claude Opus 4.8 LiveCodeBench:拿到93.5分,在第三方跟踪的模型里排名第一
Codeforces:评分达到3206,接近人类顶级程序员的水平
Cybergym和AutomationBench两项测试:据称也超过了Anthropic的Claude Fable 5
DeepSWE这项涨幅尤其夸张,从个位数直接跳到六十多分,不少开发者在社区讨论里都提到这个数字有点"疯狂"。官方解释是这些提升完全来自后训练改进,不是重新训练了底座模型,说明纯靠后训练调优就能带来这么大幅度的能力跃升,这本身也算一个值得关注的技术信号。
三、新增功能:三档思考强度和原生Responses API
V4 Pro正式版这次新增了灵活的推理强度设置,分低、高、最强(low/high/max)三档,你可以根据任务复杂度自己选:简单任务用low档,省时间省token;日常Agent任务用high档;特别复杂的场景才上max档,让模型深度思考。具体设置方法官方API文档里的"思考模式"章节有详细说明。
另外这次还新增了对OpenAI Responses API格式的原生支持,并且专门做了Codex的适配,用户可以参照官方文档里的"接入Agent工具-Codex"章节,通过一键配置脚本完成接入,对已经在用Codex这类工具的开发者来说,迁移成本降低了不少。
四、DeepSeek V4 Pro价格:涨了,而且涨幅不小
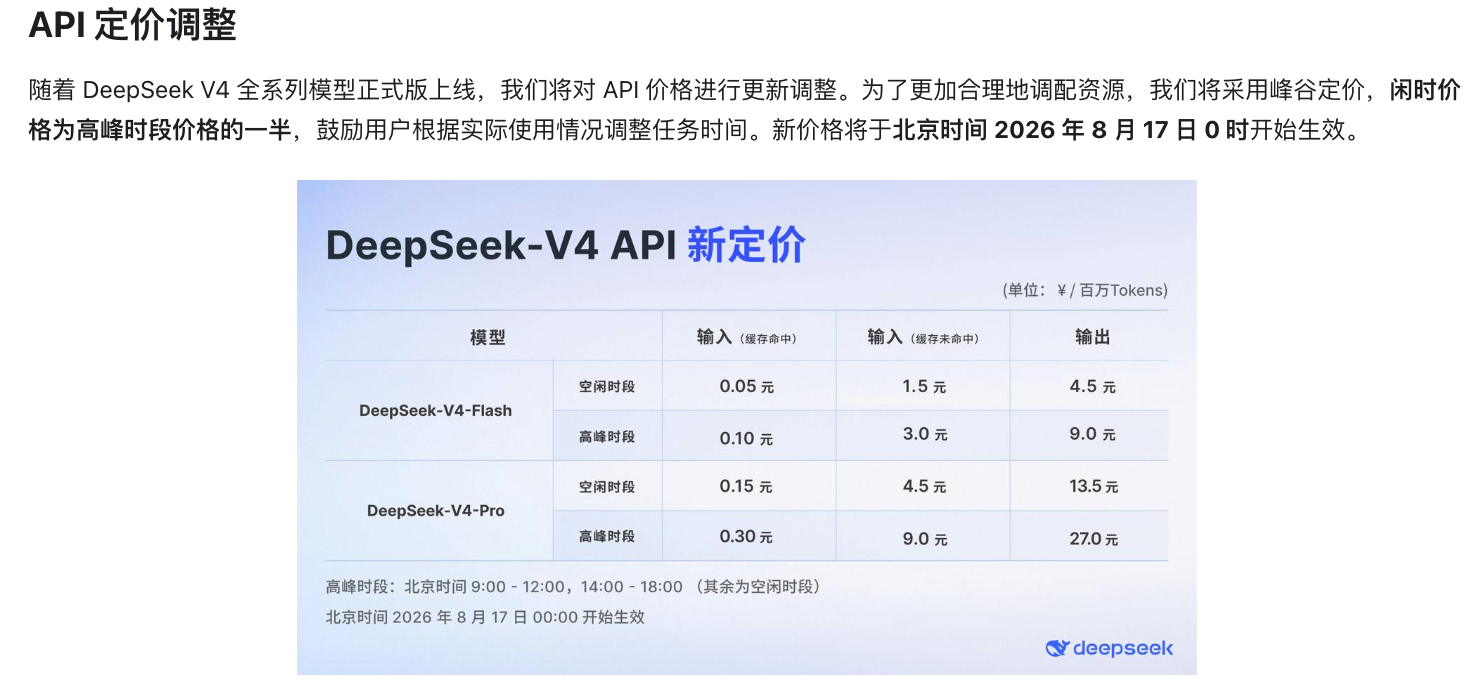
伴随正式版发布,官方也宣布了新一轮价格调整,2026年8月17日零点开始执行峰谷定价机制:
高峰时段(工作日9:00-12:00、14:00-18:00):缓存命中0.3元、缓存未命中9元、输出27元(每百万tokens)
闲时(其余17小时):缓存命中0.15元、缓存未命中4.5元、输出13.5元
对比8月17日之前的价格(缓存命中0.025元、缓存未命中3元、输出6元),输出价格涨了4.5倍,缓存命中价格涨幅更夸张,能到11倍左右。不过要提醒一句,涨幅百分比看着吓人,实际账单涨多少还得看你的应用里输入输出token的实际占比,输出token通常是影响总成本最大的一块。
想省钱的话,把批量任务、离线处理这类不着急的活儿挪到晚上18点到次日9点这个闲时段跑,成本能直接砍半,这个错峰思路值得纳入你的成本规划里。
需要注意的是,DeepSeek官网一度撤下过关于V4 Pro正式版上线的相关描述,说明围绕这次发布和涨价,官方信息还存在一定的反复。建议你在正式调整预算或者接入生产环境之前,直接去DeepSeek官方定价页面和模型文档确认当下最新、确实生效中的信息,别只依赖某一篇报道里的截图数字。
deepseek v4 pro正式版这次发布,参数规格(1.6T总参数、1M上下文、384K最大输出)没有大变化,但跑分靠后训练优化涨了一大截,功能上新增三档思考强度和原生Responses API支持,价格也同步大幅上调、引入峰谷定价。想用的话,先确认自己的任务是不是真需要旗舰级性能,再结合错峰调用去控制成本,别被涨价吓到直接放弃,也别忽略这轮涨价带来的实际账单影响。
 AI 速览