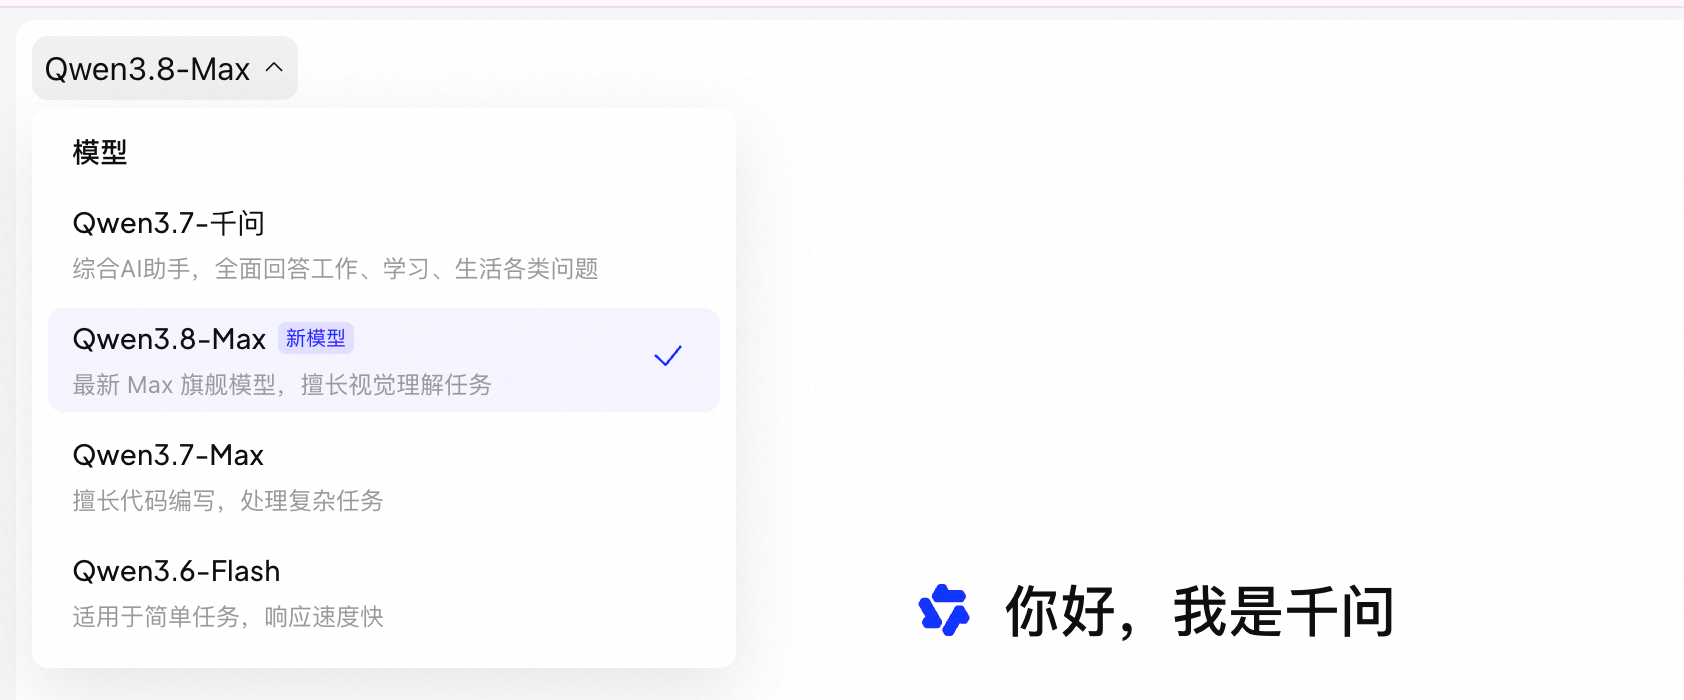
千问的哪个模型最好用?这个问题没有单一答案,因为千问不是一个模型,是一整套矩阵。综合能力最强的是Qwen3.8-Max(2.4万亿参数旗舰),复杂任务、长程Agent、多模态理解都能扛;但如果你只是日常问答、批量处理这类简单任务,选它反而浪费钱,Qwen-Flash或者Qwen-Plus更划算。这篇文章按场景把千问家族拆开讲,帮你找到最适合自己的那一款。
一、千问家族都有谁
千问系列目前的主力阵容大概是这样:
Qwen3.8-Max:旗舰款,适合复杂任务,能力最强
Qwen-Plus:效果、速度、成本均衡的中间档
Qwen-Flash:适合简单任务,速度快、成本极低
Qwen3-Coder-Plus:专攻工具调用和环境交互,编程场景优先考虑
Qwen3-VL-Plus:强视觉理解能力,图片视频类任务用它
Qwen3-Omni-Flash:全模态理解生成,文本图片音频视频都能处理
选哪个不是看"谁最强",是看你的任务类型跟哪个定位对得上。
二、复杂任务、长程Agent:Qwen3.8-Max
如果你要处理的是需要深度推理的复杂任务,比如大型项目开发、多智能体协作、长文档深度分析,Qwen3.8-Max是目前千问系列里能力最强的选择。2026年8月3日正式发布,2.4万亿总参数、单次推理激活约95B,是千问家族首次开放权重的Max级旗舰模型。
官方跑分显示,GPQA Diamond科学推理拿到92.6分,OSWorld-Verified(电脑操作能力)86.1分排主流模型首位,IFBench指令遵循82.8分,明显超过Claude Fable 5的63.5分,部分场景确实站上了国际前沿水平。不过要提醒一句,DeepSWE、HLE、Terminal Bench这几项跟Fable 5或者GPT-5.6 Sol max比还有差距,而且这些数据都是厂商自测口径,独立第三方复现结果还在跟进,不是说它就全面碾压顶尖闭源模型。 支持1M token上下文、原生多模态(文本、图像、视频),价格上国内定价输入12元、输出36元(每百万tokens),比同级别的国际旗舰模型便宜不少,性价比是它的一大优势。
三、日常轻量任务:Qwen-Flash最划算
如果你要做的是简单问答、内容摘要、批量文案生成这类不需要深度推理的任务,Qwen-Flash是更明智的选择。它的定位就是"速度快、成本极低",上下文窗口同样支持1M token,但价格比Max档位便宜得多。用旗舰模型跑简单任务,多花的钱和多等的响应时间都不划算,这种场景选Flash才是真的"好用"。
四、效果速度成本要兼顾:Qwen-Plus
Qwen-Plus定位是效果、速度、成本三者均衡,上下文也是1M token。如果你的任务复杂度中等,比如日常办公文档处理、常规业务逻辑、中等难度的问答,不想为顶级性能多花钱,也不想牺牲太多质量,Qwen-Plus是个比较稳妥的中间选项。
五、编程场景:Qwen3-Coder-Plus
专门写代码、接编程工具的话,Qwen3-Coder-Plus是针对性更强的选择,擅长工具调用和环境交互,1M上下文,适合接入Claude Code、Codex、OpenCode这类Agent工具做日常开发。如果你的需求就是代码补全、调试、重构这类任务,这个版本比通用款Max更贴合场景,成本上也更可控。 六、视觉和多模态任务:VL-Plus和Omni-Flash
涉及图片、视频理解的任务,Qwen3-VL-Plus专注视觉理解能力,适合图像分析、视觉问答这类场景。如果你的需求更全面,涉及文本、图片、音频、视频多种模态混合处理,Qwen3-Omni-Flash是覆盖面更广的选择,一个模型能处理多种输入类型,不用来回切换。
七、怎么快速判断该选哪个
想快速定位适合自己的版本,先问自己两个问题:任务复杂度高不高,是不是需要长程推理或者多智能体协作;对成本和响应速度敏不敏感。复杂任务预算充足选Max,简单任务或者高频调用选Flash,中间状态选Plus,专项需求(编程、视觉)直接对应专项模型。免费网页版chat.qwen.ai可以先试试不同版本的实际效果,感受一下差异再决定要不要接入API长期用。
千问的哪个模型最好用?答案取决于你的具体场景——复杂任务选Qwen3.8-Max性能最强,日常轻量任务Qwen-Flash最省钱,编程场景Qwen3-Coder-Plus更贴合,视觉多模态任务看VL-Plus或者Omni-Flash。别盲目追最贵最强的那个,拿自己的真实需求去匹配对应版本,才是真正意义上的"好用"。
 AI 速览