8月21日,DeepSeek 官方宣布全新多模态视觉理解模型 DeepSeek-V4-Flash-Vision-Exp 上线 API 平台,模型性质为实验(Exp),用户可通过设置 model='deepseek-v4-flash-vision-exp' 访问。这是 DeepSeek 首次在 API 侧开放图像输入能力,也证实了同日早些时候开发者在 DeepSeek Harness 中观察到该模型代号的爆料。 官方公告说了什么
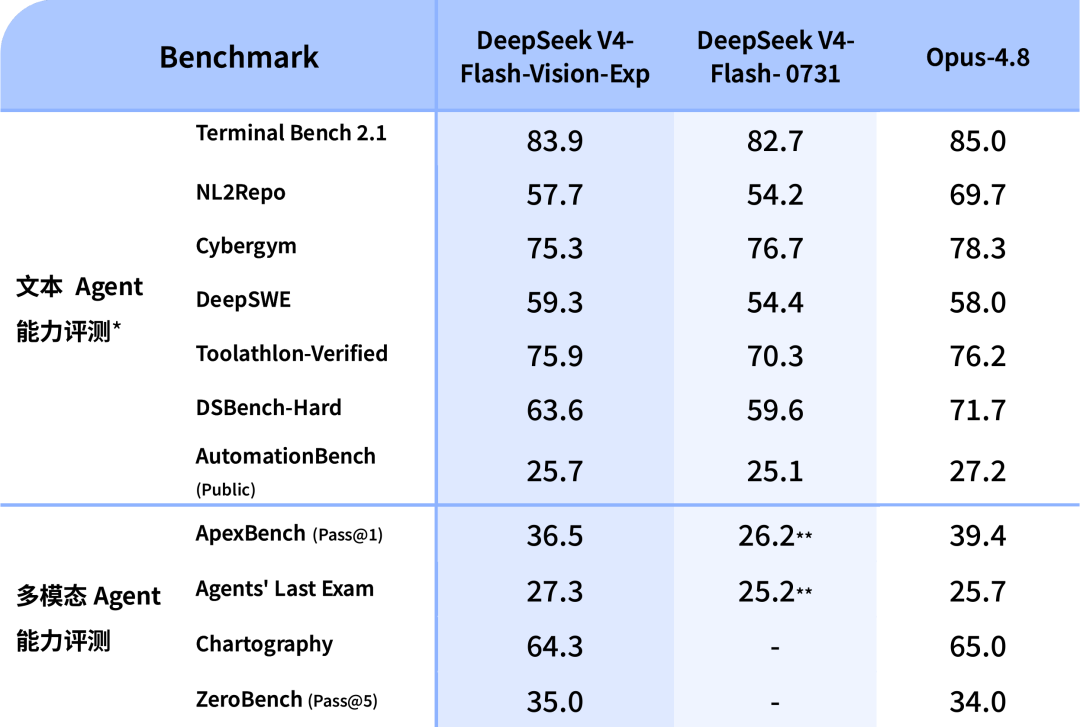
能力定位:文本不降级,视觉大幅跃升。 官方称,在纯文本能力(Agent、推理、世界知识等)方面,V4-Flash-Vision-Exp 与 V4-Flash 正式版持平;在需要视觉理解的 Agent Benchmark 上则相比 V4-Flash 大幅跃升,多模态 Agent 能力「已接近 Opus-4.8」。官方基准测试脚注显示,Code Agent 文本任务使用 DeepSeek Harness 极简模式作为测试框架,max 档位,temperature=1.0,top_p=0.95;在 ApexBench 与 Agents' Last Exam 测评中,文本模型 V4-Flash 会忽略其中的多模态元素。
API 与计费。 图片在 API 服务中转换成 token 后按 token 计费,一张图片最多占 384 tokens,计费价格与 V4-Flash 完全一致。多模态 API 支持 Chat Completions、Messages、Responses 三种调用格式,支持图文混合输入,图片传入支持 base64 内联、外部 URL、Files API 三种方式。
Files API 同步上线。 该 API 免费开放,用户可先将图片上传到平台,再在请求中通过 file_id 引用,节省请求带宽,同一张图片在多个请求中无需重复上传。
官方还给出三个示例场景展示多模态 Agent 能力:在 Agent 框架下生成商业定制西藏自驾游 PPT(真实摄影风格配图、含三种定价方案)、对 DeepSeek Harness 官网进行未来主义风格二次创作、制作黏土怪物风格动态特效的前端 Mini Demo。
定价页细节(与公告互证)
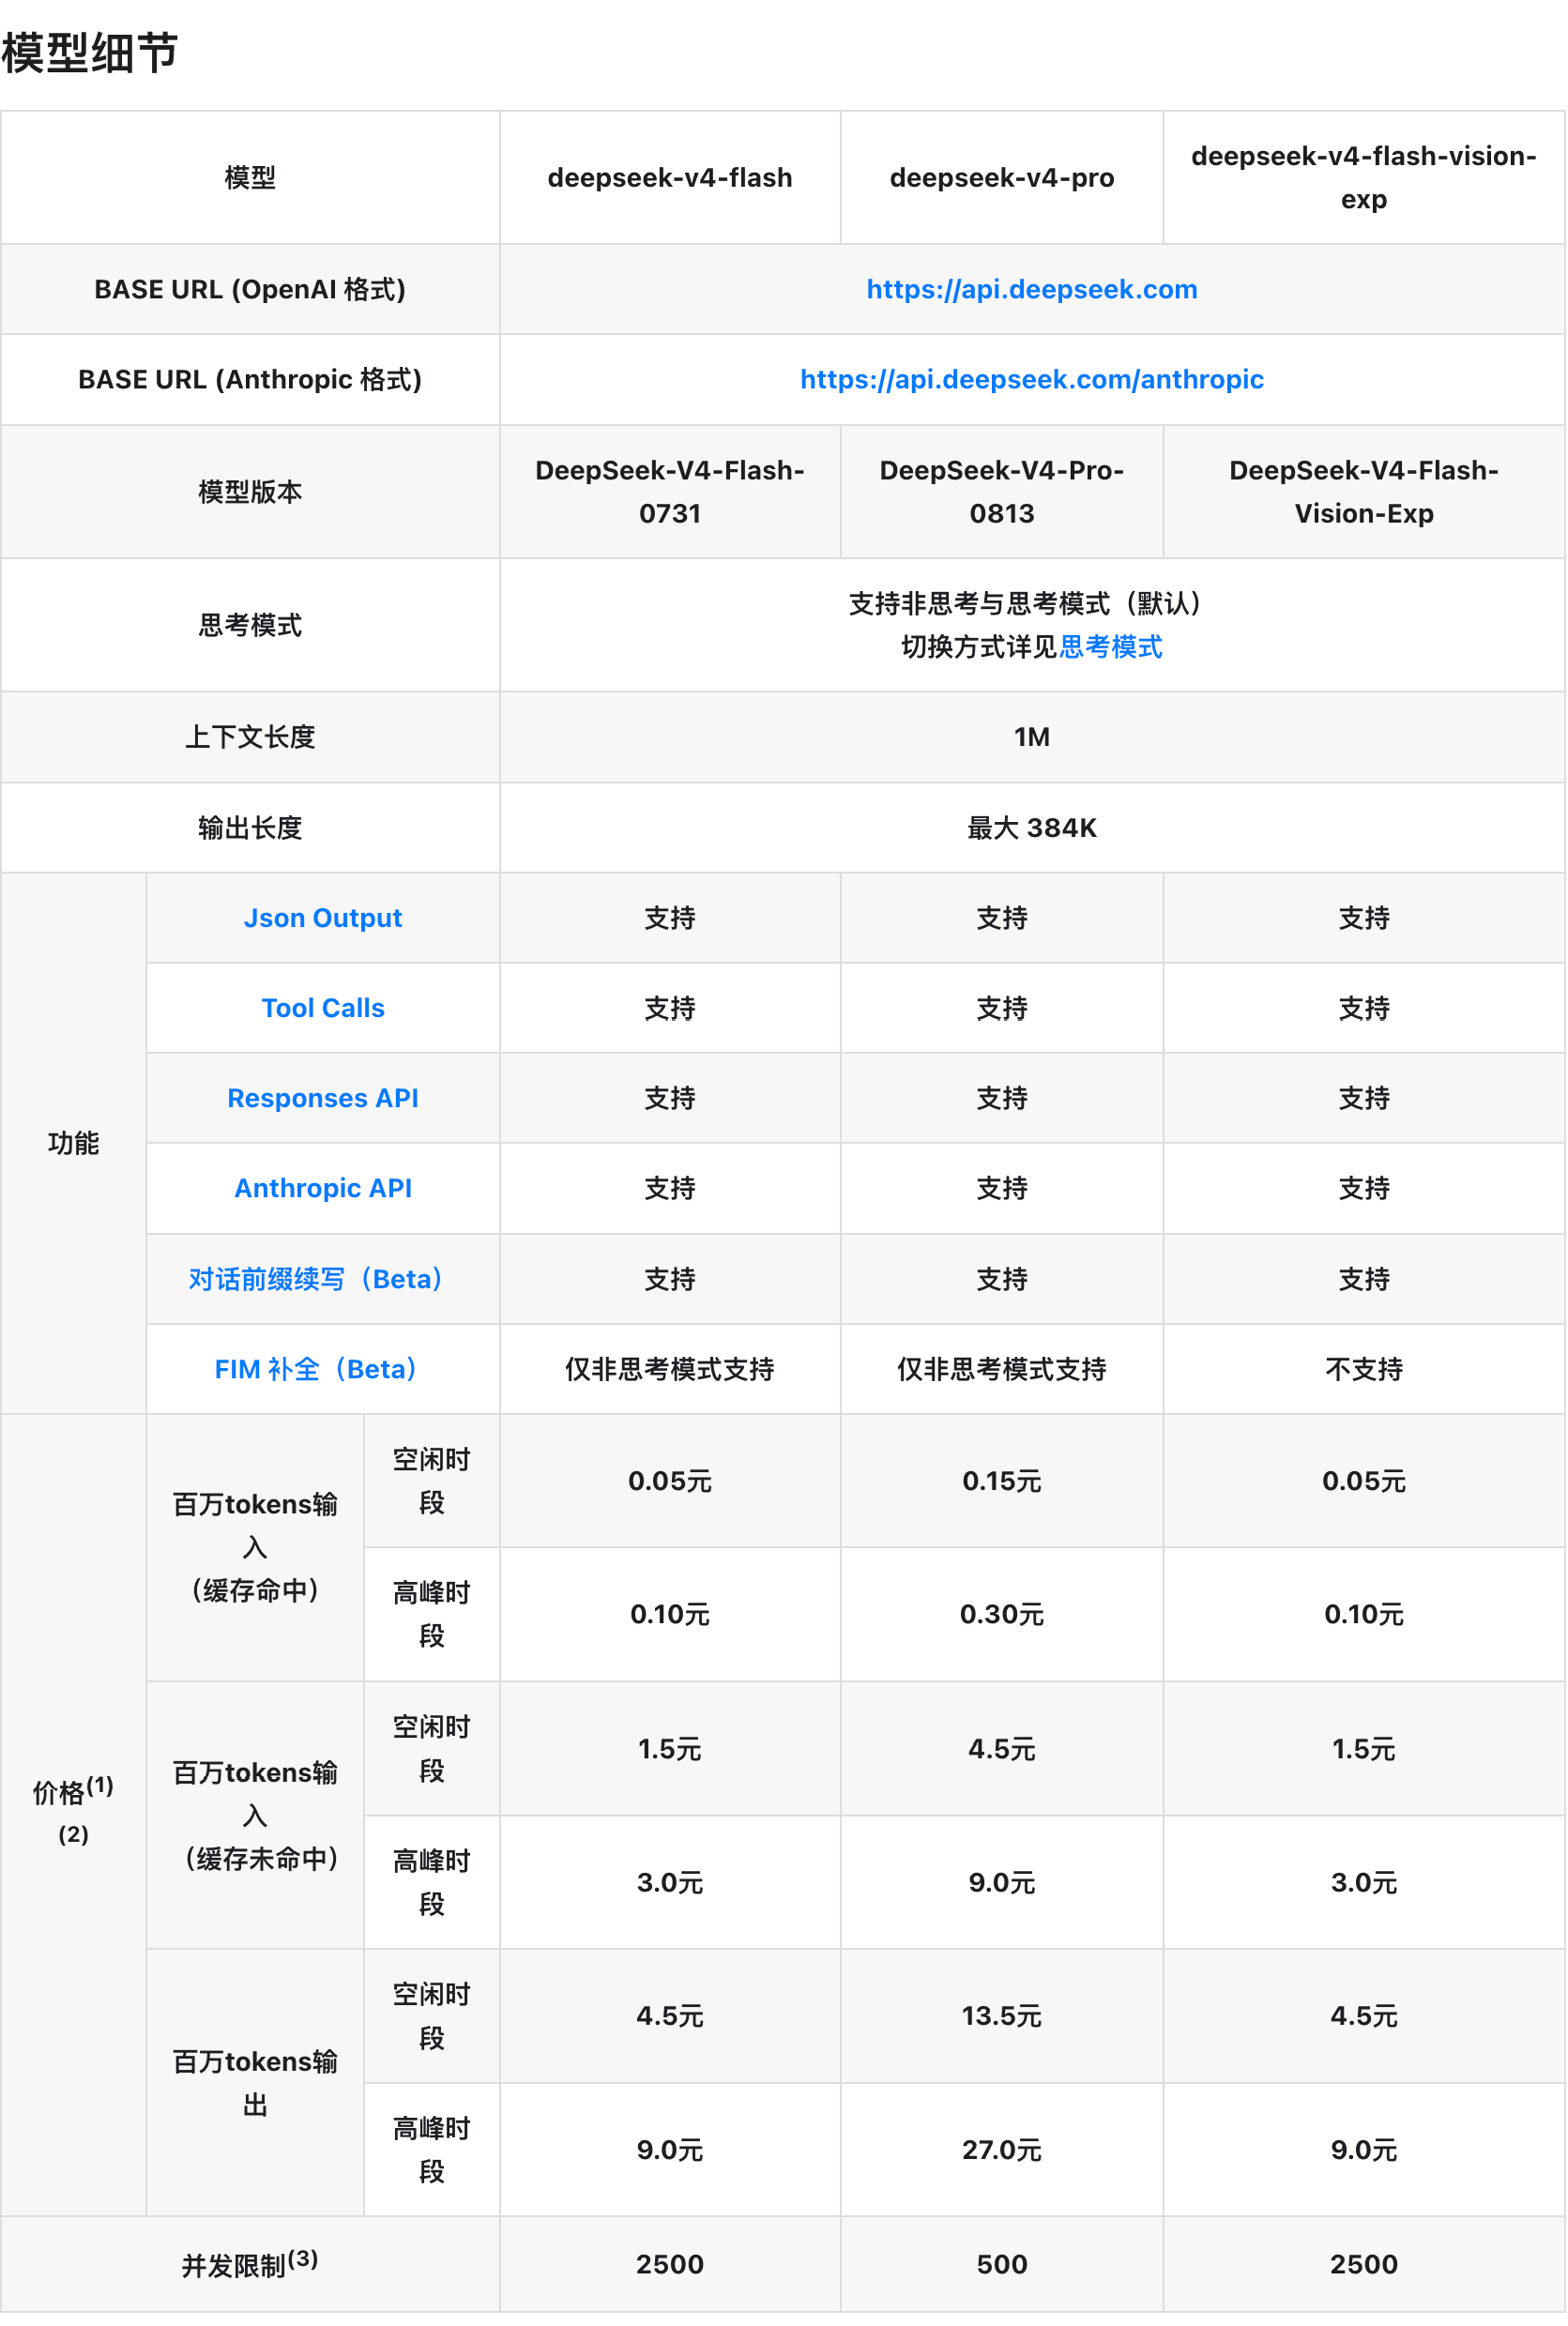
官方「模型 & 价格」页面已将该模型与 deepseek-v4-flash、deepseek-v4-pro 并列列出,版本标注为 DeepSeek-V4-Flash-Vision-Exp:
- 1M 上下文长度,最大输出 384K;支持非思考与思考模式(默认为思考模式)。
- Json Output、Tool Calls、Responses API、Anthropic API、对话前缀续写(Beta)均支持;FIM 补全(Beta)不支持——这是它与 flash、pro 在功能表上的唯一差异。
- 价格与 V4-Flash 相同:百万 tokens 输入(缓存命中)空闲 0.05 元 / 高峰 0.10 元;输入(缓存未命中)空闲 1.5 元 / 高峰 3.0 元;输出空闲 4.5 元 / 高峰 9.0 元。高峰时段为北京时间 9:00–12:00、14:00–18:00。
- 并发限制 2500,与 flash 持平,高于 pro 的 500。
从爆料到上线:一天之内的证据链
同日早些时候,已有开发者直接在 DeepSeek Harness(官方开发者预览中的智能体编排产品)中看到 deepseek-v4-flash-vision-exp 这一名称,社区文章也称在 DSH 源码中发现该代号,当时官方文档尚无该模型。数小时内,定价页更新、官方公告发布,爆料被完全证实。值得注意的是,官方测试框架正是 DeepSeek Harness——爆料与公告围绕同一个产品闭环。
仍待观察的部分
「Exp」后缀意味着实验性质:模型没有日期化正式版本号(对照 V4-Flash-0731、V4-Pro-0813),后续是否转正、转正后价格是否维持不变,官方未说明。「接近 Opus-4.8」为官方自述口径,第三方复测尚未出现。此外,V4-Pro 线是否跟进视觉能力、图像输入的分辨率上限与单请求图片数量等细节,需以官方「图像理解」文档的进一步说明为准。
 AI 速览