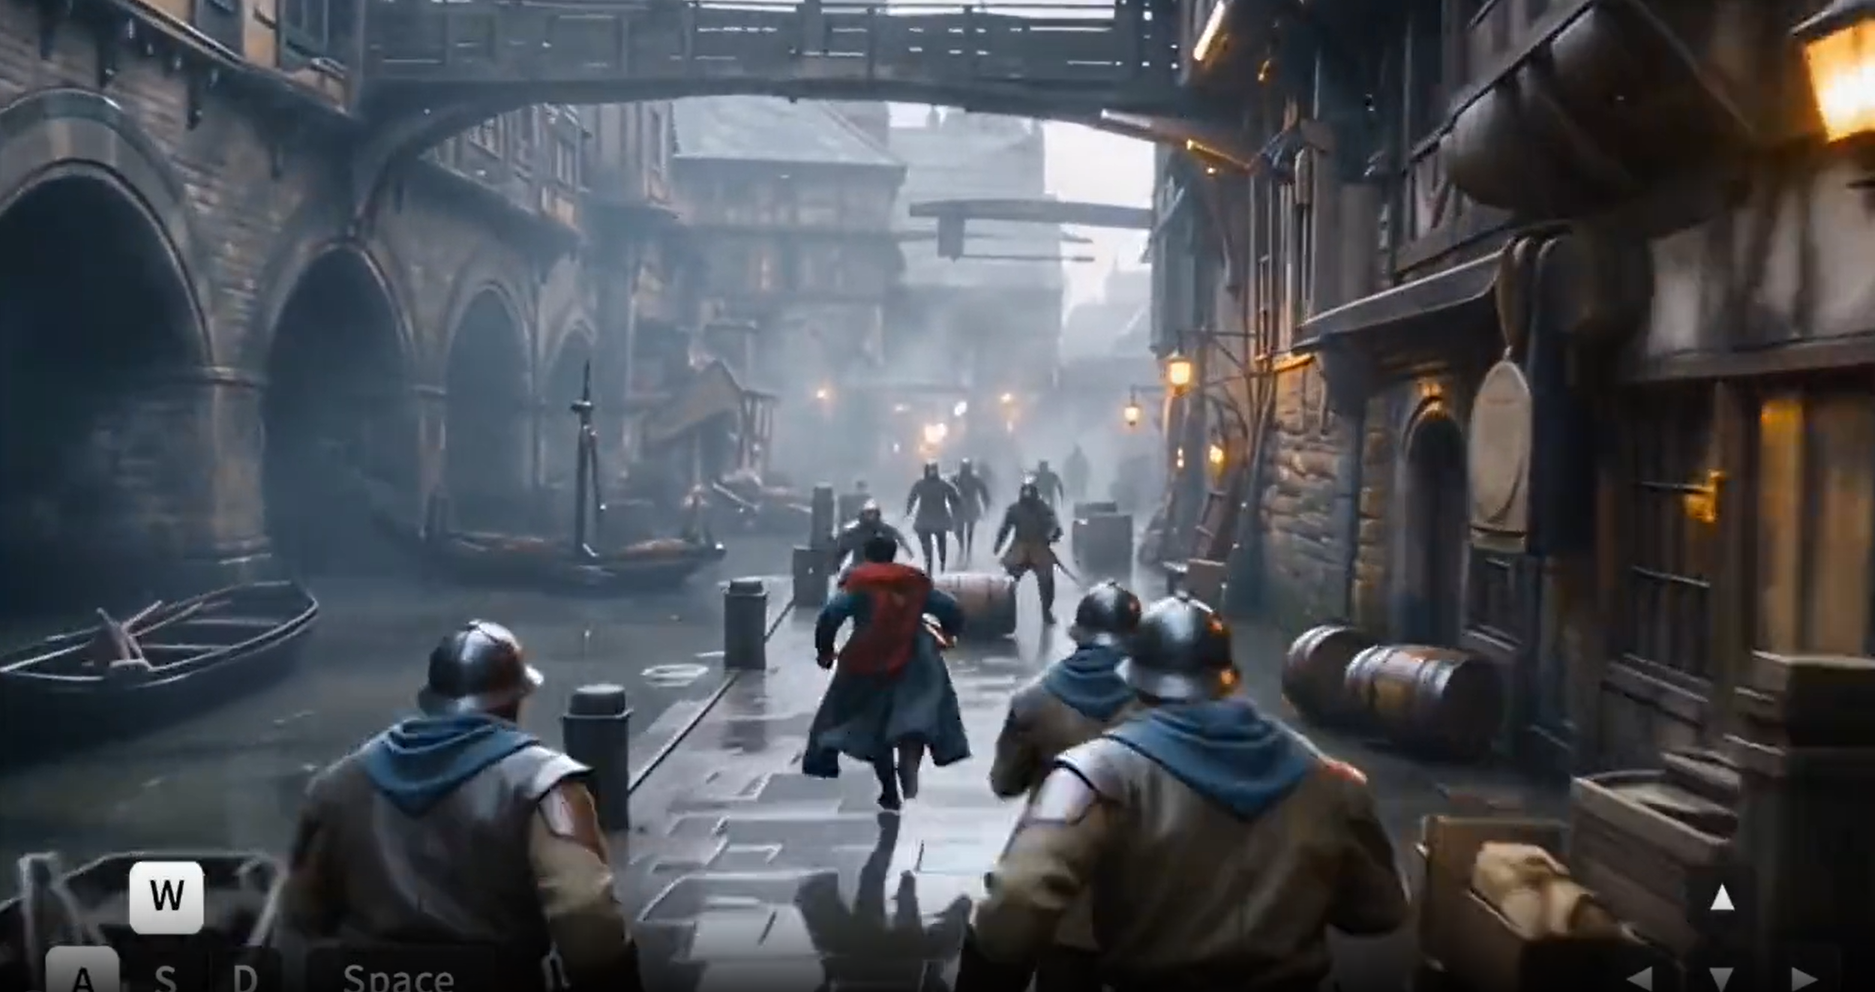
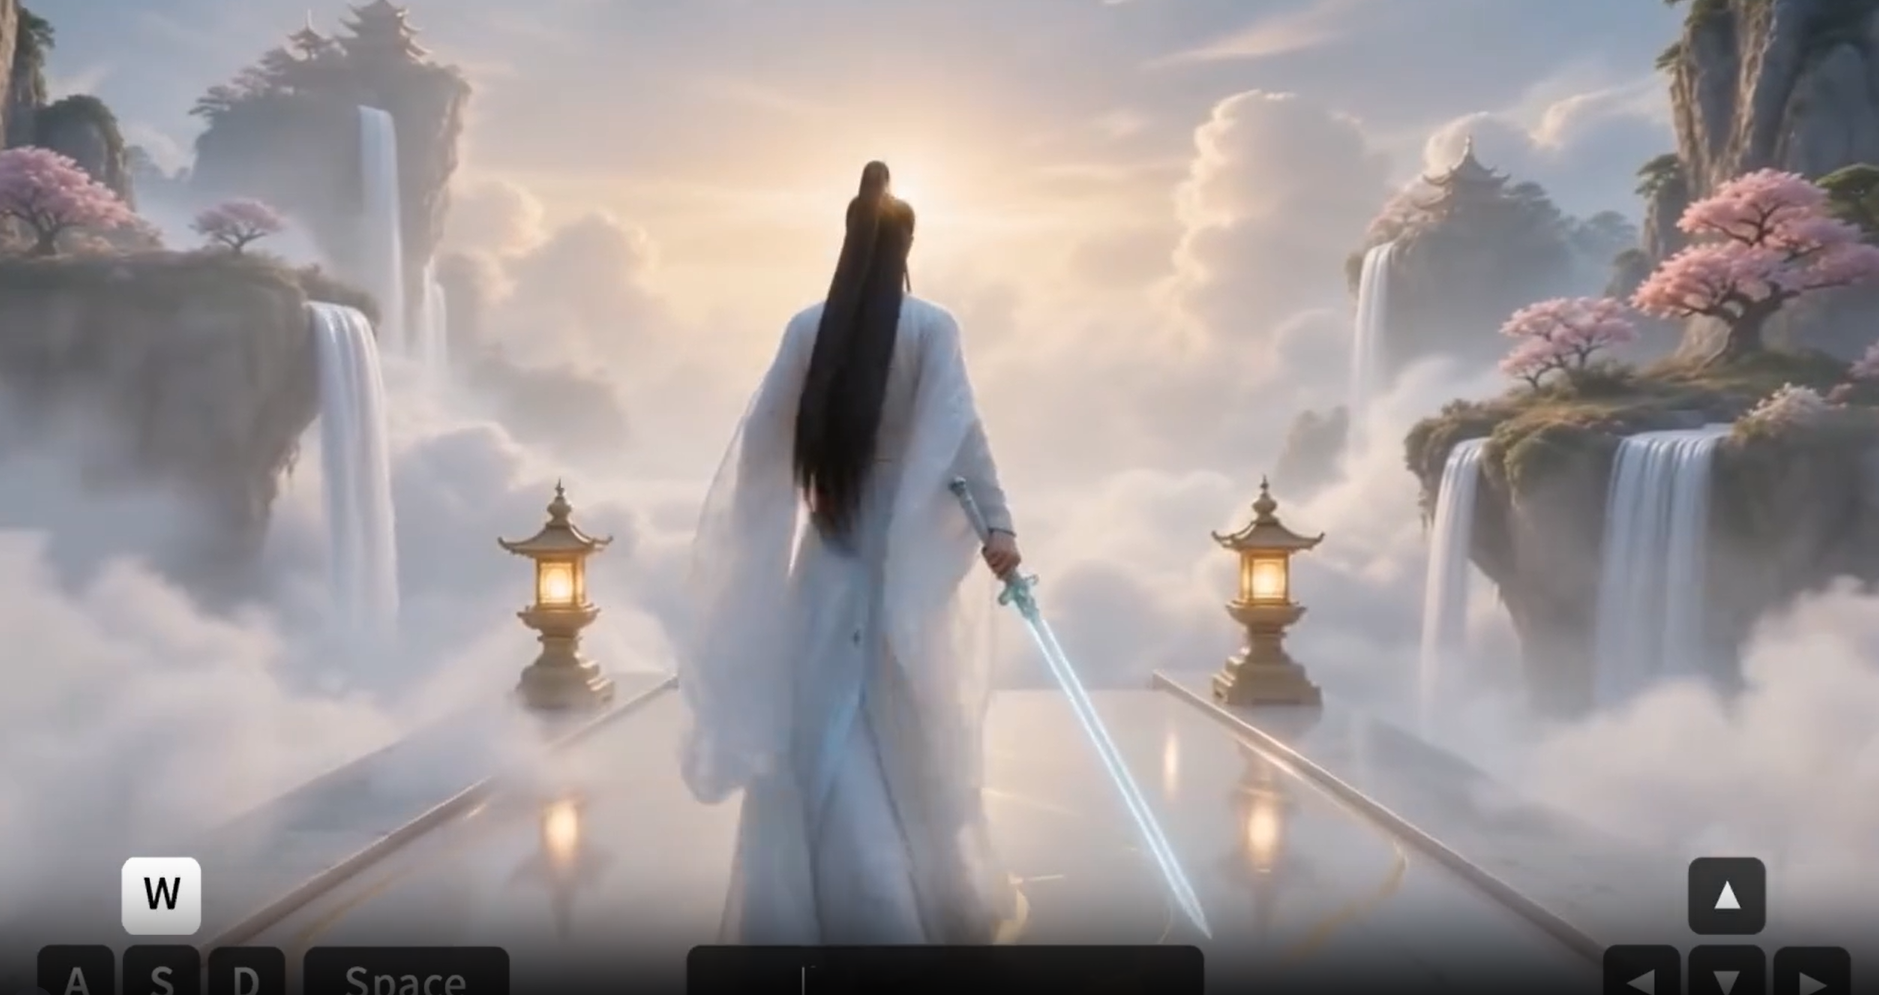
AI 视频赛道正分化出两条清晰的发展路线:一条持续优化固定时长视频的画质、运镜与人物一致性;另一条则走向可交互的持续虚拟世界,用户输入能实时改变画面,且行为会对世界产生长期影响。
近期 PixVerse 推出的 R2 世界模型,就在 R1 实时交互的基础上完成关键升级,实现了行为有后果、状态有记忆、世界可持续运行的全新体验,为互动影游、实时数字人等新场景提供了成熟技术底座。
一、产品进阶:从 “实时改画面” 到 “行为留影响”
传统 AI 视频本质是一次性生成产物,输入提示词产出固定片段,用户只能被动观看,无法参与内容进程。
PixVerse 在今年 1 月推出的 R1 版本,首次实现了连续可交互的视频流,支持用户实时调整画面风格与元素,但改变多是单次视觉调整,缺乏长期逻辑与因果关联。
R2 的核心突破,是让虚拟世界拥有了持续记忆与因果规则:用户从桌上拿走钥匙,后续开门就必须使用钥匙而非凭空解锁;对话中激怒角色,再次见面时关系状态会同步变化;完成任务后世界状态会永久保留,不会切换镜头就全部重置。这种 “行为产生持续后果” 的特性,让 AI 内容从 “可观看的视频” 变成了 “可进入的世界”,产品形态发生了本质跃迁。
二、三大落地场景:覆盖探索、叙事、交互全维度
基于持续世界的核心特性,R2 目前已形成三类成熟应用方向,适配不同创作与商业需求。 自由探索模式(World)支持用户通过 WASD 按键控制行进、调整视角,也可用语音文字实时修改场景风格与角色设定,大地图中所有改动都会持续留存,适合打造专属虚拟世界。
互动叙事模式(Story)更接近互动影游,用户可做出剧情选择、与角色对话、触发 QTE 交互,模型会在保持人设与世界观边界的前提下,生成合理的分支剧情,故事走向不再由编剧完全决定。
实时数字人模式(Character)是最贴近大众的落地场景:角色支持实时语音对话,口型、表情、动作同步响应,且能在多次交流中保持人设与记忆连贯,可应用于直播带货、文博科普、虚拟陪伴等场景,也是最可能率先规模化普及的方向。
三、技术底座:双层架构 + 多尺度记忆 破解实时与稳定难题
要实现低延迟、长时稳定的持续世界运行,R2 在技术架构上做了三项核心优化,平衡了响应速度与世界逻辑的完整性。
首先是双层训练架构,底层 Omni Causal AR 模型专注学习世界运行的底层规律,上层 Real-Time Acceleration 模块专门负责速度优化,避免了传统多步迁移训练的能力损耗,兼顾了世界逻辑完整性与实时响应速度。
其次是动态分块机制,针对按键操作等短指令匹配短输出块实现即时响应,针对对话等完整事件分配更长的生成窗口,兼顾操作手感与语义完整性。
针对长时运行普遍存在的画面漂移问题,模型采用混合训练策略提前适应误差,搭配因果注意力限制时间窗口;同时通过多时间尺度记忆机制分层存储信息:世界规则等长期信息、近期动作等中期历史、关键物品状态等核心对象分别留存,仿人脑记忆架构大幅降低了长程运行的错乱概率,配套的错误库训练也提升了偏差后的自愈能力。
四、行业价值:重构内容形态 打开 AI 视频新边界
目前受限于实时算力约束,R2 的单帧画面质量仍低于前沿离线视频模型,但它开辟的 “持续可交互世界” 赛道,正在重新定义 AI 视频的核心价值。
未来最先落地的会是实时数字人场景,记忆与人设的连贯性将成为核心竞争力,取代当下 “一问一忘” 的伪交互。互动影游则会重构创作逻辑,创作者的工作从写定剧本、分镜头,转向设计世界规则、角色动机与行为边界,每个用户都能获得独一无二的剧情体验。再往长远看,多人共享的持续世界甚至会成为新型社交空间,用户的行为会永久改变世界状态,真正实现沉浸式的虚拟共生。
整体而言,PixVerse R2 不是对现有 AI 视频能力的小幅升级,而是开辟了一条全新的产品路线。当视频从 “被动播放的内容” 变成 “可参与、可改变的世界”,内容创作与数字体验的形态都将被重新定义。
 AI 速览