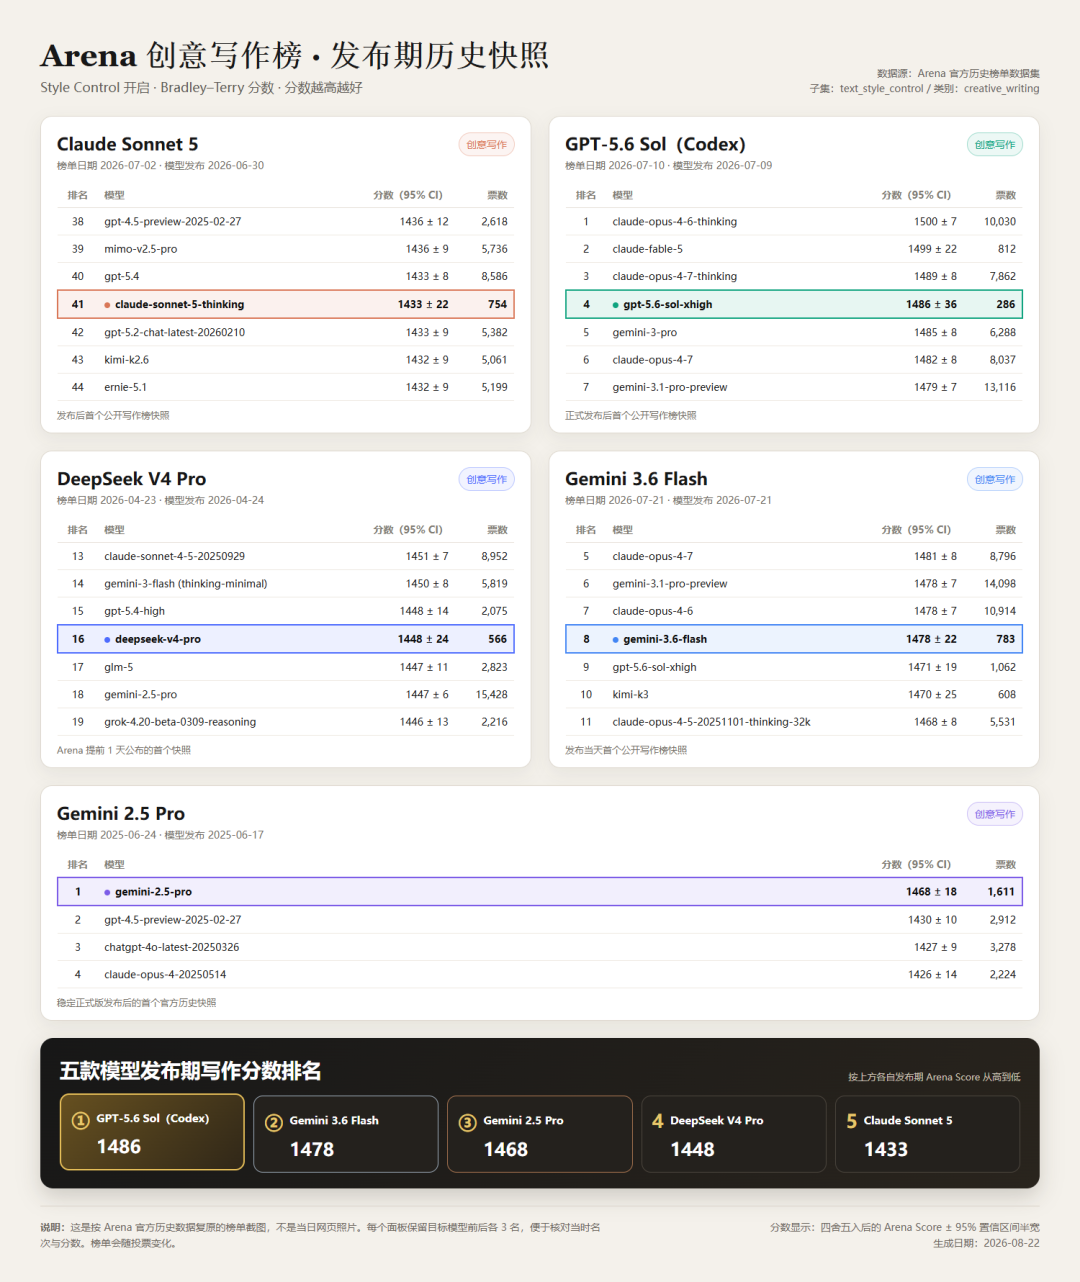
近两年大模型在推理、代码、Agent 领域持续突破,但大量用户却有直观感受:AI 的写作水平反而在走下坡路,套路感加重、同质化明显、仿写精度下降。这并非个体审美疲劳带来的错觉,而是行业普遍存在的现象,背后关联着模型迭代路径、训练数据生态与厂商优化方向的多重变化,也重新定义了内容创作的核心竞争力。
一、实测验证:新旧模型仿写能力出现代际差距
“AI 写作变差” 最初常被归因为 “套路被摸透” 的主观感受,但同题对照测试给出了更客观的结论。
使用完全相同的仿写提示词、同一指定写作风格,分别用一年前的 Gemini 2.5 Pro 与当下主流的 DeepSeek V4 Pro、Claude Sonnet 5、Codex 5.6 Sol、Gemini 3.6 Flash 进行同题测试,最终综合表现排名与大众体感高度吻合。 其中一年前的旧版模型以 9 分位列第一,语气节奏、细节表达、个人化叙事均接近真人水准,也是当年用户投票认可度最高的版本;后续新模型表现依次递减,部分最新模型甚至出现文风偏离、内容空洞、结构生硬的问题。遗憾的是,表现最佳的旧版本已下架,当前市售主流模型均未达到当年的写作精度,证明写作能力的衰退并非单纯的主观错觉。
二、三重因素叠加 写作能力进入下行通道
写作能力退步并非单一原因导致,而是模型对齐逻辑、资源倾斜方向、训练数据生态共同作用的必然结果。
其一,指令微调与 RLHF 加剧风格同质化。经过指令对齐与人类反馈强化训练后,模型输出更规范、安全,但也系统性偏离了人类自然写作的特征:固定套话、模板化句式增多,第一人称表达、个人化叙事减少,不同厂商模型的输出风格趋同,“AI 味” 越来越重,表达多样性大幅下降。
其二,厂商优化优先级转移。头部厂商已公开表示,当前研发资源更多投向推理、代码、Agent 等高价值方向,日常写作的可读性不再是核心优化目标,写作能力自然出现相对退步。
其三,模型坍塌效应逐步显现。随着互联网上 AI 生成内容占比持续升高,训练数据被合成内容污染,递归训练会让模型逐步丢失长尾特征,输出越来越趋同、平庸。这一理论上的必然趋势,正在真实的模型迭代中逐步显现。
三、破局路径有限 同质化难以彻底逆转
针对写作能力衰退,行业也在尝试多种解决方案,但均存在明显局限。
完全采用 2023 年之前的纯人类数据训练,虽能从源头规避合成污染,但会导致模型知识停更,无法适配通用大模型的基础需求;靠后训练优化文风,只能微调表达风格,无法弥补预训练阶段丢失的多样性与长尾特征,甚至可能进一步加剧 “助手感”。
目前头部厂商的主流方案,是严格管控预训练数据质量:囤积高质量人类数据、用检测工具过滤高概率合成内容、仅使用经过验证的合成数据、在后训练阶段针对性削弱模板化表达。这些手段能缓解衰退速度,但无法从根本上逆转趋势 —— 纯 AI 训练 AI 的闭环本身就存在天然的多样性缺陷。
四、创作者的新护城河:真实个体表达不可替代
AI 写作能力的停滞甚至倒退,反而给人类创作者留出了差异化空间。
当所有 AI 输出都趋同、平庸、充满标准化套路时,真实的个人经历、独特的语气语感、鲜活的情绪表达、原生的幽默感,反而成了最稀缺的内容资产。 尤其是幽默、深度共情、个性化洞察这类高阶表达,始终是 AI 的明显短板。人类创作者的个体经验、人生阅历、独特视角,是单一模型永远无法复制的核心竞争力。
与其焦虑 AI 替代,不如打磨属于自己的表达风格 —— 那些带着真实印记、笨拙却鲜活、独属于个人的内容,才是 AI 时代内容创作者最稳固的护城河。
 AI 速览