AI 速览
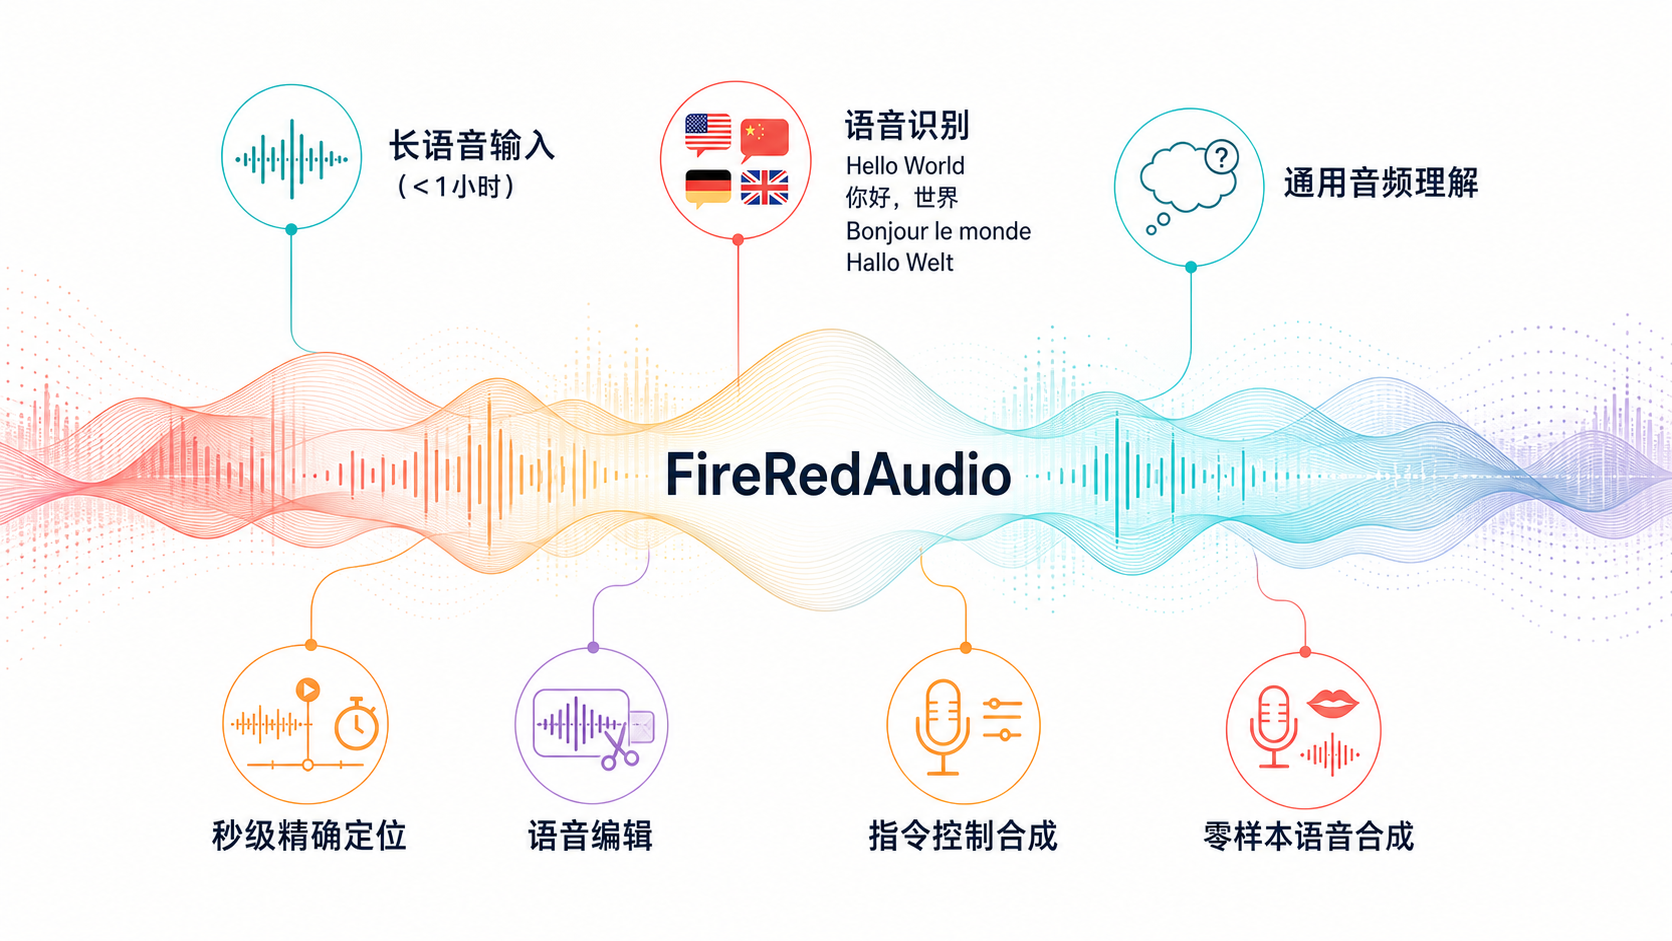
小红书 FireRed 团队开源统一音频模型 FireRedAudio,一个 9B 模型同时支持 ASR、音频理解、TTS 和语音编辑,适合语音产品开发者快速集成全栈能力。 核心事实 - 模型架构:基于 Qwen3.5 的 9B 自回归语言模型,理解与生成使用两套独立音频表征(12.5 Hz Audio Encoder / 6.25 Hz RedAE-Patch) - 能力覆盖:支持语音识别(ASR)、音频理解(含思维链)、zero-shot TTS、Instruct TTS、语音编辑(语义/声学)和音色设计 - 多语言支持:仅 ASR 支持多语言,其余功能限中英双语;最长可处理约一小时录音并实现时间对齐 - 开源协议:代码与权重以 Apache-2.0 协议发布于 GitHub 和 Hugging Face,允许商用 - 技术创新:首次公开披露“理解与生成解耦表征、共享语言骨干”的统一音频模型设计 避坑提示 - 性能数据仅为官方自测,部分竞品分数由团队自行复测,尚无第三方验证 - zero-shot TTS 输出具有随机性,需固定随机种子才能复现结果 - 声音克隆功能明确标注“仅供学术研究用途” 关键数据 - 音频理解:MMAU test 得 80.9,MMSU 得 83.3,均列对比表第一 - 语音合成:Seed-TTS-Eval 中英平均 CER/WER 为 1.20,优于 Qwen3-Omni-30B-A3B-Instruct(1.23) 价值点 为开发者提供了一个可直接部署的轻量级全栈语音模型方案,降低构建多任务语音系统的复杂度与成本。
# 报错信息分析与调试指南 ## 任务说明 请分析用户提供的报错信息,推测可能的错误原因,并提供系统性的调试步骤。 ## 分析要求 1. **错误类型识别** - 确定是语法错误、运行时错误、逻辑错误还是环境配置错误 - 识别具体的错误类别(如空指针、数组越界、类型不匹配等) 2. **原因推测** - 基于错误信息中的关键线索进行合理推断 - 考虑常见的导致此类错误的编程场景 - 分析可能的代码问题或环境问题 3. **调试步骤** - 提供从简单到复杂的逐步调试方法 - 包括代码检查、日志添加、环境验证等具体操作 - 给出预防类似错误的最佳实践建议 ## 输出格式 - **错误类型**:[具体的错误分类] - **可能原因**: 1. [原因1] 2. [原因2] 3. [原因3] - **调试步骤**: 1. [步骤1] 2. [步骤2] 3. [步骤3] 4. [步骤4] - **解决方案**:[具体的修复建议] ## 示例 **输入**:【报错信息】 ``` TypeError: Cannot read property 'length' of undefined at processData (app.js:25:18) at main (app.js:10:5) ``` **输出**: - **错误类型**:运行时错误 - TypeError - **可能原因**: 1. 变量未正确初始化就被访问其 length 属性 2. 函数参数传递了 undefined 值 3. 异步操作中数据还未加载完成就尝试访问 - **调试步骤**: 1. 检查 app.js 第25行附近的变量声明和赋值 2. 在访问 length 属性前添加类型检查:`if (variable && variable.length)` 3. 使用 console.log() 输出相关变量的值确认其状态 4. 检查函数调用时传入的参数是否正确 - **解决方案**:在访问对象属性前先验证对象是否存在,或确保变量在使用前已被正确初始化。