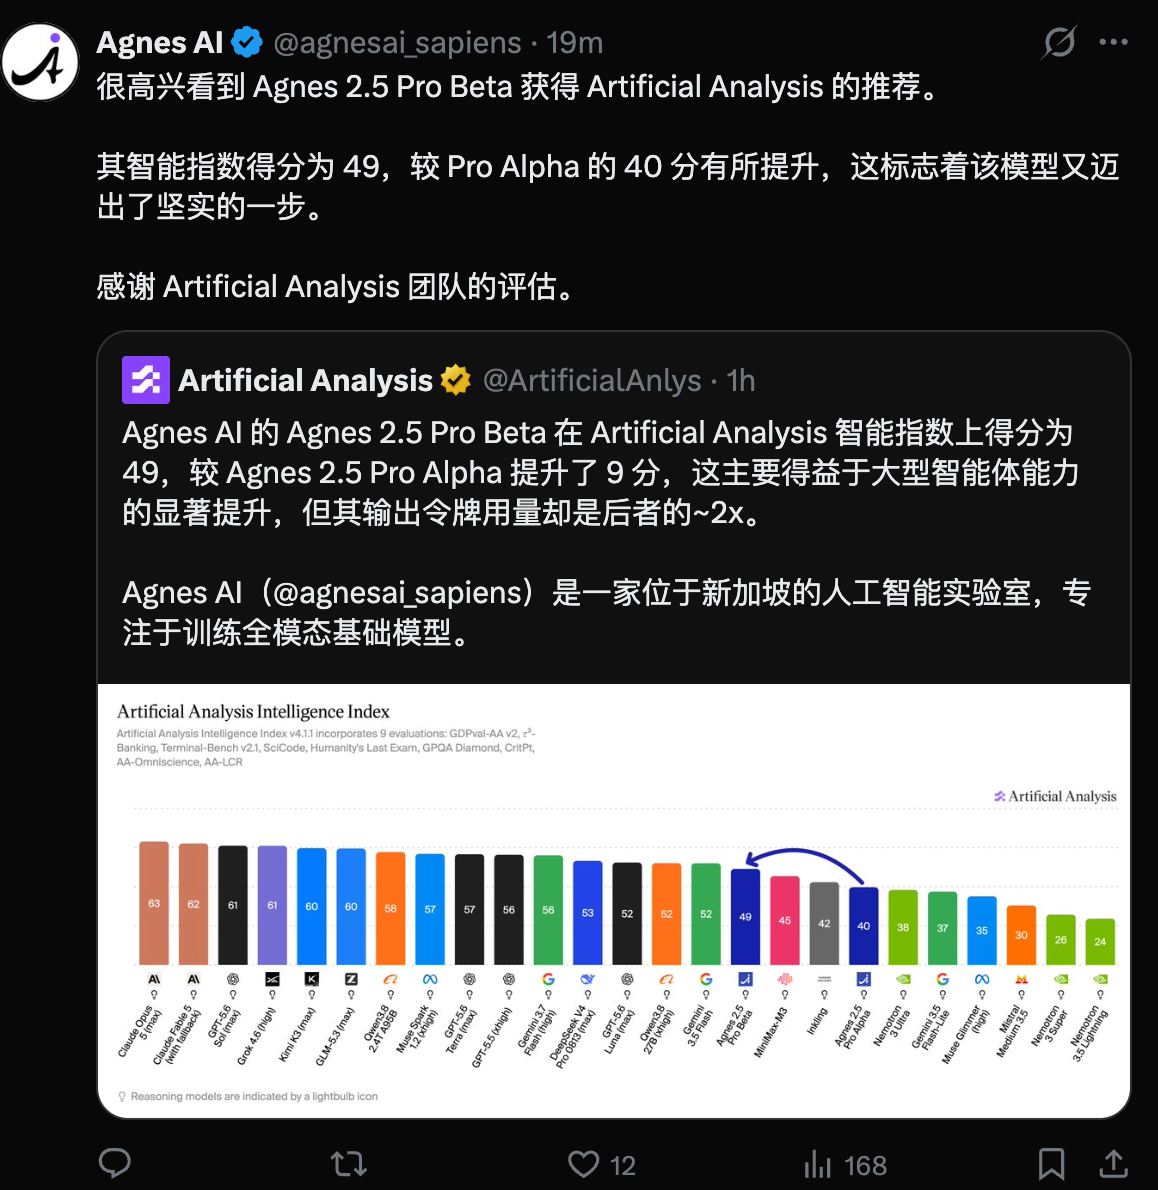
8月28日消息,新加坡人工智能实验室 Agnes AI(Sapiens AI)发布付费推理模型 Agnes 2.5 Pro Beta,已在其官方 API 开放。Artificial Analysis 智能指数(v4.1.1)给出 49 分,较上一代 Alpha 版的 40 分提高 9 分——按该机构口径,这一位置低于 Gemini 3.5 Flash(high,52 分)和 GPT-5.6 Luna(max,52 分),高于 MiniMax-M3(45 分)。 分数涨在 agent,不涨在推理
拆开构成看,这次跃升几乎全部来自代理能力。Artificial Analysis 的分析显示,Agentic Index 从 25 分升至 44 分,高于 Gemini 3.5 Flash(high)的 40 分;τ³-Banking 从 12% 升至 36%,接近原来的三倍;GDPval-AA v2 的 Elo 评分从 1171 升至 1456。模型在终端工作流上也拿到 Terminal-Bench v2.1 的 70%。
前沿推理项的变化则温和得多:Humanity's Last Exam 从 34% 到 38%,GPQA Diamond 从 88% 到 91%,CritPt 从 11% 到 16%。
另一个值得单独看的指标是 AA-Omniscience,从 -25 改善到 -11。改善的来源不是模型答得更准,而是更会选择不答:Beta 的作答率从 Alpha 的 94% 降到 45%,幻觉率随之从 88% 降到 33%,但准确率本身从 33% 减半到 17%。这个指标奖励弃答、惩罚幻觉,弃权策略直接换来了分数。
用 token 换分数,但价格压得很低
分数的另一个成本写在用量上:Beta 在每个智能指数任务中消耗约 5 万输出 token,是 Alpha(约 2.4 万)的两倍以上,输出风格偏长。对按 token 计费的用户,账面低价和实际账单之间要打个折扣。
不过账面价格确实激进。官方定价为每百万 token 输入 0.10 美元、输出 0.30 美元、缓存命中 0.01 美元,输出速度约 157–160 token/s。模型本身规格不低:100 万 token 上下文、最大输出 65,536 token、支持文本和图像输入,API 兼容 OpenAI 格式,也提供 Responses 和 Anthropic Messages 风格端点。
谁在做 Agnes,49 分该怎么读
Agnes AI 是位于新加坡的实验室,对外定位是训练全模态基础模型并通过免费全模态 API 提供——其 Flash 系列目前仍有免费额度,2.5 Pro Beta 是面向更重任务的付费档。
agentic 能力确实大涨,推理能力只是温和改善,总分里还有一部分来自弃权策略和翻倍的 token 消耗。对预算敏感、需要长上下文和 agent 工作流的开发者,这是一个便宜且不算慢的新选项——有 49 分、0.10 美元的输入价和 157 token/s 的速度作证。但"接近前沿梯队"目前只在 Artificial Analysis 一家的口径下成立,分数怎么构成的,比排第几更能说明这个模型的真实位置。
 AI 速览