- Seedance 2.5、Kling 3.0、Veo 3.1 这一代模型画质已经够强,短板在空间一致性:多镜头之间运镜漂移、角色走位对不上。
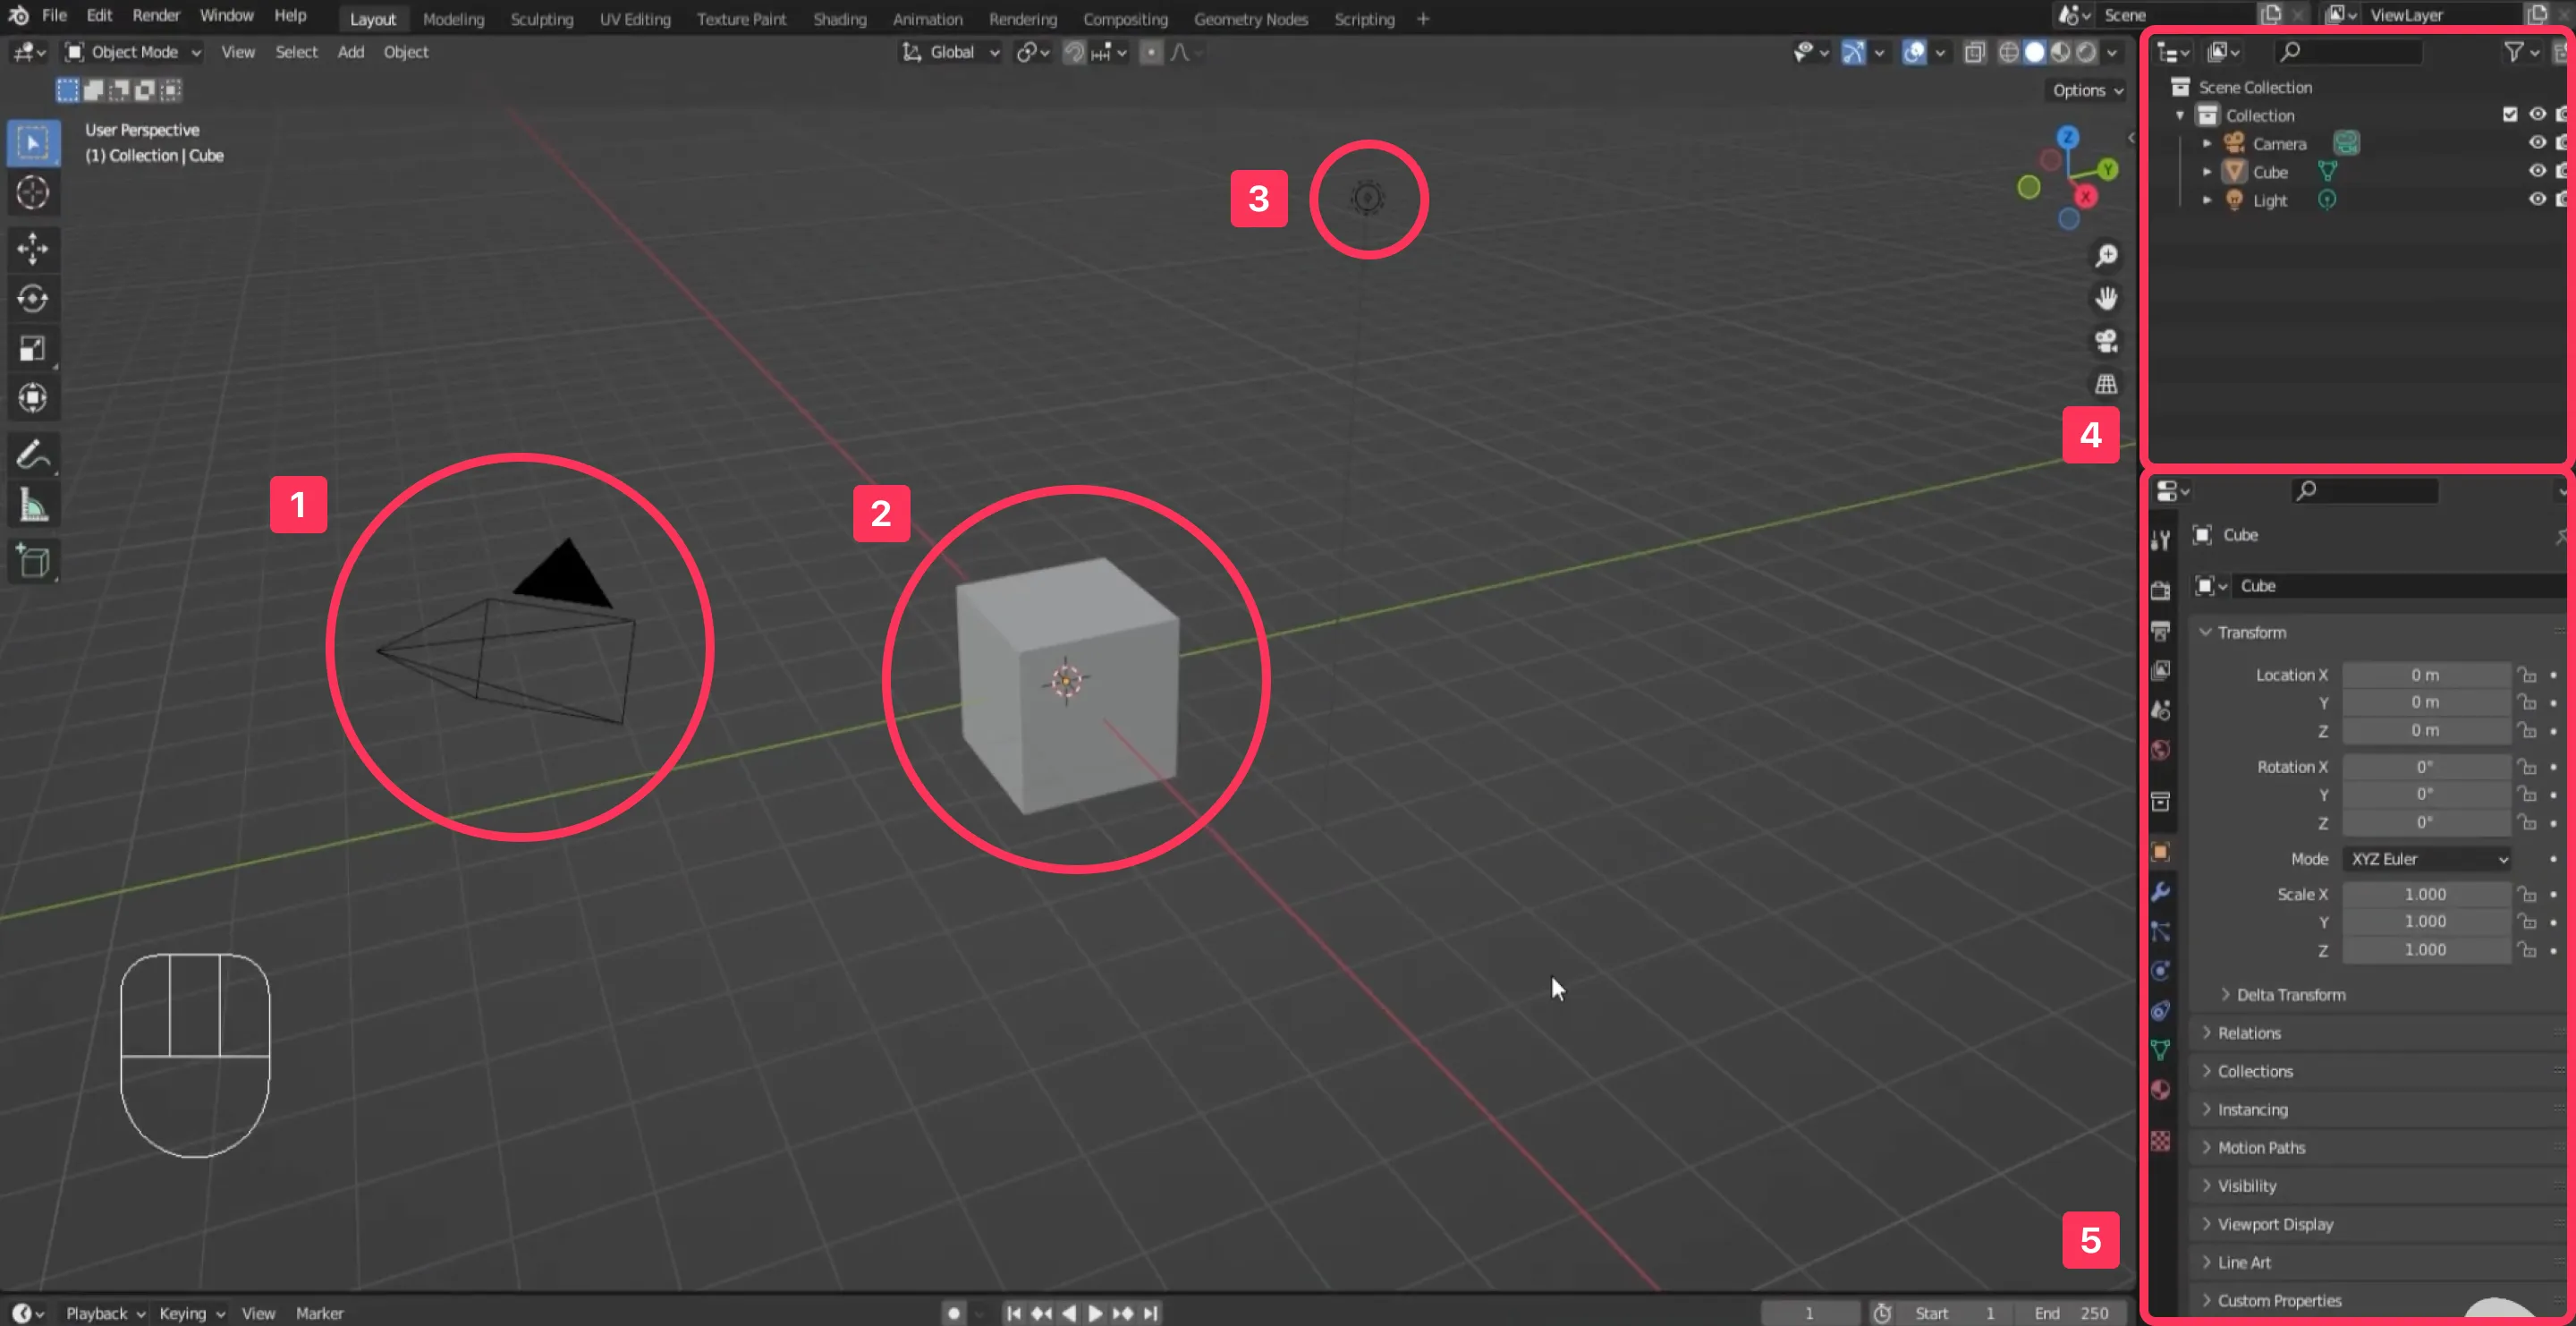
- Blender 灰盒预演补的是导演能力:用立方体和圆柱体搭场景、精确摆相机,渲染一段低质量参考视频交给模型复刻。
- 这条思路 2023–2024 年的 ControlNet 图生图时代已经存在:Blender 渲染深度、姿态、线稿图逐帧控制 Stable Diffusion,现在升级为整段参考视频。
- Seedance 2.5 官方支持 motion reference,单次生成 30 秒、最多 50 个参考输入;Kling 3.0 与 Veo 3.1 也有对应的多参考机制。
- 标准工作流四步:灰盒搭建、相机与关键帧、低质量渲染、参考视频加首帧喂给模型。
- 边界同样明确:单角色单机位直接图生视频更快;约束给得越多,模型的“生成魔法”越少。
AI 视频模型缺什么:会画画,不会当导演
这一代顶级模型的画质已经不是问题。字节的 Seedance 2.5 支持单次生成 30 秒、原生 4K 加同步音频,最多接受 50 个多模态参考输入;快手 Kling 3.0 在动作物理和多场景叙事上口碑很好;Google 的 Veo 3.1 提供名为 Ingredients to Video 的参考生成机制。单看一个镜头,光影、材质、人物质感都已经是电影级。
问题出在镜头之间。这些模型没有持久的 3D 空间记忆——镜头怎么走、角色三秒后站在哪、两个镜头之间的空间关系是否连续,模型每一次都要重新猜。AI 影视平台 Flick 在 Blender 拍摄指南里把这概括为一句话:模型是出色的渲染器,但很差的导演。结果就是创作者熟悉的体验:单镜头好看,一接就漂,想要的推轨、环绕、手持抖动做不准,只能一遍遍抽卡。
快速上手:灰盒预演四步把镜头语言喂给模型
Blender 补的正是导演这一环。做法从传统影视工业的 Previs(预演)借来:先用最粗糙的几何体搭场景,把镜头语言精确确定下来,再把运动信息交给生成模型,让它负责最终观感。社区里流传的一句话是“控制即自由”——你负责镜头语言和空间调度,AI 负责把灰盒画成电影级画面。
具体分四步:
- 在 Blender 里用立方体当楼、圆柱体当人,搭出灰盒场景。只保证空间关系正确,不做材质和细节。
- 精确摆放相机:焦距、推拉摇移的路径、手持抖动的幅度、关键帧节奏,全部在这一步定死。
- 渲染一段低质量参考视频,用 EEVEE 或 Workbench 视口预览直接输出即可,同时导出首帧。
- 把参考视频、首帧和风格参考一起交给模型。Flick 的做法是先用 Nano Banana 按原构图重绘首帧,再把首帧作为起始帧、灰盒视频作为 motion reference 交给 Seedance,提示词可以很短,因为大部分信息已由参考视频携带。
社区的公开案例验证了这条路的可行性。腾讯云开发者社区整理的《25 个实战案例》里,创作者 noman23761 的做法是典型:立方体、圆柱体、球体搭场景,在 Blender 里做好相机运动,最后把参考视频和起始帧输入模型——环绕推进的镜头被完整复刻,几何体变成了写实城市与人像。
这条思路从哪来:ControlNet 时代就在用 Blender
Blender 进入 AI 生成流程,不是 2026 年的新发明。2023 到 2024 年的图生图时代,它已经是常见的控制工具,只是当时控制的对象是“每一帧图”:在 Blender 里搭白模或灰盒,甚至只摆一台摄像机,渲染出深度图(Depth)、法线图(Normal)、线稿(Canny)、OpenPose 姿态图,或者一张很素的底图,再把这些控制图丢进 Stable Diffusion 做图生图。要做动画,就导出整序列控制图,靠 AnimateDiff、Deforum 或逐帧重绘跑完。
那时的分工和现在完全一致:Blender 负责空间、透视、镜头和走位,AI 负责画面质感。Seedance 这一代模型改变的是模型“吃”控制信息的方式,对比大致如下:
| |
|---|
逐帧渲染 Depth / Normal / Canny | |
| |
| |
| |
核心没有变,还是 3D 负责导演、AI 负责画。变的是模型终于能稳定地吃下整段运动,创作者不用再一帧一帧抠 ControlNet。
不会 Blender 的三个入口
这条工作流的门槛在下降,不同熟练度有不同的入口。会一点 Blender 的,直接从灰盒预演和 camera blocking 开始,成本最低。完全没碰过 3D 软件的,可以走动作库路线:Mixamo 提供现成的角色动画,导出 FBX 进 Blender 绑到替代模型上,不需要自己做动画。
第三个入口是 Blender MCP。给 Blender 装上 MCP(Model Context Protocol)服务后,Claude 等 Agent 可以用自然语言直接操作场景——“搭一个环绕角色的 5 秒推轨镜头”,模型自动建场景、设相机动画、导出参考视频。Reddit、YouTube 和 TikTok 上已经有一批 Blender MCP 配合 Seedance 的演示,EvoLink 把整条从 Blender 到视频的流程做成了 Agent 原生编排。X 上一篇工作流总结给出的建议是:不熟 Blender 的创作者,从 Mixamo、FBX 和 Blender MCP 入手。 工具链:从 Pallaidium 到 NVIDIA 蓝图
围绕“Blender 当中间控制层”,工具链已经长了出来。Pallaidium 是最完整的一个:开源的 Blender 视频序列编辑器(VSE)插件,把文本、图像、视频、语音的生成能力直接接进剪辑时间线,从剧本到成片可以在同一个软件里完成。NVIDIA 发布的 3D-Guided Generative AI 蓝图则把 Blender、ComfyUI 和 FLUX.1-dev 串成本地方案:Blender 里的几何与深度数据经 ComfyUI 节点传给 FLUX 生成图像,全程跑在 RTX 显卡上。更细的控制环节还有 fSpy(相机匹配)、toyxyz 的 OpenPose 式角色绑定和 ComfyUI-BlenderAI-node。
这些工具指向同一个变化:Blender 正在从“3D 建模软件”变成 AI 视频创作的中间控制层——上面接创作者的镜头意图,下面接生成模型。
适用边界:什么时候不该用 Blender
这条工作流不是万能的。单角色、单机位、简单动作的镜头,直接图生视频更快,先建灰盒反而多一道工序。它真正的收益场景是多镜头叙事、复杂运镜、需要角色走位精确的短片、广告和漫剧。
约束与生成自由度之间的取舍也要心里有数:3D 约束给得越多,画面越可预期,模型自发的“生成魔法”就越少。Flick 的指南还提到两个实操细节——灰盒越简陋效果反而越稳,塞太多细节会干扰模型;想本地跑完整管线,图像任务 16GB 显存是实际下限,视频任务建议 24GB 或直接用云端生成。
行动清单
- 多镜头短片先建灰盒再生成;单镜头素材直接图生视频,别为了流程而流程。
- 灰盒只保证空间关系和相机轨迹正确,材质和细节交给模型,塞太多细节反而干扰生成。
- 参考视频用视口预览输出就够,重点是相机路径和走位节奏,不是渲染质量。
- 首帧单独重绘成目标画风,再和参考视频一起喂给模型,构图与质感分开控制。
- 不熟 Blender 就从 Mixamo 动作库或 Blender MCP 入手,让动作库和 Agent 补操作差距。
 AI 速览