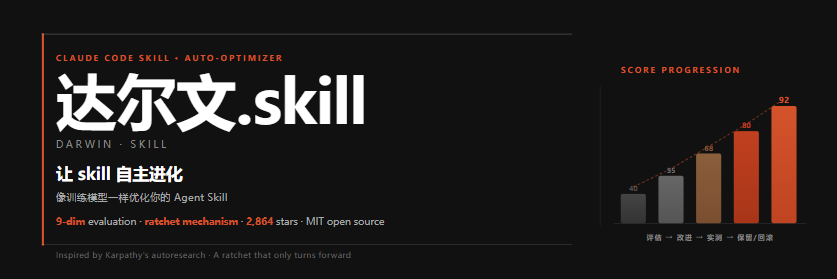
你写的Skill是不是写完就扔?达尔文.skill把Karpathy autoresearch那套"自动实验、只保留有效改进"的思路搬到了Skill优化上。它让Claude Code按多维度给你的SKILL.md打分,找出最弱的环节针对性改进,跑测试验证效果,只保留实测有提升的版本。分数不涨就回滚,绝不将就。 达尔文.skill到底在做什么
作者是alchaincyf,2026年4月发布初版,5月升级到v2.0。核心思路来自Karpathy的autoresearch项目——一个让AI自主实验、自动迭代的框架。Karpathy拿它优化模型训练脚本,达尔文.skill把同一套逻辑搬到了Skill优化上。
说白了,它让Claude Code自动读取你的SKILL.md,按维度打分,找出最拉胯的那一项,针对性改进,再用独立子agent跑测试prompt验证效果。新分数比旧的高,留下;否则git revert回滚。最多跑三轮,每轮只改一个维度。 改完一轮它会暂停,给你看三样东西:改了什么(git diff)、分数怎么变的、测试prompt的输出对比。你点了头,才继续下一个。
多维度评分:模糊感变成具体数字
v2.0版本的评分体系在原有基础上做了扩展,总分100。结构部分靠静态分析,效果部分必须实测。
| | |
|---|
| | name规范、description含触发词、不超1024字符 |
| | |
| | |
| | |
| | |
| | |
| | |
| | 跑测试prompt,对比有无Skill的输出质量差异 |
v2.0还从微软SkillLens论文里吸收了三项新指标:失败模式编码(有没有显式写出已知失败路径)、可执行具体性(是否禁用"建议""视情况而定"这类模糊措辞)、高风险行动黑名单(rm或git reset --hard这类破坏性操作有没有明文禁止)。
"实测表现"这一项权重最高,占25分。它不看你SKILL.md写得规不规范,而是真跑一遍,看带着这个Skill的Claude比不带的强多少。写得再漂亮,跑出来效果不好就是白搭。
棘轮机制:只进不退
每次改完,系统会重新打分。新分数必须严格高于旧分数,改动才会被保留。否则直接git revert回滚——注意是revert,不是reset --hard,历史记录完完整整留着。
所有实验都在git分支上跑,分支名带时间戳,每次尝试都有commit,每次回滚都有记录。
你随时能翻到任意版本,随时能回到过去某个状态。
三种用法,从摸底到动手
全量优化(推荐第一次用)
先给所有Skill打基线分,生成评分卡,从最低分的开始动手。评分卡长这样:
你看完这张表,再决定先动哪个。
单个优化
直接说"优化huashu-slides",只对这一个跑完整流程。
只评估不改
摸底看看家底,适合想先了解情况再动手的人。
darwin-skill安装方法
每个Skill优化完,系统会生成一张可视化成果卡片,存成PNG。风格有几种可选:暖白底配赤陶橙的干净网格风、近黑底配荧光绿的终端风、或者暖白纸配深红的报纸编辑风。卡片上有Skill名字、优化前后分数、各维度的变化、主要改进摘要,还有那句"Train your Skills like you train your models"。
安装现在用一行命令就行:
装完在Claude Code里说"优化所有skills"或者"优化某个skill"就能用。微软后来也把这个项目列进了SkillOpt的官方集成名单。
它的价值与局限
这个工具解决了一个真实存在但很少被正视的问题:Skill写完之后没人管。
大多数人的做法就是写一版,用一用,感觉不对就手动改,改完继续用。没有评分,没有对比,没有版本控制,没有验证。改好了还是改坏了,全凭手感。
达尔文.skill把这个过程结构化了。多维度评分给了你一个可以讨论的语言,棘轮机制保证不会越改越差,git历史让每次改动都可追溯,实测验证让"效果"有了具体衡量标准。
不过它也有局限。效果评分依赖子agent跑测试,环境不对的时候可能退化成模拟推演,准确性会打折。而且Skill好坏本来就有主观成分,分数高不代表你用起来一定顺手。
但作为一个让你开始认真对待Skill质量的工具,它已经够用了。
你现在用的Skill,上次认真审查是什么时候?如果答案是想不起来,也许该让达尔文帮你跑一轮评估了。花不了多少时间,至少你能知道它们到底处在什么水平。
 AI 速览