AI 视频创作中,人物替换与动作复刻是高频需求,但传统纯提示词驱动的生成方式,始终存在动作不准、构图错位、道具变形等问题,难以满足商业级的 1:1 复刻要求。近期 LibTV 上线的深度动作捕捉功能,给出了新的解决方案:通过剥离视觉干扰、精准提取动作与运镜轨迹,实现视频动作的高精度复刻,让 AI 视频的可控性从画面风格延伸到了动作层面。 一、传统视频复刻的核心痛点:元素边界难以精准拆分
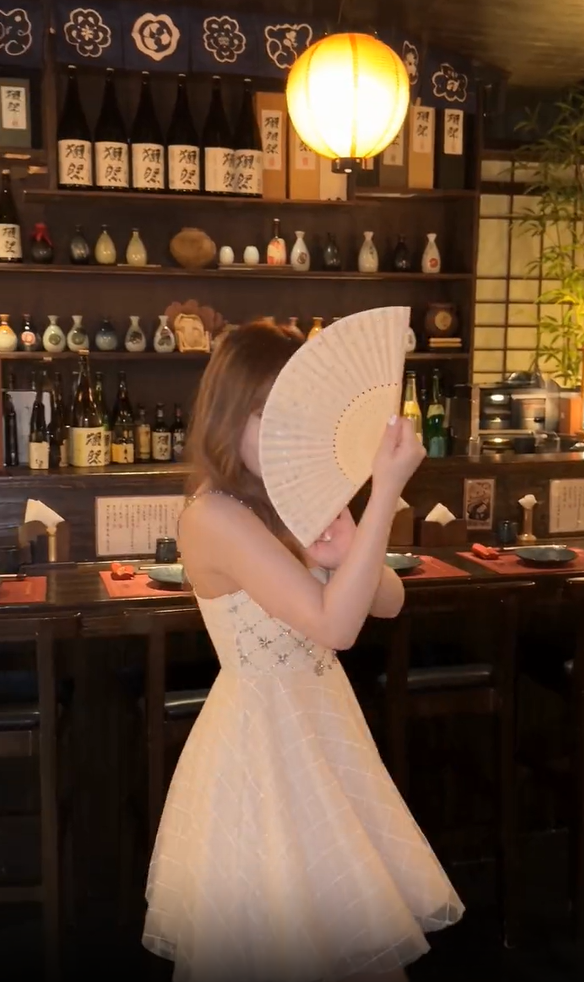
日常创作中,将参考视频里的动作迁移到指定人物身上是高频场景。常规操作是输入原视频 + 人物参考图,靠文字提示词约束 “保留动作、替换人物”,但实际效果往往差强人意。
核心原因在于视频承载的信息维度远多于图片:除了人物动作,还包含背景、光线、构图、运镜节奏等多层元素。AI 无法精准区分哪些元素需要保留、哪些需要替换,最终往往出现景别错位、人物比例失调、道具形态变形等问题。如果是商业级交付标准,仅靠文字 Prompt 的生成效果基本无法达标。
二、深度动作捕捉的原理:剥离干扰 只保留动作轨迹
深度动作捕捉的核心逻辑,是做 “信息减法”:只精准提取原视频中的人物动作轨迹、姿态节奏、走位路径、镜头运动方式与空间关系,主动剥离人物外貌、服装、妆容、背景场景等容易干扰生成的视觉信息。
处理后会输出一段黑白的动作参考视频,去除了所有冗余视觉细节,只保留人物在空间中的运动骨架。这样再交给 AI 生成时,模型就能精准聚焦动作本身,不会被多余的画面元素带偏,从根源上保障 1:1 的动作还原度。
三、LibTV 实操流程与双场景实测验证
LibTV 的深度动作捕捉功能操作门槛低,完整流程分为动作提取与视频生成两步。
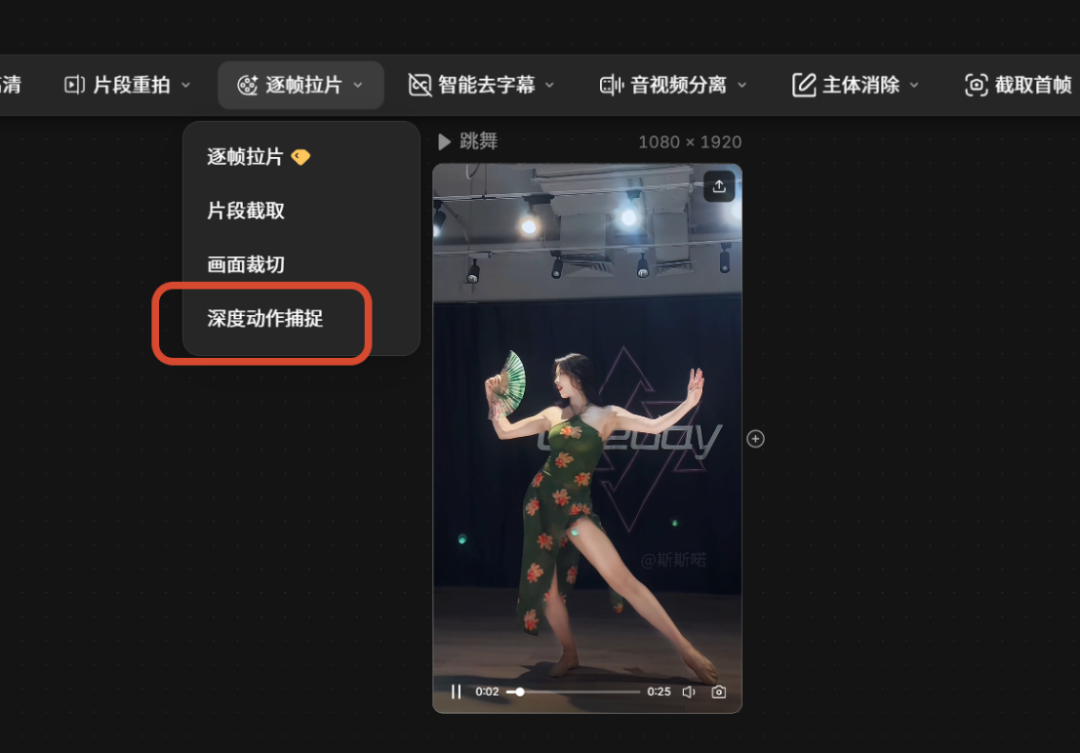
操作层面,上传视频至画布后,在顶部工具栏选择 “深度动作捕捉”,推荐选择 720P 分辨率以平衡精度与效率;时长建议控制在 20 秒以内,过长视频可分段处理,避免细节丢失。若原视频分辨率过低,平台自带视频高清修复功能,可提升至 1080P 后再处理。生成动作参考后,搭配标准化提示词模板 + 人物参考图,即可生成新的人物视频。
实测分为两个场景验证精度:
单人舞蹈场景中,持扇舞蹈的动作顺序、节拍节点、手臂角度、重心转移、运镜构图均高度还原,扇子道具也完整参与动作,首轮直接生成的各类错位问题全部解决;
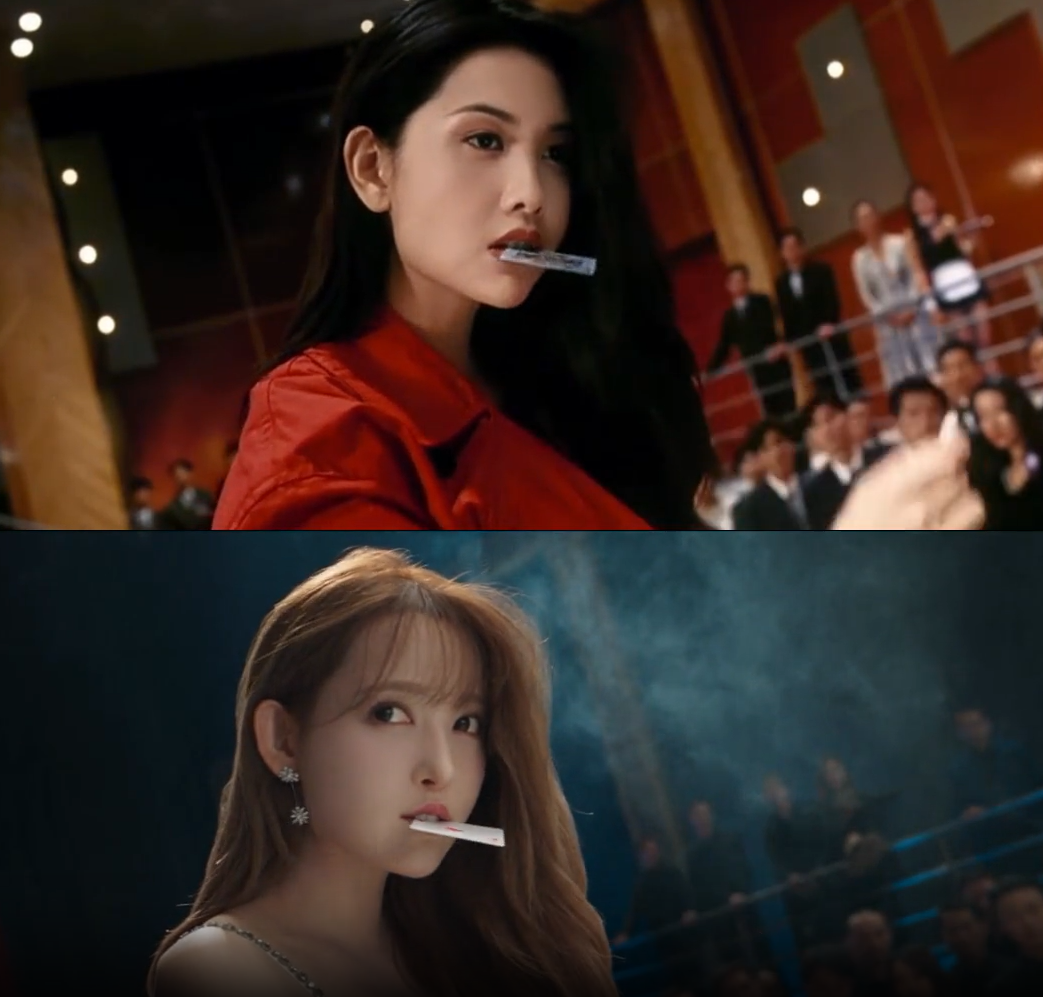
多人动作戏场景中,经典叼牌打斗片段的复杂动作链、节奏节点、机位快速切换均精准复刻,多人互动的空间关系也准确对应,验证了复杂场景的适配能力。
四、行业价值:从 “说清楚” 到 “演给看” 的效率升级
深度动作捕捉的落地,标志着 AI 视频的可控维度进一步拓展:从画面风格、人物形象,延伸到了动作、运镜与空间关系。 过去创作者需要把动作拆解成文字描述,不仅效率低,还容易出现信息偏差。而 “直接演给 AI 看” 的模式,省去了复杂的 Prompt 调试,大幅提升了动作复刻的精度与效率。对于短视频、短剧、广告等商业场景,这种精准可控的动作迁移能力,能大幅降低试错成本,让 AI 视频工具真正贴合工业化生产的需求。
整体而言,深度动作捕捉解决了长期以来视频动作复刻 “描述不清、还原不准” 的痛点。当 AI 能精准看懂动作本身,创作者就能从繁琐的 Prompt 调试中解放出来,把精力更多放在创意本身。这种更贴近真实生产流程的功能迭代,也会推动 AI 视频从创意玩具逐步走向成熟的生产工具。
 AI 速览