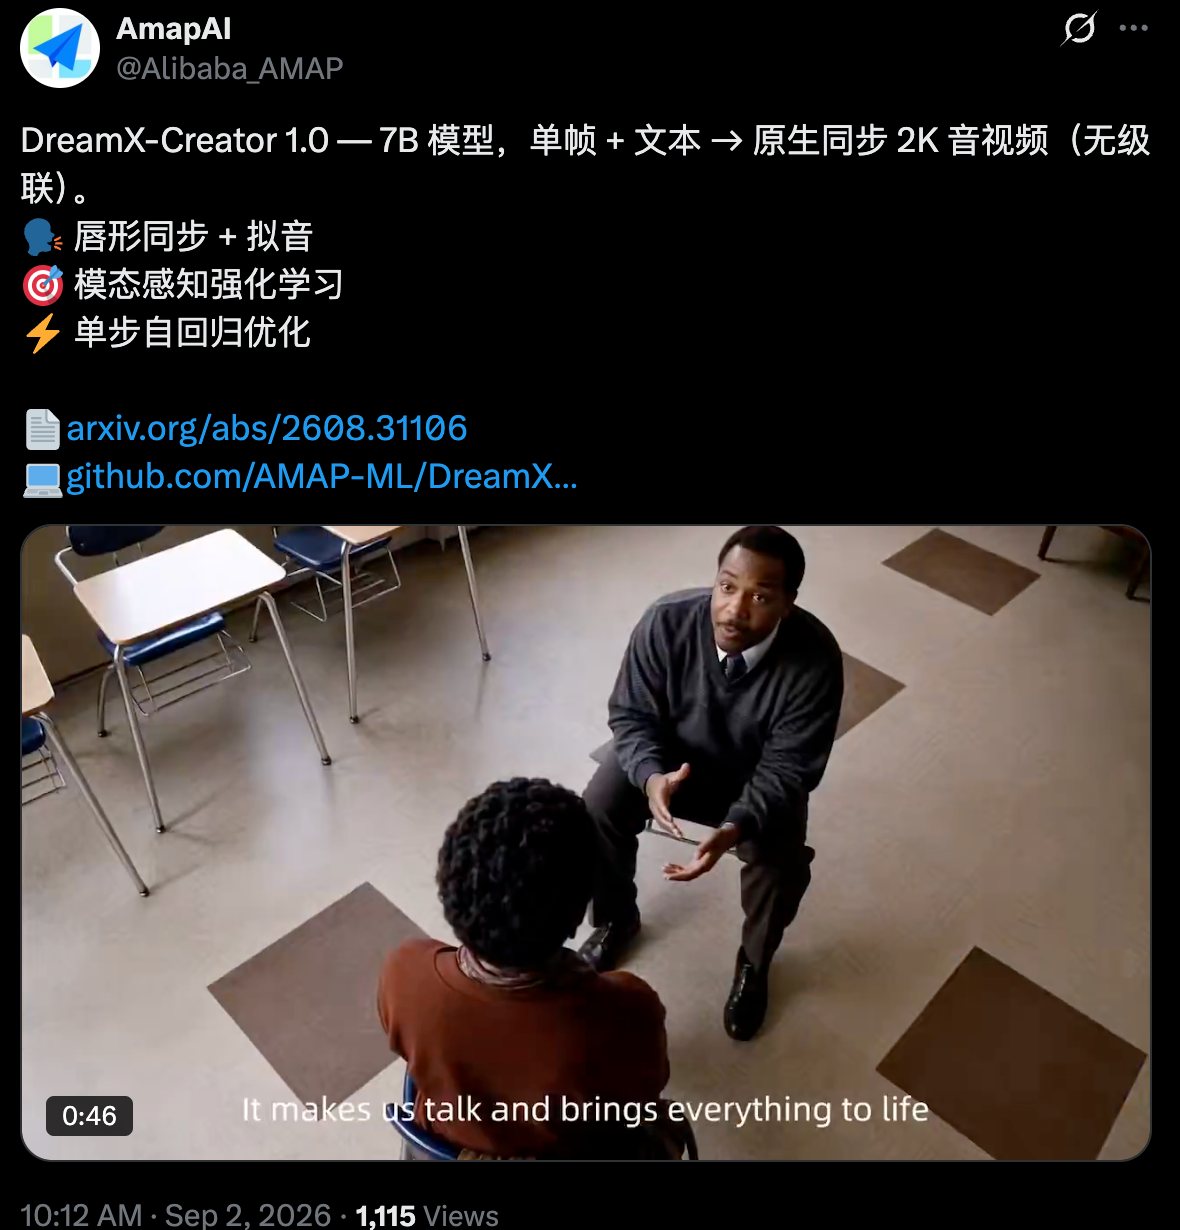
9月2日消息,高德旗下机器学习组织 AMAP-ML 的 DreamX 团队发布音视频生成模型 DreamX-Creator 1.0 :这是一个 7B 的生成器,输入首帧图像加文本提示,视频与音频两条流在同一个模型里联合去噪,一次输出 2K 分辨率的原生同步音视频。仓库已在 GitHub 初始化并采用 Apache-2.0 许可证,模型权重与推理代码承诺开源,目前尚未放出。
"原生同步":不是先出视频再配音
多数音视频生成走的是级联路线:先生成画面,再用另一个模型配音,音画同步靠后处理对齐。DreamX-Creator 的论文把这条路列为批评对象:以往把音频放在单独阶段合成的做法,容易产生同步误差。它的做法是让视频流和音频流联合去噪:网络前半段两条流各自独立处理,后半段通过带门控的跨模态注意力耦合,生成时就互相看见对方的状态。
对齐粒度做到了细粒度的音画同步。官方称,模态感知的强化学习会把视频、音频和跨模态三类反馈分别路由到对应的流,配合两阶段联合预训练与高质量微调,用来提升画质、音频质量与语义一致性。
7B 的生成器,一步到 2K
规格上,生成器是 7B 参数。2K 输出靠一条自回归一步精修管线:团队把多步双向的教师模型蒸馏成每个时间块只需一次去噪评估的学生模型,升到 2K 的同时保留内容、运动和音频时序的对齐。
官方在论文标题里用的词是"民主化"(Democratizing):7B 的规模加单步精修,目标是以更低的门槛对标开源最强模型。论文自评性能与开源 SOTA 相当,这是自评口径,权重放出前没有第三方验证。
开源状态:仓库已建,权重未到
GitHub 上的 AMAP-ML/DreamX-Creator 仓库 9月1日初始化,许可证为 Apache-2.0,目前只有 README、许可证文件和一张示意图。路线图里"发布验证过的模型权重、推理代码、配置和评估工具"一项尚未完成,权重放出时间未公布。上线一天,仓库已收到 105 个 star。
团队署名 DreamX Team,论文作者共十人。致谢名单里点名了 Wan2.2 与 OpenMOSS 的 MOVA,两个此前的开源音视频生成工作,也间接说明了它对标的对象。
音视频生成正在分出两条路线:级联的拼装灵活,原生的同步准确。DreamX-Creator 选了后者,并把宝押在"7B 就够"上。权重如果兑现,会给开源社区增加一个把 2K 与原生同步做进 7B 体量的选项;如果迟迟不放出,技术报告就只是技术报告。
 AI 速览