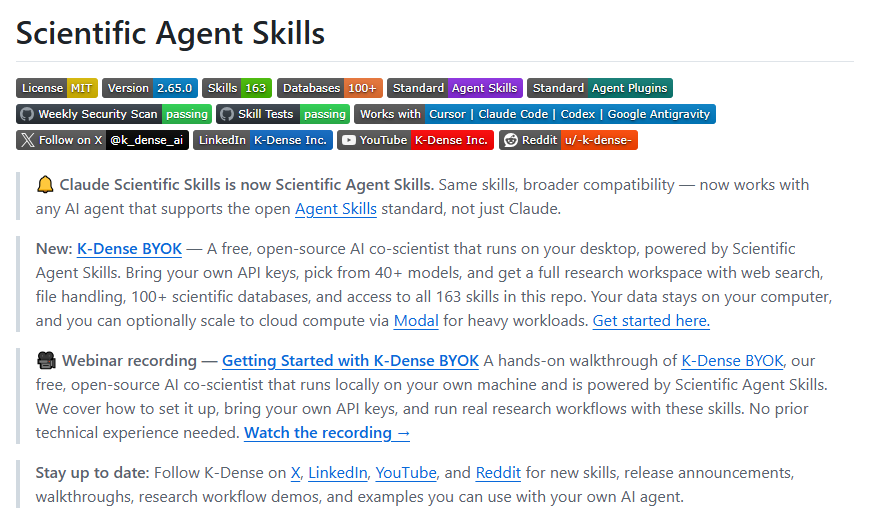
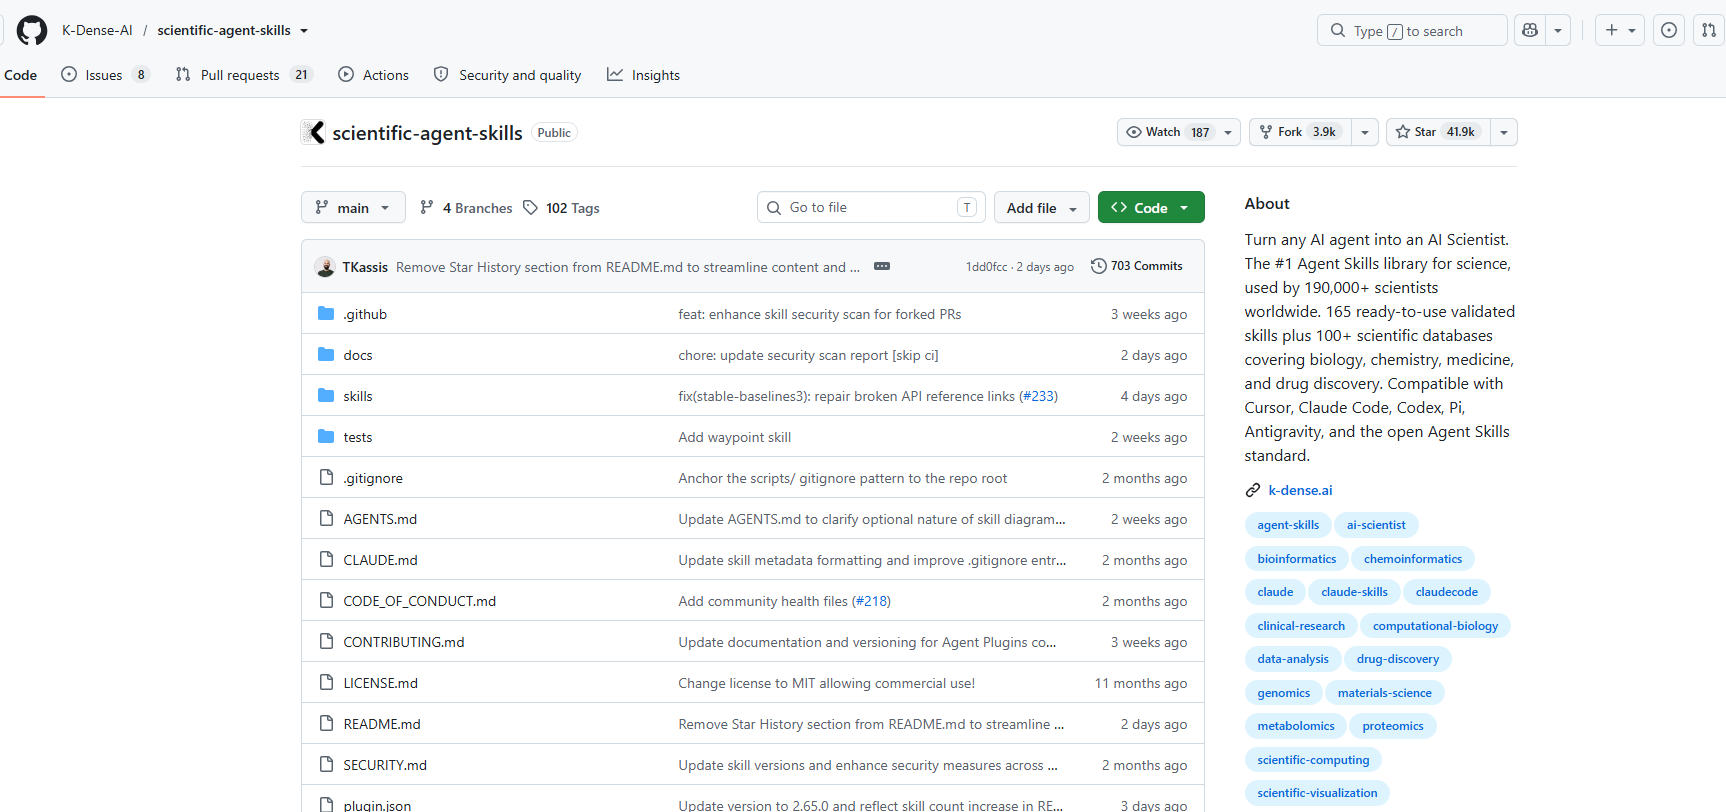
科研这件事,AI Agent 一直啃不动——不是模型不够聪明,是工具链太深。9月1日GitHub趋势榜第9名的scientific-agent-skills ,用165个打包好的"技能插件",试图把这个坎迈过去。项目号称全球19万+科学家在用,单日涨星914颗。
scientific-agent-skills的165个技能都覆盖了什么
文献检索这块,PubMed、bioRxiv、Semantic Scholar、Google Scholar全在里面;化学和生物方向有RDKit做分子操作、ChEMBL数据库查询、UniProt蛋白质检索;统计与可视化涵盖R脚本自动生成、进阶matplotlib绘图、seaborn模板;机器学习部分打包了scikit-learn的pipeline、PyTorch实验流程、AutoML自动建模;论文写作有Nature/Science格式模板、LaTeX编译、参考文献自动整理;数据预处理则是Pandas清洗、缺失值处理、异常值检测这些基础活儿。
每个技能都自带验证脚本,不是那种"甩给你一段Prompt就完事"的东西,是真能直接跑起来的工程化插件。
按项目最新的仓库信息,技能数量其实已经涨到165个,配套的科学数据库接入超过100个,比几个月前的版本又扩了不少,新增了肿瘤基因组学、千人基因组个体级查询、病原体变异实时监测这些细分方向。
跟同类项目比,它强在哪
数量上LangChain Tools其实更多,但它是通用工具箱,什么都想覆盖,反而什么都不深。scientific-agent-skills的护城河就是科研垂直度——别人在做万金油,它是少数真正照着科研工作流去设计的技能库。
上手成本和几个绕不开的限制
装起来不麻烦,一行命令搞定:
npx skills add K-Dense-AI/scientific-agent-skills,或者用GitHub CLI装gh skill install K-Dense-AI/scientific-agent-skills
想只装某个技能也行,加个技能名就够了,比如gh skill install K-Dense-AI/scientific-agent-skills scanpy。
费用方面,跑一次完整的科研workflow——文献综述加实验设计再加报告输出——大概花个几美元,具体要看你用哪档模型:如果搭配Claude Sonnet 5、GPT-5.6或Gemini 3.5这个级别的模型来跑,成本控制得住,但换成更弱的模型,效果会明显打折扣,这是第一个限制。 第二,165个技能里,覆盖的主要是英文科研场景,中文医学、中药、古文献检索方向的技能相对少,国内用户用起来可能得自己补一部分。第三,也是最实际的一点,"实验验证"这个环节Agent替代不了,它只能帮你设计方案、跑数据分析,真正上手做实验还得靠人。
值得一提的是,这个项目最近还多了个新玩法——K-Dense BYOK,一个免费开源、跑在你自己电脑上的AI协作科研工具,自带40多个模型可选,接入100多个科学数据库和全部165个技能,数据不出本地,算力不够还能接Modal云端扩容。
谁比较适合用这个
1、生信研究员做RNA-seq、单细胞分析、变异注释、多组学整合,基本能直接上手;
2、做药化和计算化学的,分子筛选、对接、ADMET预测能一站式跑完;
3、临床研究人员检索ClinicalTrials.gov、ClinVar,出临床报告也方便;
4、数据科学家用得上时序预测(TimesFM)、贝叶斯建模(PyMC)、图神经网络这些细分工具。
5、研究生和博士后可以把它当全能科研助手使,省下不少踩坑的时间;
6、实验室PI想快速验证新方向的可行性,不用专门等人手排期。
两个真实的workflow示例
先看药物发现这一条——寻找肺癌EGFR新型抑制剂
你可以直接对Agent说:让它查ChEMBL数据库里IC50小于50nM的EGFR抑制剂,用RDKit分析构效关系,用datamol生成改良的类似物,针对AlphaFold预测的EGFR结构跑DiffDock虚拟筛选,再去PubMed搜耐药机制、COSMIC查突变情况,最后整理成可视化报告。
Agent接到这个指令,会自动串起database-lookup、rdkit、datamol、diffdock、paper-lookup、scientific-visualization好几个技能,把这条跨数据库、跨工具的多步流程走完。
再看单细胞RNA-seq分析这条
用Scanpy加载10X数据集,做质控和双细胞去除,接入Cellxgene Census数据做整合,用NCBI Gene标记物识别细胞类型,跑PyDESeq2做差异表达分析,用Arboreto推断基因调控网络,通过Reactome和KEGG做通路富集,最后用Open Targets锁定潜在治疗靶点。
搁以前,这套流程得研究员自己一个个查API文档、调环境,两天起步;现在对着Agent说人话,它就能自己跑起来。
科研AI Agent的价值不在模型多能打,而在它能不能真正接进你的数据生态——这大概是这个项目最实在的价值。165个验证过的技能,接上100多个科学数据库,让你手头随便一个AI Agent都变得能干实活,这个方向值得关注。
 AI 速览