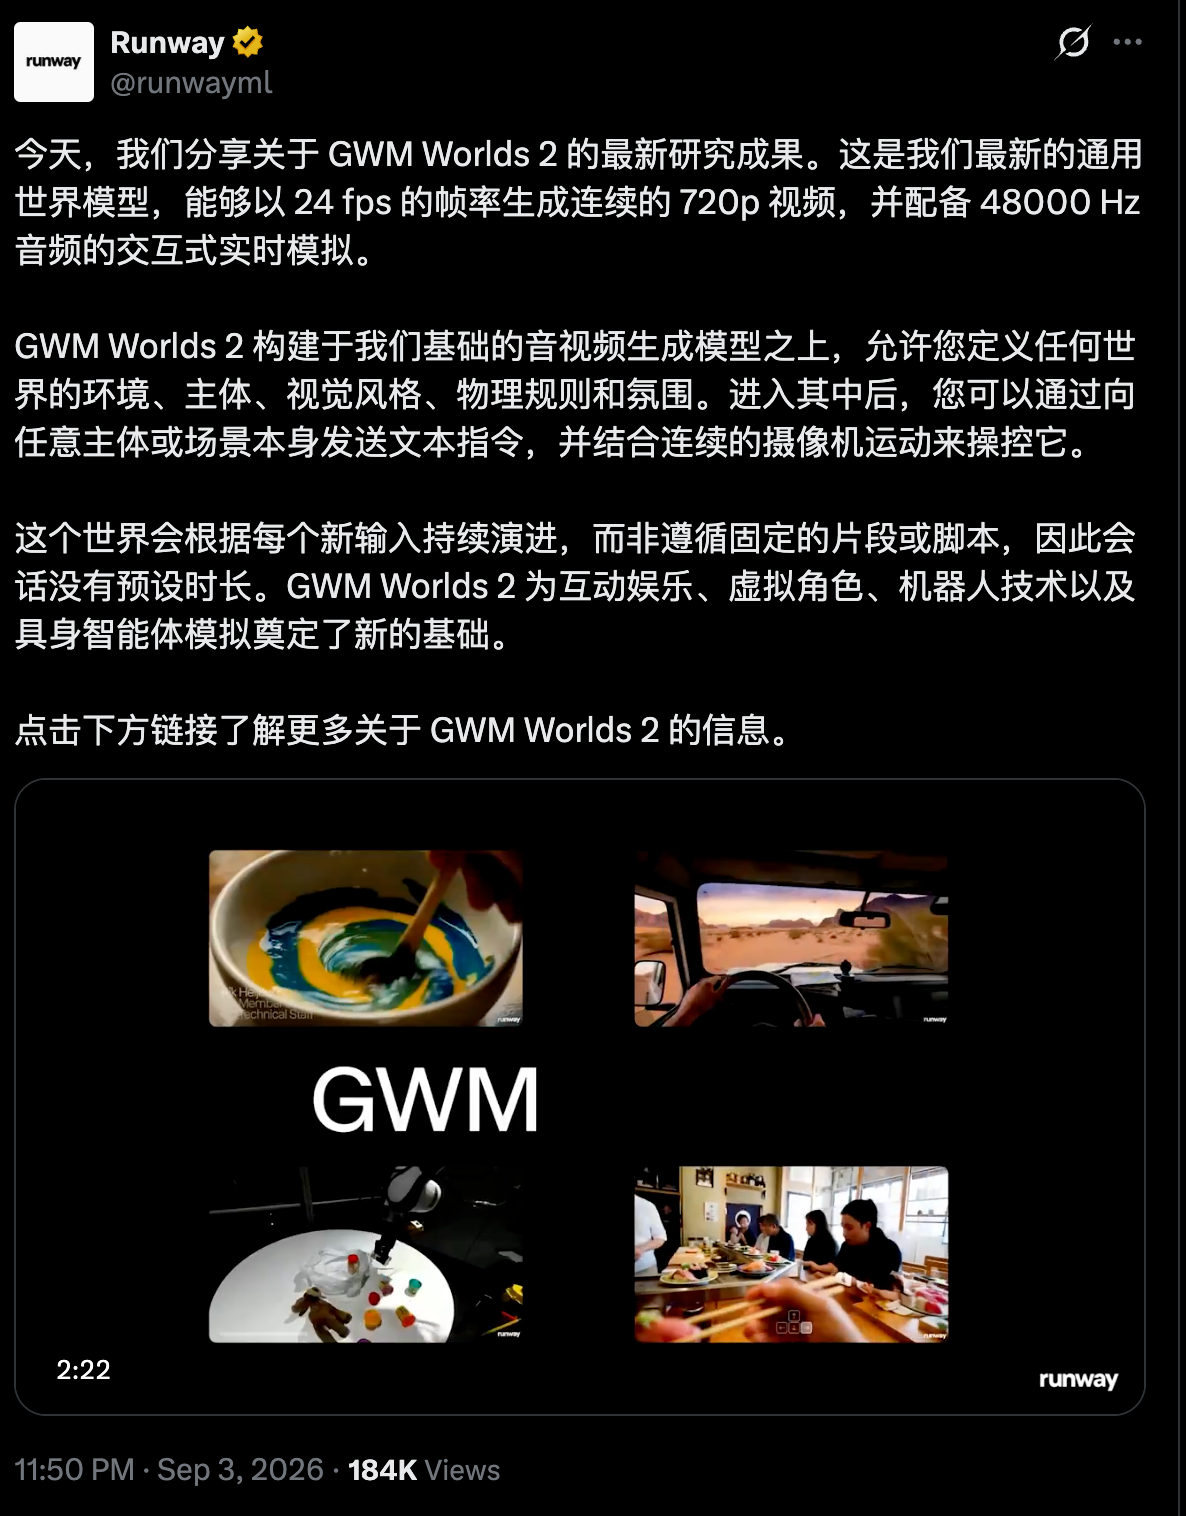
9月4日消息,AI 视频生成公司 Runway 发布通用世界模型的最新研究预览 GWM Worlds 2。该模型实时生成连续的 720p、24fps 视频与 48kHz 音频。用户可以用自由文本指令驱动画面中的任意主体或场景本身,同时配合连续的摄像机运动,世界随输入持续演进,没有预设片长。这是 Runway 在世界模型上的第二个公开节点:去年12月的第一代只能漫游静态场景,这一代把动作和声音加了进来。它目前仍是研究预览,没有公开定价,也未向普通用户开放。
比一代多了什么:音频,以及可以操控的主体和场景
Runway 在 2025年12月首次展示 GWM Worlds,当时的重点是维持长序列运动中的空间一致性,用户基本只能在一个生成的场景里移动视角。据 TechCrunch 当时报道,GWM-1 系列还包含 Worlds、Robotics、Avatars 三个变体,公司计划最终将其合并为单一模型。
GWM Worlds 2 在这个底子上往前走了一步,加入生成音频,对话、环境声与画面同步输出。变化更大的部分在控制对象上:文本指令不再只移动摄像机,而是可以指向世界内部。它可以指向某个具名角色,比如让沙漠中的幸存者刺出长矛;也可以指向场景本身,比如让沙尘暴滚入、让篝火燃起。两种指令还能同时进行,一人扮演角色,一人当导演。
技术上,GWM Worlds 2 是自回归扩散模型。Runway 先将一个双向的基础音视频模型微调,再后训练为实时自回归版本,配合滑动窗口缓存逐帧生成,因此不受固定时长限制。这套架构描述出自官方发布页,目前还没有第三方复现。
WorldPrompt:把动作变成可编排的输入
这次发布的技术核心是一套名为 WorldPrompt 的控制格式。它把一个世界拆成持久部分和变化部分:持久部分是创世提示词与首帧,规定环境构造、参与主体和物理规则;变化部分是带时间戳的事件流,每个动作是一段自由文本,标注起止时间、指向某个主体或场景,多个动作可以重叠,语音也被视为一种携带台词的动作。
基于这套格式,Runway 给出同一模型的三种用法。预写模式下用户一次性写好全部事件流,模型据此渲染整段内容,面向影视与广告。回合制模式在决策点暂停,等待用户选择下一步,面向视觉小说与互动电影。实时模式下模型持续生成,动作即时生效,面向游戏与互动体验。官方明确表示实时模式最难:文本输入需要在毫秒级延迟内送达。实际演示的做法是把 W 键绑定为"角色向前走"这类预置提示词,用键鼠触发。
Runway 还演示了两类延伸用法:让 agent 同时操控角色与环境,其中一个测试里人形机器人按指令走到指定旗帜,首次尝试即成功;以及多人模式,不同用户分别控制不同主体。这些均为官方演示口径。
和 Genie 3、Marble 不是同一种东西
世界模型这条赛道上,几个主要玩家的产品形态并不相同。Google DeepMind 2025年8月发布的 Genie 3 与 GWM Worlds 2 同属实时交互路线,按谷歌官方口径可实时导航 720p、24fps 的世界,一致性维持数分钟。李飞飞创立的 World Labs 走了另一条路。据 TechCrunch 报道,其 2025年11月发布的首个商业产品 Marble 从文本、图像、视频或粗略的三维结构生成可编辑、可导出的三维环境,产出是资产而非实时视频流。
Runway 自己则强调通用性。据 TechCrunch 报道,公司 CTO Anastasis Germanidis 当时表示,构建世界模型的正确路径是教模型直接预测像素。他还称 GWM-1 比 Genie 3 更"通用"。这属于厂商口径,目前没有公开 benchmark 支撑。
能用到什么程度,边界在哪
目前 GWM Worlds 2 没有公开定价,也不支持自助注册使用,发布页只提供面向企业的联系表单。Marble 去年11月发布时即开放免费与付费档位,Runway 这次则把新模型留在了研究预览阶段。
官方在发布页列出的局限相当具体:快速旋转镜头会导致细节、纹理和几何退化;长期记忆不完美;首帧或预填视频之外不支持图像参考;要充分发挥自由文本控制,还需要外部的实时状态跟踪程序。Runway 同时承认实时模式的画质低于预写模式,因为后者可以在提示词里预先描述更多场景细节。
把这些自述局限放在一起看,分辨率和帧率已经不是问题,720p 和 24fps 都给到了,没解决的是一致性、长期记忆和输入延迟。对游戏和互动娱乐开发者来说,GWM Worlds 2 展示了一种可交互内容底座的可能形态,但按键绑定预置提示词的演示方式说明,它离真正的自由输入还有距离。机器人和具身智能研究者则多出一个不需要真实硬件的仿真环境选项,agent 控制的演示目前也只是起点。至于这种形态能否走向商用产品,目前证据不足,Runway 自己的说法是这仍处在研究曲线的早期。
 AI 速览