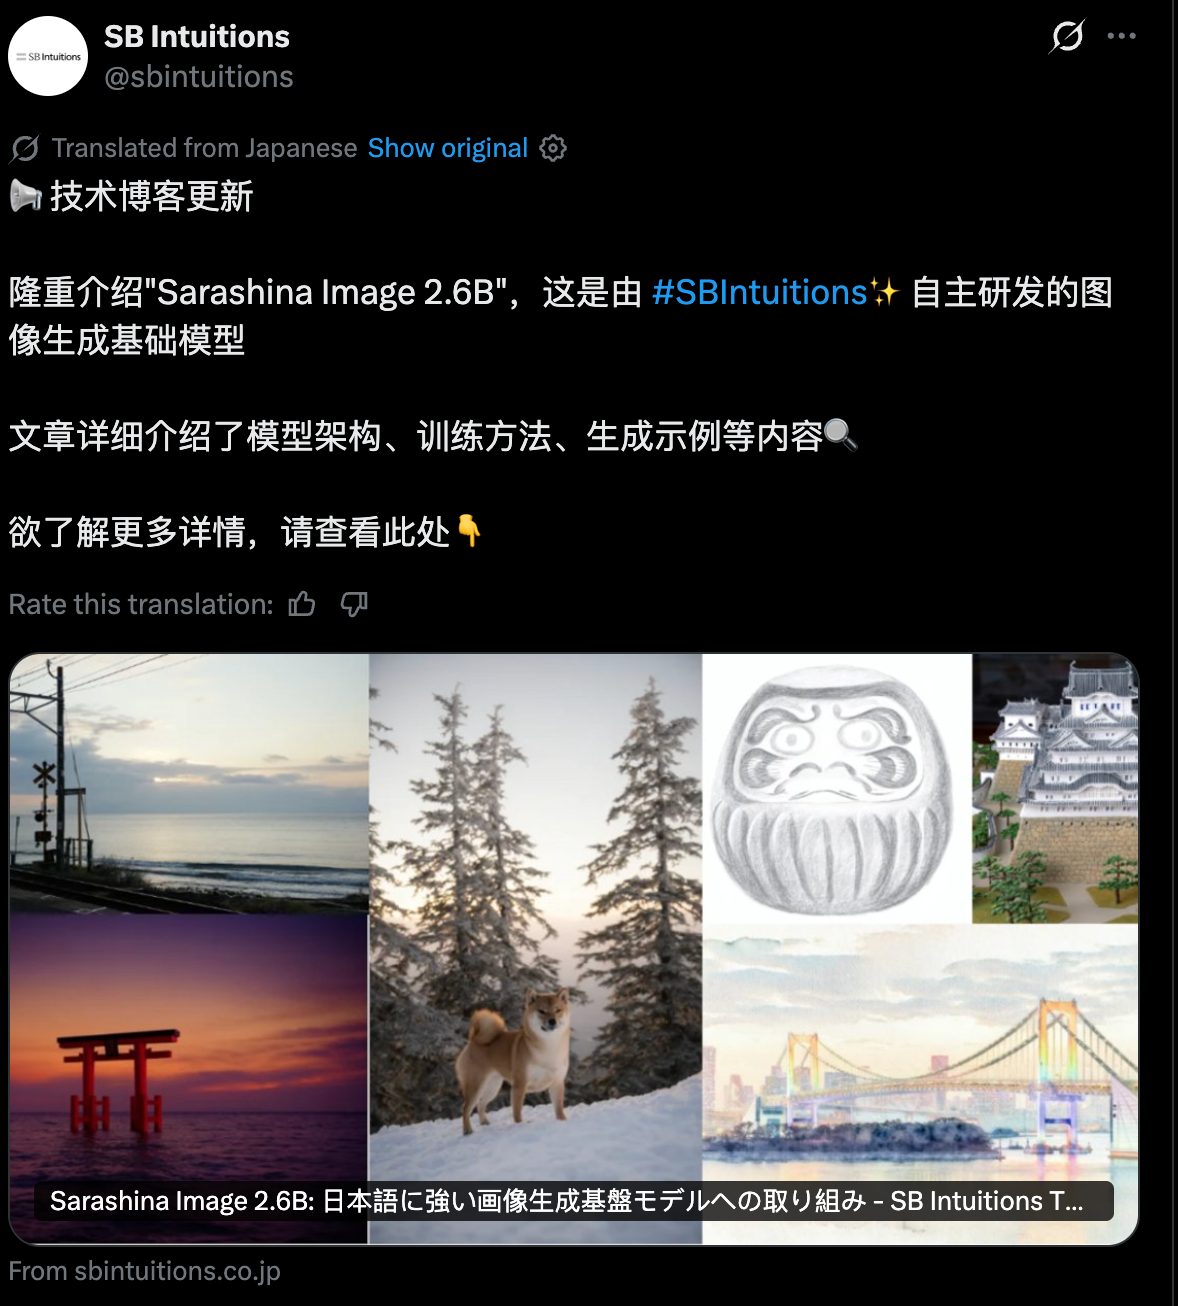
9月4日消息,软银集团旗下的日本基础模型开发商 SB Intuitions 发布公司首个图像生成基础模型 Sarashina Image 2.6B,技术博客同步公开了架构与训练细节。模型以 2.6B 参数的 Diffusion Transformer 为核心、从零训练,公司在自测基准上公布的成绩超过 SDXL、FLUX.1-dev 与 Stable Diffusion 3.5 Large 8B。权重开放状态与许可证目前均未披露,自测成绩暂无第三方复现。
从零训练的 2.6B DiT
Sarashina Image 2.6B 走流匹配(Flow Matching)潜在扩散路线,核心是 26 亿参数的 Diffusion Transformer(DiT),未基于任何已有图像生成模型的权重。架构采用 Lumina-Image 2.0 提出的 Unified Next-DiT:文本 token 与图像潜在 token 拼成单一序列,在同一个 Transformer 内统一处理。
模型分三段:文本编码器用的是自家视觉语言模型 Sarashina2.2-Vision-3B,中间是 DiT,末端由 VAE Decoder 还原出百万像素级的高分辨率图像。多轴位置编码让模型可以处理不同长度的 prompt 与多种分辨率、宽高比。
自购图库训练,主打日语理解
训练数据以公司自购的大规模库存图库照片为核心,辅以遵守许可条款的开源数据集,数据规模未披露。caption 覆盖日英双语,文本编码器针对日语的复杂语义结构做了适配:主语省略、长定语修饰、灵活语序,这些是让直译式图像模型出错的典型场景。官方博客的生成示例也选了日本文化题材:雪地里的柴犬、达摩、日本城堡、水中的鸟居。
训练分两段:先从 256×256 到 1024×1024 渐进式预训练,再用 Flow-GRPO(把 GRPO 应用到流匹配)配合奖励模型做偏好优化,官方称主要提升 prompt 追随性与画面质量。
自测成绩领先,短板自己列了
公司在两个基准上公布了对比成绩。OneIG-Bench 上,英语与日语 prompt 均录得总分 0.497,高于 SDXL、FLUX.1-dev 与 Stable Diffusion 3.5 Large 8B;UniGenBench English Long 上 Overall Score 为 80.42,排在 FLUX.1-dev 与 SD3.5 Large 8B 之前。日英同分被归因于双语 caption 训练与 Sarashina2.2-Vision-3B 文本编码器。
这些成绩全部是公司自测:每个 prompt 生成 4 张、统一流程,官方自己声明不构成严格排名,目前也没有第三方复现。博客同时列出剩余短板:属性错配、多目标排布、数量指定、左右前后的空间关系。
软银系玩家的日语图像生成第一步
SB Intuitions 此前的 Sarashina 系列覆盖日语 LLM、视觉语言模型、OCR 与文本嵌入,均在 Hugging Face 开放。图像生成是这家公司的第一条新产品线,官方将其定位为"日语强生成 AI"战略的一环,目标面向 B2B API 服务,把图像生成、编辑与设计支援打包提供。一个开发中的指令式图像编辑模型已在博客中预告:支持单张或多张参照图,基于同一 DiT 架构,能做风格转换、姿势变更与季节天气调整。
开放状态还没有答案。博客没有提及权重开放与许可证,截至9月4日,Hugging Face 上找不到这个模型,与此前的系列惯例不同。若后续开放,2.6B 的参数规模意味着企业在自有环境部署的成本可控;若不开放,日语差异化和自测成绩都只能停留在公司口径,这条产品线的竞争力要等更多外部证据。
 AI 速览