DeepSeek V4-Pro是多模态吗?DeepSeek V4-Pro不是多模态模型,它是纯文本大模型。官方文档里能查到的模型细节说得很清楚,目前DeepSeek有三个独立的模型:deepseek-v4-flash、deepseek-v4-pro和deepseek-v4-flash-vision-exp,视觉能力只存在于最后这个单独的实验性模型里,不是V4-Pro自带的功能,想用图像理解能力,得专门调用带Vision标识的这个模型。 一、DeepSeek V4三个模型是分开的,别混为一谈
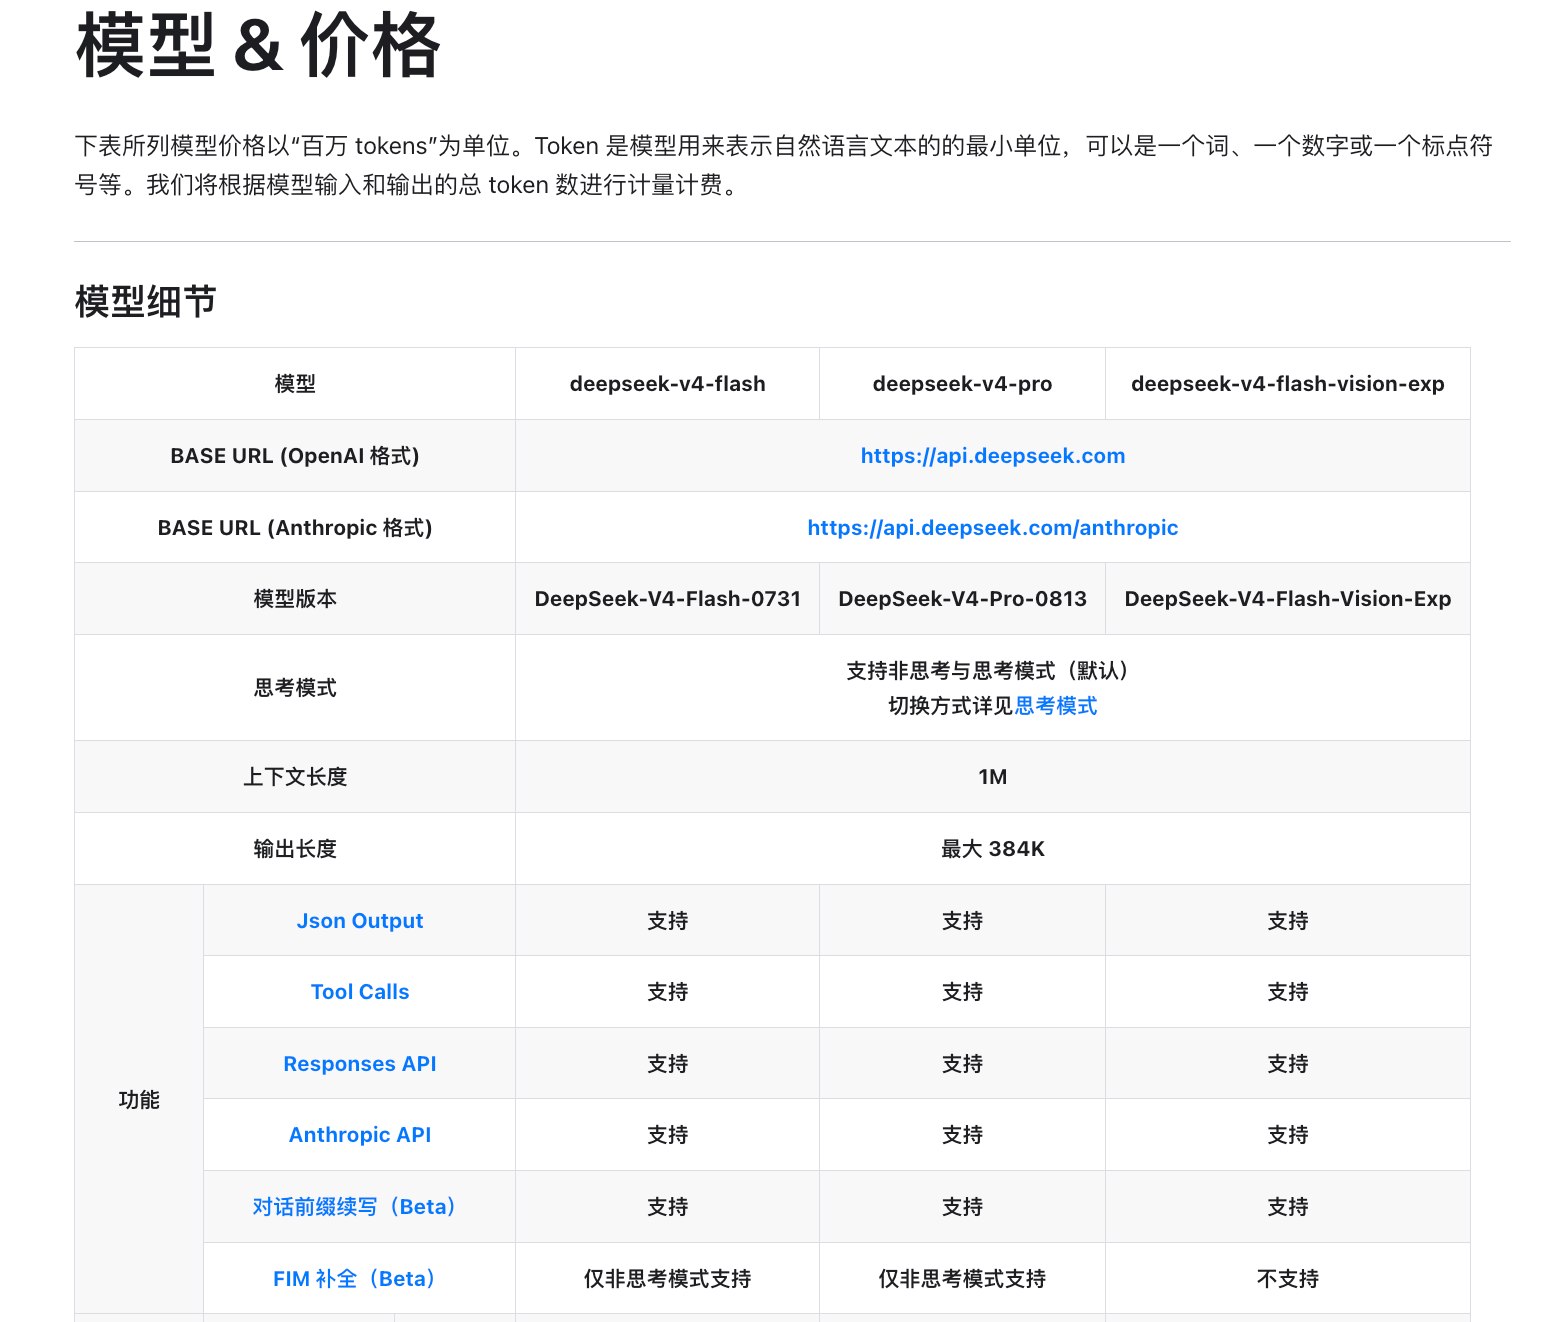
按照官方API文档给出的信息,这三个模型对应的具体版本分别是:
deepseek-v4-flash对应DeepSeek-V4-Flash-0731
deepseek-v4-pro对应DeepSeek-V4-Pro-0813
deepseek-v4-flash-vision-exp对应DeepSeek-V4-Flash-Vision-Exp
看命名就能看出来,Vision能力是单独拎出来做的一个实验性版本,模型名称里也带了"Vision"这个标识,不是挂在V4-Pro或者V4-Flash主线模型底下的一个功能开关。如果你直接调用deepseek-v4-pro这个模型标识,处理的就是纯文本任务,不支持图像输入。
二、DeepSeek V4三个模型的基础规格是一致的
有意思的是,抛开视觉能力这一项,这三个模型在基础规格上差别不大:
上下文长度:三个模型统一都是1M(百万token级别)。
输出长度:最大都是384K token。
思考模式:三个模型都支持非思考与思考模式(默认非思考模式),可以按需切换。
接口兼容性:Json Output、Tool Calls、Responses API、Anthropic API这几项功能,三个模型全部支持。对话前缀续写(Beta)这个功能,三个模型也都支持。
差异主要出现在FIM补全(Beta)这一项上:deepseek-v4-flash和deepseek-v4-pro都是"仅非思考模式支持",而deepseek-v4-flash-vision-exp是"不支持",这个视觉实验模型在代码补全这类功能上做了取舍。
三、想用视觉能力,接口怎么调
需要提醒的是,这个模型名字里带着"Exp"(Experimental,实验性),说明它目前还处于实验阶段,稳定性和功能完整度可能不如V4-Pro、V4-Flash这两个正式版本,用在生产环境里得多留意,功能范围也和主线模型有些差异(比如前面提到的FIM补全就不支持),别默认它跟V4-Pro功能对等,只是多了个看图的能力。
四、为什么容易被误传成"V4-Pro支持多模态"
网上不少文章在报道DeepSeek视觉能力上线的时候,标题和表述容易简化,把"DeepSeek推出了一个带视觉能力的实验模型",写成"V4-Pro现在支持多模态了",中间省略了"实验性""独立模型""需要专门调用"这几个关键限定词。这种简化传播开之后,读者拿着这类二手信息去实际调用deepseek-v4-pro这个标准接口,会发现根本传不了图片,容易产生困惑。
判断一个模型是不是真的支持多模态,最准的办法还是直接查官方API文档里的模型细节表格,看清楚模型标识、版本号和功能支持列表,别只看资讯类文章的标题结论。
DeepSeek V4-Pro是多模态吗?答案很明确:不是,它是纯文本模型,视觉理解能力目前只存在于单独的deepseek-v4-flash-vision-exp这个实验性模型里。这三个模型虽然在上下文长度、输出长度这些基础规格上保持一致,但功能定位是分开的,用之前一定要确认清楚自己调用的模型标识对不对,别把V4-Pro和Vision-Exp的能力搞混了。
 AI 速览