OpenAI 突发上线 Image 2.5 图像生成模型,并未放在后续开发者大会发布。本次更新核心围绕生成速度、画面清晰度、多轮一致性、局部精修展开,同时新增画布涂鸦、设计模板等交互功能,同步推出不同定位的子版本,整体从 “写提示词生成” 转向更直觉的可视化交互。
一、产品矩阵:三档定位,核心能力全面升级
本次 Image 2.5 采用滚动上线策略,同时在 API 端推出三款定位不同的模型,形成完整梯度。
- 标准版 Image 2.5:平衡质量与速度,是日常创作的主力版本;
- GPT-Image-2.5 Flare(中杯):保持同等画质前提下,处理速度提升 50%,适合快速出图、批量生成场景;
- GPT-Image-2.5 Sunburst(超大杯):生成精度更高,细节更丰富,对应生成时间更长,适合高要求终稿输出。
核心能力层面,模型稳定性实现质变。同一场景 150 次生成中,物体形变、构图偏差极少,不再需要用户在提示词中强制加入固定视角、固定光照、结构约束等稳定性条件,多轮编辑也能保持人物、场景、风格的高度一致。
二、三大新功能:从写提示词转向可视化交互
本次更新最大的变化不在生成质量本身,而在交互方式,多个原本需要写进提示词的要求,变成了直观操作。
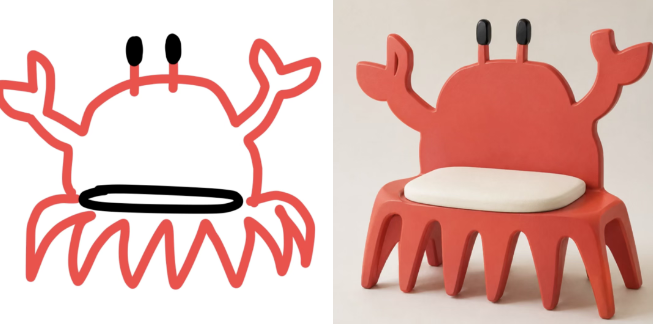
画布涂鸦功能:支持像蜡笔一样在画布上手绘线条、图形、文字,AI 参考手绘内容与已有画面生成图像,手绘文字更多作为补充说明而非直接保留。该功能仅在网页版 ChatGPT 可用,Codex 端暂不支持。
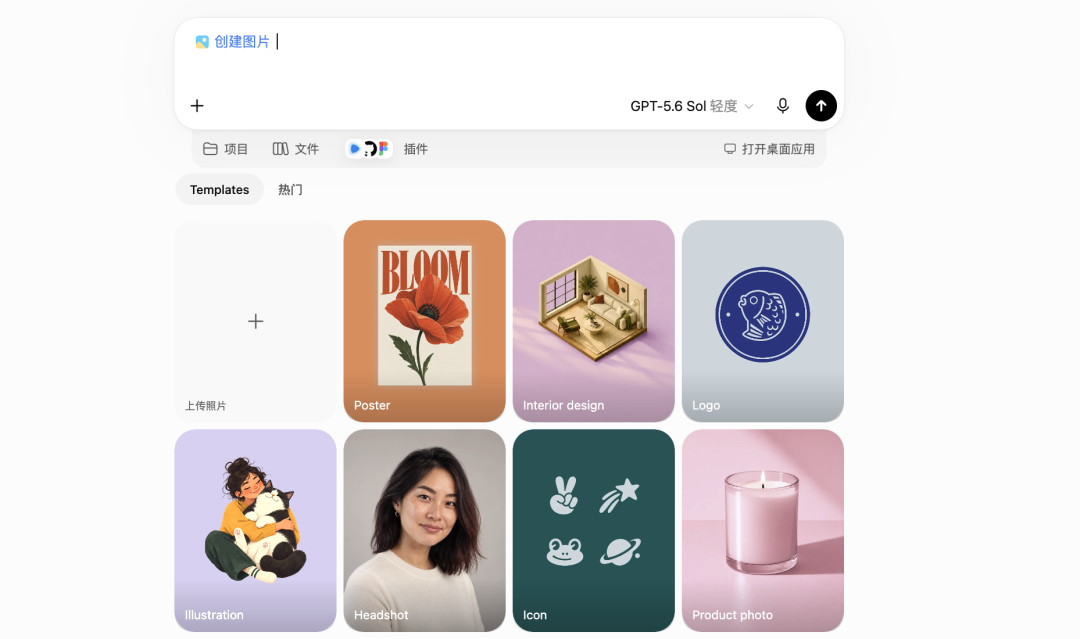
设计模板功能:内置 15 类预设模板,覆盖海报、Logo、插画、头像、产品图、信息图、书籍封面、视频封面等主流设计场景。选择模板后会自动匹配对应提示词与配置流程,无需从零构建描述。入口在对话框左下角 “创建图片”,直接在对话框输入需求无法触发模板。
局部标注精修:直接在图片上圈选、点选不满意的区域,即可精准修改对应位置,无需用文字反复描述位置与特征。实测人物面部点痣、局部细节调整均可一次成功,大幅降低精修的沟通成本。 此外模型支持精确控制画面比例,可稳定输出 1:1、3:4、9:16、16:9、21:9 等多种尺寸封面。
三、版本识别与使用避坑指南
滚动上线阶段,用户可通过一个简单方法快速判断当前使用的版本:Image 2.0 无法生成原生透明背景,而 Image 2.5 支持直接输出透明 PNG。通过指令 “生成一张白色杯子、纯透明背景的图片,确认是否原生透明”,即可快速验证版本。
使用中存在两个关键避坑点:
第一,新绘图、模板功能仅支持网页版 ChatGPT,Codex 端调用 imagen Skill 无法触发画板与模板,反复重启、更新也不会生效,复杂精修建议优先使用网页端。
第二,定格动画可通过 12 帧 / 秒的方案生成,但本质为逐帧生成拼接,适合测试模型一致性,复杂长动画仍需专业工具。
四、实测对比与行业趋势
多场景横向对比 Image 2.0 与竞品,呈现出清晰的优劣势。 Logo、人物、建筑类场景,Image 2.5 在清晰度、细节还原、文字辨识度上明显领先,对比 Grok 同类生成的文字模糊问题优势显著;但风格迁移场景,Image 2.5 风格偏柔和,辨识度反而不如 Image 2.0。 多轮编辑一致性是本次最大进步。此前 Image 2.0 通常修改 5 轮左右就会出现风格、人物漂移,需要重新生成;Image 2.5 可支持更多轮修改,始终保持主体一致。
整体来看,Image 2.5 的核心变化,是把原本需要写进提示词的约束、结构、风格要求,逐步转化为涂鸦、模板、点选等直观操作。精准复杂的提示词在专业场景依然不可替代,但对普通用户而言,好的提示词不再是用好 AI 生图的必要前提,生图的门槛正在持续降低。
 AI 速览