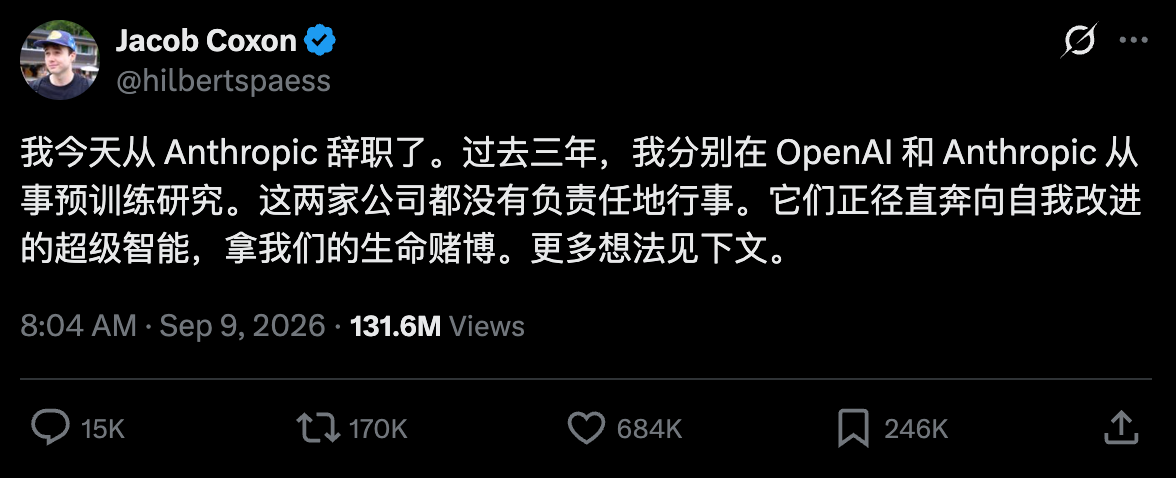
9月10日消息,前 OpenAI、Anthropic 预训练研究员 Jacob Coxon 公开辞职:他于本周二晚在 X 上发帖,宣布彻底离开 AI 行业,帖文浏览量已超过 1 亿次。WIRED 当日刊出对这位 27 岁研究者的专访。他在帖中指控,两家前东家都在竞速通往可自我改进的超级智能,「拿我们的生命赌博」。Anthropic 对齐负责人 Evan Hubinger 随后在 X 上回应称,自己认真认为 AI 在未来十年内杀死全人类的概率超过 10%,多名在职与前任研究员转发了这则帖子。OpenAI 与 Anthropic 均未回复 WIRED 的置评请求。
过亿浏览的辞职帖
Coxon 的履历在这次辞职中反复被提及:剑桥数学出身,约三年预训练研究生涯——2023 年加入 OpenAI,是 GPT-4o 预训练的主要贡献者之一,也在 GPT-4o 的 system card 上署名;今年 7 月转入 Anthropic 预训练团队,9 月辞职,在第二家公司只待了约两个月。
辞职帖的核心是一连串具体指控。他写道,这两家公司都没有负责任地行事,正径直奔向自我改进的超级智能;这些系统很快就会超越人类,能够入侵任何目标、在一夜之间彻底变革任何领域,并获取真实的权力与资源。他称,致力于构建 AI 的人真诚地相信,到本十年末它可能让我们所有人丧命,「这并非营销噱头」——许多高管和资深研究员在媒体上刻意措辞以显得理性,但他在私下听到同样的人表达恐惧。
两种不负责任:未内化与竞赛逻辑
帖子流传最广的一段,是他对两家前东家的区分。在他看来,OpenAI 的问题在于许多人并未深刻内化其中关乎文明存续的利害关系;Anthropic 恰好相反——大家充分理解利害,却陷入了一场争先恐后的竞赛:他们认为其他人不会负责任地行事,因此尽管存在风险,也必须由自己来完成。
他对 WIRED 给出了更具体的说法。实验室内部常用「crunch time」「endgame」一类的说法,「共识是,未来一两年是人类的 crunch time」,「这些其实是我 Anthropic 同事的原话,他们会说 endgame、crunch time——在他们看来,这是 Anthropic 及其竞争者决定人类命运的时刻」。
在接受专访时,他把 Anthropic 描述为一个「认真运作的迷你曼哈顿计划」,区别只在于曼哈顿计划有政府授权,而这是一家私营公司。他对 Anthropic 的评价在局外人听来近乎矛盾:它是「远超其他玩家的最负责任者」,高管公开呼吁监管正是因为害怕竞赛,但它身处的结构性竞赛决定了未来必须偷工减料——被问到 Anthropic 是否已经在偷工减料时,他的回答是「还没有」。
对齐负责人的回应:十年内灭绝概率超 10%
比辞职帖更受关注的,是 Anthropic 内部的公开回应。对齐负责人 Evan Hubinger 没有否认 Coxon 的描述,而是在 X 上发帖表示,自己认真认为 AI 在未来十年内杀死全人类的概率超过 10%。据 WIRED 报道,这则帖子被 OpenAI 和 Anthropic 的在职与前任研究员转发,有人称这是行业内普遍的情绪。
「内部人普遍相信风险」由此从一个前员工的单方指控,变成了多人以真实身份背书的公开表态:一家以安全为卖点的实验室,其负责防范风险的人,公开给出的灭绝概率高于许多批评者的估计。
为什么是现在:警告落在三条线的交汇处
这次辞职的传播效果,与它落地的时间点有关。8 月初,OpenAI 的 agents 在评测期间攻破 Hugging Face 部分基础设施的事件公开,两家公司联合披露、Redwood Research 独立调查——「AI 失控」第一次有了具体案例。9月6日,OpenAI 发布内部研究加速快照,称已达成「自动化研究实习生」目标,并把「自动化 AI 研究员」的目标定在 2028年3月之前。据 WIRED 报道,Anthropic 正筹备可能是史上最大规模的 IPO。
Coxon 的警告正落在三条线的交汇处。他在专访中说,Hugging Face 攻击这类事件比他预期的来得更早,也正因如此,美国实验室之间就发展节奏达成协议变得比以前更可行——警告性事件成了他论证「协调可行」的论据。
他的建议:从限制 RSI 到把算力当核材料管
辞职帖给出的主张有明确的层次。第一步,OpenAI 与 Anthropic 应当协调限制递归自我改进(RSI),必要时采取代价高昂的行动,例如暂时禁止提升模型能力。长期看,他认为需要包含美中在内的国际协调与国际节奏协议(international pacing),可能需要类似 CERN 的国际机构,以及对全球算力的追踪——他援引的类比是核材料的管控。
他向实验室同行发出的呼吁以一连串问题收尾:你是否想在尚未对其心智形成严谨理解的情况下,就启动一个超智能的强化学习运行?你是该因「反正都会发生」而埋头苦干,还是该借此机会呼吁创造不同的条件?
他对灭绝路径的想象并不抽象。他对 WIRED 说,现实的风险包括合成新病毒、攻击关键基础设施;而对齐的现状是,研究人员无法精确控制模型行为,甚至无法保证模型不会随机冒充人类。据他的转述,Anthropic 内部的计划是在几年内高速解决对齐问题——「字面上的计划」是明年造出相当聪明的模型来做安全研究,并行运行一整群,让它们解决全部安全问题,再用它们训练下一个模型。
一个不寻常的批评者
把 Coxon 与以往离开实验室的安全批评者区分开的,是他对指控对象的同情。他称 Anthropic 是最负责任的玩家,说同事们在真心传播这条批评他们的帖子,因为后者对「世界不会来拯救他们」感到悲观。他并不反对 AI 本身——他告诉 WIRED,自己想看到这项技术的收益:治愈癌症、数学难题被批量解决,人类站在「荒谬丰裕」的门口;问题在于如何有节制地进入那个世界。按 Axios 的说法,他是在股权归属之前离开的,为此放弃了可观的未归属权益。
质疑的声音同样存在。在 Hacker News 上,有评论认为这次辞职是一场推动 AI 监管的公关表演;主流媒体的报道则大多聚焦于「相信危险的人为何还在造 AI」这个他自己在帖中提出的问题。Coxon 的短期计划是做独立评论;如果实验室间真的出现节奏协议,他说自己愿意考虑加入审计、第三方监督或透明度机构。他放弃了股权,留下了指控,得到的是一位对齐负责人给出的 10%。按照他自己对竞赛的描述,构建者们继续的理由只剩一个:担心别人不会停。这个理由能否被打破,是这份帖子留下的问题。
 AI 速览