9月15日消息,上海人工智能实验室发布并开源新一代智能体模型 Atria Dawn 预览版,定位长周期任务:研究人员和工程师把开放性问题交给它,由模型拆解目标、调用工具、执行多步任务并产出可验证的结果。模型基于 744B 参数的 MoE 架构 GLM-5.2 底座训练,上下文长度 256K,权重以 MIT 许可证在 Hugging Face 与 ModelScope 开放下载。官方公布的评测表显示,它在检索、工具调用与网络安全类基准上领先 DeepSeek V4 Pro、Kimi K3、Claude Opus 5 等旗舰模型,但在编码与通用办公交付任务上仍落后于 Claude Opus 5。 据报道,这项工作由上海人工智能实验室联合复旦大学、中国科学院软件研究所、中国人民大学、中国科学院自动化研究所、华东师范大学和哈尔滨工业大学共同完成。模型权重于9月13日上线 Hugging Face。Atria 这个名字取自南三角座最亮星,官方的中文名称沿用「Atria Dawn 预览版」。
744B 参数、MIT 许可,部署路径全部公开
Atria Dawn 预览版不是聊天模型。官方模型卡把它定位为面向长周期任务的新一代智能体模型,能力围绕四类场景组织:Discovery,检索并组织证据、把开放性研究问题转成可执行的实验计划;Creation,完成软件开发、交互应用、数据可视化与机器学习系统;Delivery,把文档、数据和设计需求交付成报告、演示文稿等结构化产物;Cybersecurity,在授权环境下分析安全问题、验证漏洞、应用修复并复验。
规格方面,模型总参数 744B,采用 MoE 架构,基座为 GLM-5.2,上下文 256K。模型卡标注它只接受文本输入,不支持图像等多模态内容;官方给出的 Claude Code 接入方案里,需要通过 hook 拦截多模态请求再转发。开源包含 BF16 全精度与 FP8 量化两套权重,本地部署支持 SGLang(v0.5.13.post1 及以上)与 vLLM(v0.23.0 及以上)。不自行架设集群的,可以通过官方 API(api.atria-asi.ai)或中文入口(discovery.intern-ai.org.cn)在线调用。 对国内开发者和企业,这组开源细节把获取门槛压低:MIT 许可证允许商用和二次改造,FP8 量化版降低显存开销,配合主流推理框架可以在自有算力上部署,数据不出域。
官方评测:检索、工具与安全领先,编码与办公落后
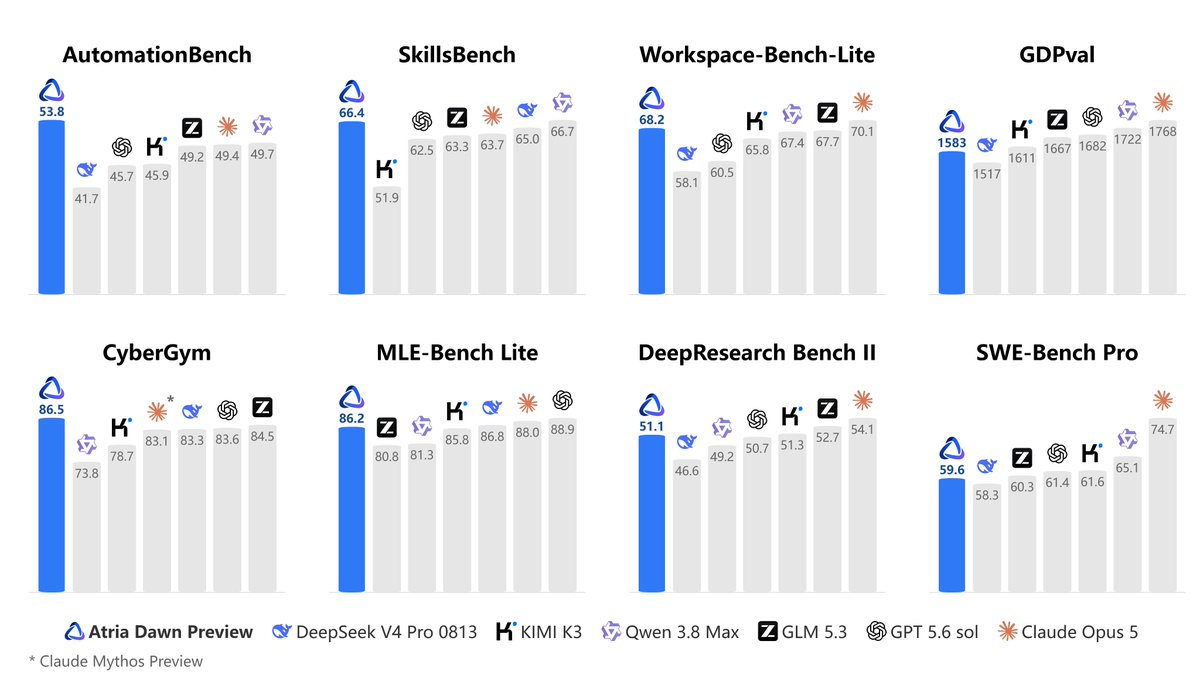
官方在模型卡中公布了与 DeepSeek V4 Pro 0813、Kimi K3、Qwen 3.8 Max、GLM 5.3、GPT 5.6 sol 和 Claude Opus 5 的对比评测。领先项集中在信息检索与智能体工具使用:DeepSearchQA 96.0,BrowseComp 92.5,BFCL v4 77.0,AutomationBench 53.8,CyberGym 86.5,SkillsBench 66.4,这几项在对比表中排第一。 落后项写在同一张表里。SWE-bench Pro 得分 59.6,低于 Claude Opus 5 的 74.7;Terminal-Bench 2.1 为 78.3,Claude Opus 5 达到 90.2;GDPval 得分 1583,Claude 为 1768;JobBench 50.3,低于 Claude Opus 5 的 68.0。DeepResearch Bench II 51.1,低于 Claude Opus 5 的 54.1。
这份评测是厂商自报口径,目前没有独立的第三方复测数据。
官方演示:1 分钟全球天气预测,20 分钟构建 MiniOS
官方技术报告给了三个演示。第一个面向科研:禁用联网搜索,只给模型 100GB 以上的全球气象数据,模型设计并训练了一个超过 4 亿参数的视觉骨干网络,完成 4.5 万步训练、学习 69 个气象变量后,1 分钟内给出未来一周的全球天气预测;官方称在该案例的评测设置下,部分预测指标优于英伟达 FourCastNet。第二个面向工程:从一段自然语言需求出发,20 分钟构建出可运行的 MiniOS 操作系统。第三个是安全:在隔离靶场里完成从漏洞发现、利用验证到修复与复验的完整流程。
官方报告还附了一组人机协作研究数据:在 769 条任务记录、56 名参与者的使用中,96.5% 的任务选择使用该模型;33.2% 的已完成任务被认为没有 AI 难以完成;64.6% 的方案由 AI 提出,但 85.5% 的最终选择由人作出;76.0% 的困难任务在人类介入后继续推进。这组数据出自同一份报告,样本为报告包含的研究。
官方自己划出的能力边界
把这张评测表放回当下「开源追平闭源」的常见叙事里,信息量集中在落后项。官方把编码(SWE-bench Pro、Terminal-Bench)与通用办公交付(GDPval、JobBench)上和 Claude Opus 5 的差距列在同一张表里。对选型的人,这张表本身就是使用说明:它适合研究与工程中步骤多、耗时长、依赖工具调用的任务,不适合当作全能旗舰的平替。
纯文本输入的取舍与这一定位一致。四类能力场景——检索证据、设计实验、写代码、交付报告——都以文本和工具循环为主,模型卡也没有把多模态列入规划;图像理解类任务仍需交给别的模型。
底座选择也写在明面上:官方写明它基于 GLM-5.2 底座训练。744B 参数的底座加上 MIT 许可,国内机构拿到的是一个可以自部署、可改造的完整起点,而不是只能调用 API 的黑盒。至于这批评测数字在独立复测下能保留多少,目前没有答案。
新一条线:研究、编码、检索
上海人工智能实验室过去一年的公开路线是「科学智能」:Intern-S1 与 Intern-S1-Pro 面向科学多模态,Intern-Discovery 平台承载跨学科、长周期的科学发现任务,Intern·Agent 框架覆盖化学、物理、生物等 12 类科研任务。Atria 把同样的长周期思路从科学场景推广到通用的研究与工程任务,检索、实验、编码、交付、漏洞验证被收进同一个模型的能力范围。
 AI 速览