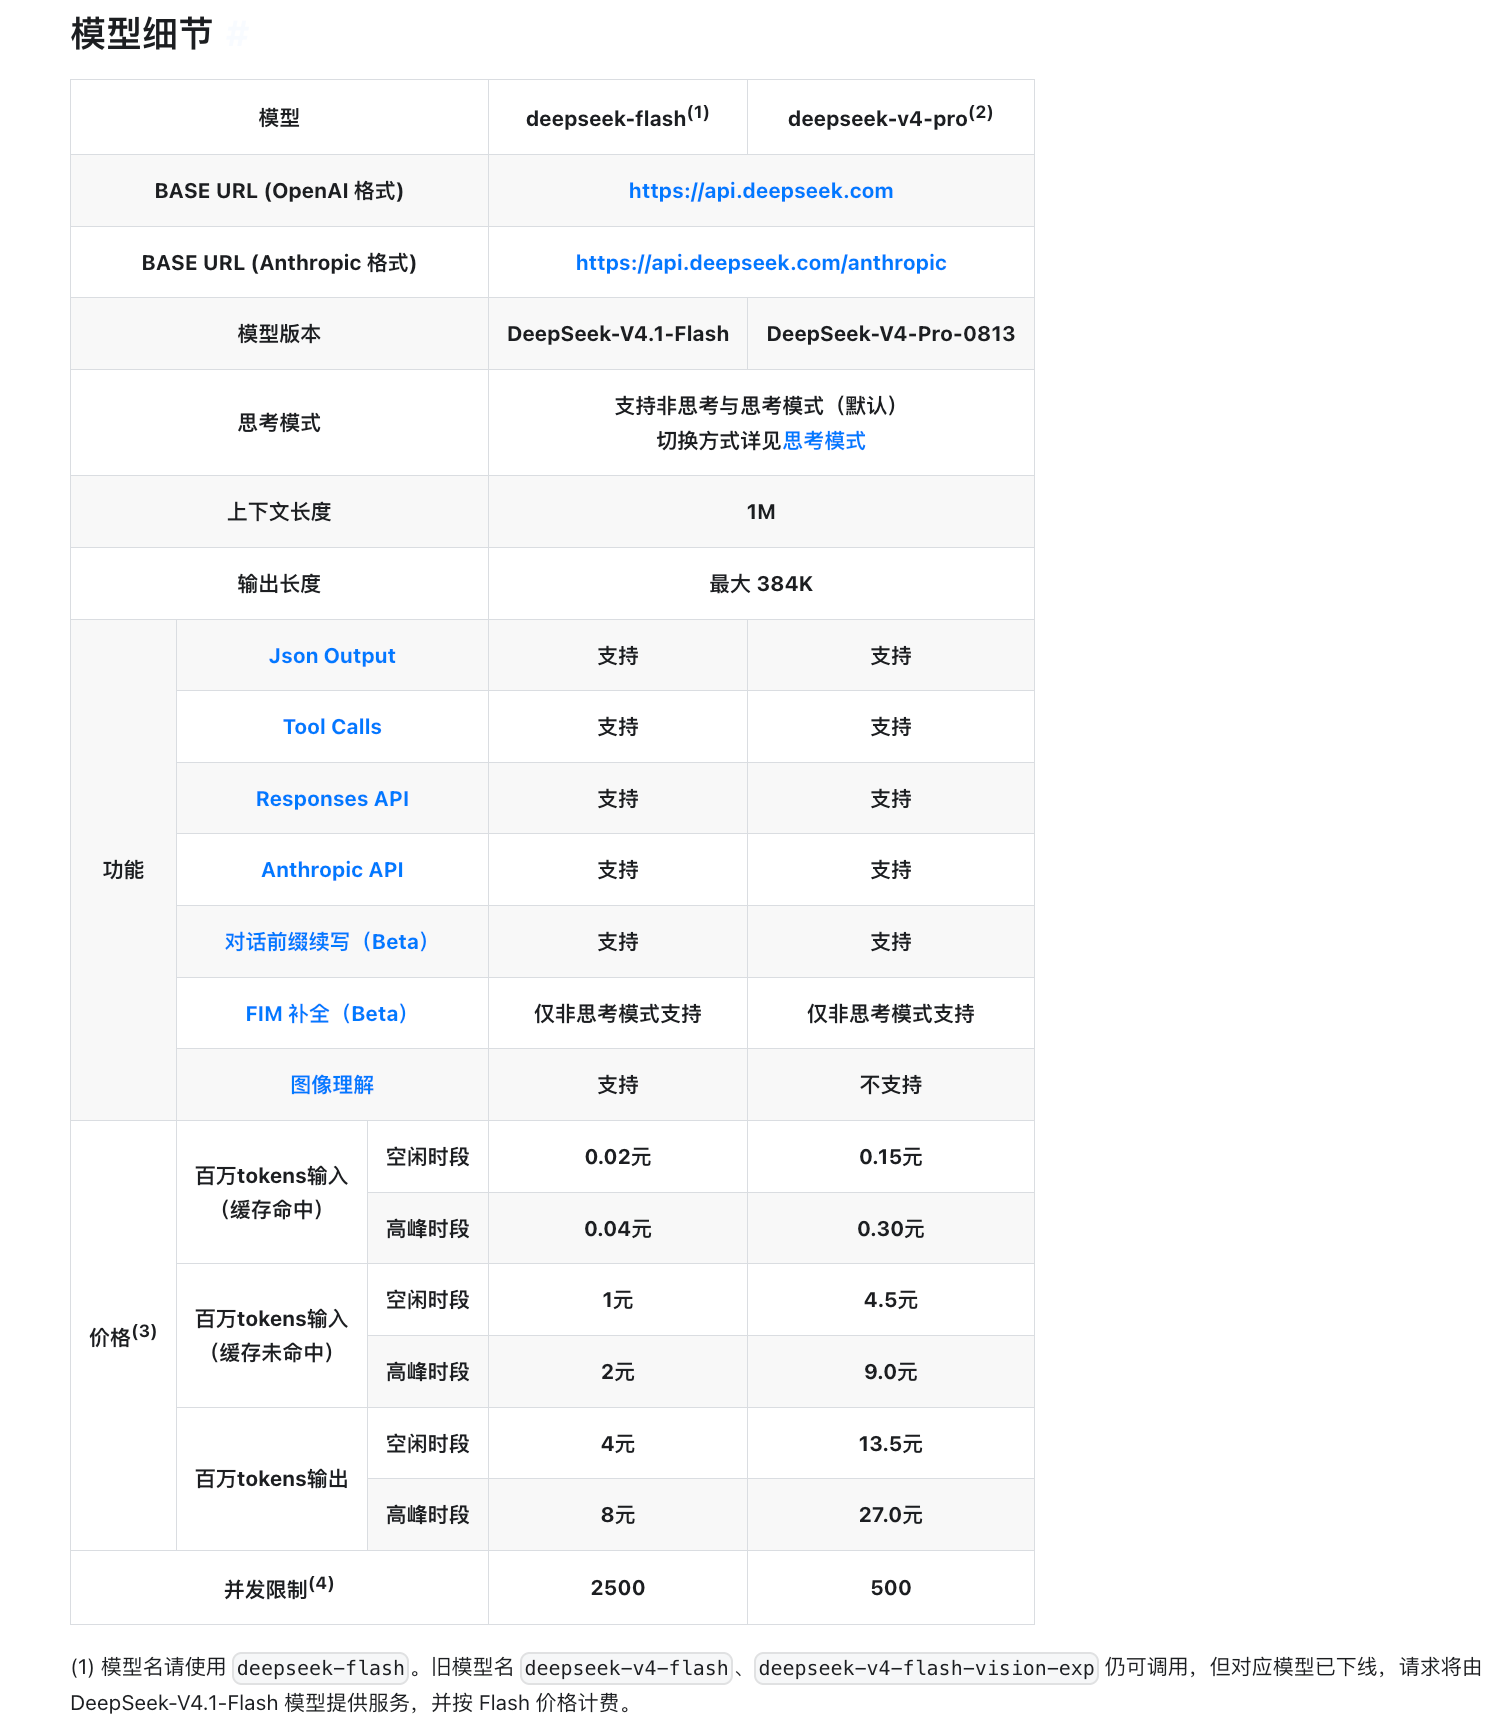
DeepSeek V4.1与V4 Pro区别,本质是两代模型结构的差距,而不是同一代里的两个档位:V4.1 系列目前只发布了最小尺寸的 V4.1 Flash(API 模型名 deepseek-flash),而 V4 Pro 是上一代结构的旗舰正式版(模型名 deepseek-v4-pro,权重快照 0813)。两者在官方定价页上共有 10 项规格可逐行对照,其中只有「图像理解」一项功能不同——Flash 支持、V4 Pro 不支持;价格上 V4 Pro 是 Flash 的 3.375~7.5 倍,并发上限只有五分之一。官方曾宣布 9 月 14 日把 v4-pro 请求全部路由到 Flash,随后又改口继续提供。本文细细解答一番。 DeepSeek V4.1与V4 Pro区别是什么
先把最容易含混的一层说清:「V4.1」和「V4」是两个结构系列,不是同一个系列的快慢两档。DeepSeek 在 2026 年 9 月 10 日的发布公告里写明,V4.1 Flash 是「全新模型结构系列中的最小尺寸的模型」,并在同一份公告里把 V4 Pro 称为需要被超越的「旗舰」——也就是说,这是一次「新一代的最小尺寸打上一代的最大尺寸」的对照。
两个模型的基本身份可以直接并排看:V4 Pro 属 V4 系列,2026 年 8 月 13 日正式版上线,权重快照为 DeepSeek-V4-Pro-0813;V4.1 Flash 属全新的 V4.1 系列,2026 年 9 月 10 日正式上线并同步开源,官方给出的开源链接是 Hugging Face 上的 deepseek-ai/DeepSeek-V4.1-Flash,配一份《DeepSeek_V41_Tech_Report》。截至 2026 年 9 月 15 日,V4.1 系列只发布了 Flash 这一款。
体量上的差别在官方模型卡里是明写的。V4.1-Flash 的模型卡开头写「a multimodal Mixture-of-Experts (MoE) model with 552B backbone parameters」,架构为 Causal Encoder-Decoder(CED):40 层 Transformer 由 20 层因果编码器加 20 层解码器构成,解码器的全局 KV 缓存从编码器末层隐状态投影而来,因此预填充阶段每个 token 只激活 8B 参数、解码阶段激活 16B。作为对照,同一份模型卡的基座评测表列出:V4-Flash-Base 主干 284B / 激活 13B,V4-Pro-Base 主干 1.6 万亿(1.6T)/ 激活 49B,V4.1-Flash-Base 主干 552B / 激活 8B 与 16B。这张表是理解两者差距最快的一处官方口径。
关于「V4.1 里更贵的那一档」,官方目前只承认它存在、没给任何细节。V4.1 Flash 发布公告在说明路由安排时写的是「北京时间 2026 年 9 月 14 日 12:00 之后,至未来 V4.1 Pro 上线之前,用户访问 deepseek-v4-pro 的请求将全部路由到 V4.1 Flash」,英文版对应句为 This will continue until V4.1-Pro launches.——这是官方侧对 V4.1 Pro 的唯一表述。截至目前,它没有发布日期、没有模型卡、没有可调用的 API 端点。
两个API模型名分别对应哪个版本
开发者最容易踩坑的地方在这里:现役的模型名只有 2 个,但历史上出现过的名字有 4 个以上,其中两个旧名现在指向的已经是新模型。官方定价页的脚注原文是:「旧模型名 deepseek-v4-flash、deepseek-v4-flash-vision-exp 仍可调用,但对应模型已下线,请求将由 DeepSeek-V4.1-Flash 模型提供服务,并按 Flash 价格计费。」
| | | |
|---|
| | | |
| | | |
| 原 DeepSeek-V4-Flash-0731,已下线 | | |
deepseek-v4-flash-vision-exp | | | |
deepseek-chat / deepseek-reasoner | | | |
好消息是切换成本很低:官方定价页写明两个现役模型共用同一组 Base URL——OpenAI 格式是 https://api.deepseek.com,Anthropic 格式是 https://api.deepseek.com/anthropic。这意味着换模型只需改 model 参数,地址与 SDK 都不用动,这也是官方公告里「API 调用方式不变」的含义。
10项规格逐项对照
把官方定价页「模型细节」表的两个现役列与两份官方模型卡合并,可以逐项拉平出下面 10 项。核对时间 2026 年 9 月 15 日:
| deepseek-flash(V4.1 Flash) | deepseek-v4-pro(V4 Pro 0813) |
|---|
| | |
| | |
| Causal Encoder-Decoder(CED),40 层=20 层因果编码器+20 层解码器 | 沿用 V4-Pro 预览版结构,外挂 DSpark 投机解码模块 |
| | |
| | |
| | |
| | |
| | |
| | |
| | |
同样值得注意的是哪些项完全一致,因为「一致项」比「差异项」更能说明这次换代的定位。官方定价页的功能行显示:Json Output、Tool Calls、Responses API、Anthropic API、对话前缀续写(Beta)五项两个模型都「支持」;FIM 补全(Beta)双方都「仅非思考模式支持」;思考模式双方都是「支持非思考与思考模式(默认)」;上下文与最大输出也都是 1M 与 384K。逐行读完会发现,两个模型之间真正不同的功能只有「图像理解」一项。
V4 Pro还会下线吗
这是本篇最需要交代时间线的一段,因为它在一周内被官方改写了一次。2026 年 9 月 10 日的官方发布公告原文写的是:「同时,经多方测试,V4.1 Flash 在性能、费用、速度、总用时等各项指标上已全面超越 V4 Pro,因此我们计划有序下线 V4 Pro 模型。北京时间 2026 年 9 月 14 日 12:00 之后,至未来 V4.1 Pro 上线之前,用户访问 deepseek-v4-pro 的请求将全部路由到 V4.1 Flash,并按 V4.1 Flash 单价计费。」
但在 9 月 14 日当天,官方定价页脚注与官方更新日志都已换成另一句话:「为响应广大用户的需求,我们决定在 2026 年 9 月 14 日之后继续提供 DeepSeek V4 Pro 的 API 调用服务,计费方式保持不变;如有变动,我们将另行通知。感谢您的理解与支持!」英文版定价页表述一致(we have decided to continue providing API services for DeepSeek V4 Pro after September 14, 2026, with the billing method remaining unchanged)。中英文两版同时改口,可以确认是官方调整了计划,而不是缓存快照没更新。
实测状态也支持这一判断:今日打开官方定价页,deepseek-v4-pro 一列的「模型版本」仍写着 DeepSeek-V4-Pro-0813、单价仍是 V4 Pro 的价目、并发仍是 500——也就是说请求并没有被路由到 Flash,V4 Pro 仍在按原价独立提供。官方给的下一个节点是「V4.1 Pro 上线」,但没有日期。
| | |
|---|
| V4 预览版发布,API 上线 deepseek-v4-pro 与 deepseek-v4-flash;公告写明「1M(一百万)上下文将是 DeepSeek 所有官方服务的标配」 | |
| V4-Flash 正式版上线公测;公告特别注明「本次仅升级了 DeepSeek-V4-Flash 的 API 接口,DeepSeek-V4-Pro API 及 APP/WEB 端模型未做更改」 | |
| V4-Pro 正式版在 APP、网页端与 API 同步上线,API 模型名不变;公告写明「用户可以通过 APP 或网页端选择『专家模式』使用全新的 V4 Pro 正式版模型」 | |
| V4 全系列启用峰谷定价,闲时价格为高峰时段价格的一半 | |
| V4.1-Flash 发布并上线 API(模型名改为 deepseek-flash),Flash 系列同步降价;公告同时宣布将有序下线 V4 Pro,9 月 14 日 12:00 起把 v4-pro 请求全部路由到 V4.1 Flash | |
| 官方 App 2.5.1 更新,更新说明原文为「新模型上线,快速、专家、识图模式合并升级」 | |
| 官方改口:继续提供 V4 Pro 的 API 调用服务,计费方式保持不变,如有变动另行通知 | |
V4.1与V4 Pro价格差多少倍
官方定价页的中国区价目(人民币,每百万 tokens),两个模型的三档单价与倍差如下:
高峰时段由官方明确为北京时间周一至周五 9:00-12:00 与 14:00-18:00,其余时间为空闲时段,空闲价正好是高峰价的一半。这一规则对两个模型同时生效,所以高峰档的倍差与空闲档完全相同,把任务挪到空闲时段并不能缩小两者的相对差距。
把官方英文定价页的美元价目代人同一算法,会看到一个不常被注意的细节:Flash 三档美元价为 0.003 / 0.15 / 0.6,V4 Pro 三档为 0.022 / 0.66 / 1.98(均为空闲)。用同档位的人民币价除以美元价——Flash 是 0.02÷0.003、1÷0.15、4÷0.6,三档都约等于 6.67;V4 Pro 是 0.15÷0.022、4.5÷0.66、13.5÷1.98,三档都约等于 6.82。两个模型各自内部换算率一致,但彼此并不相同,说明美元档不是用同一个汇率从人民币档换算出来的。因此「7.5 倍」是人民币价目下的读数;换成美元价目,同一个缓存命中档位的倍差是 7.3 倍(0.022÷0.003)。
真正决定账单的还是缓存命中:V4.1 Flash 的缓存命中价(0.02 元)与未命中价(1 元)差 50 倍,V4 Pro 这两个数字只差 30 倍。也就是说在会反复复用同一段上下文的长会话、RAG 与 Agent 场景里,Flash 的相对优势比单价表显示的更大——这也是官方在发布公告里把「缓存命中的费用往往占比较高」单独写一段的原因。官方同时给出了压缩成果:相对上一代,V4.1 Flash 的 KV 缓存对 HBM 的需求降到四分之一、对 SSD 的需求降到八分之一,每 token 的全局 KV 缓存为 890 字节。
V4.1 Flash与V4 Pro跑分谁更强
这里需要把「公告的表述」与「官方自己的数据」分开看。公告的原话是「在性能、费用、速度、总用时等各项指标上已全面超越 V4 Pro」,但 V4.1-Flash 官方模型卡给出的对照表并不支持「全面」二字:把两张官方表的同类项目并排放,知识与推理类项目仍是 V4 Pro 更高。
| | | |
|---|
| | | |
| | | |
| | | |
| | | |
Terminal-Bench 2.1(Pass@1) | | | |
Terminal-Bench 3.0(Pass@1) | | | |
| | | |
| | | |
| | | |
| | | |
| | | |
Agent's Last Exam(Pass@1) | | | |
† 表示仅在 HLE 评测集的纯文本子集上测试。把上表读一遍,可以得出一个比「全面超越」更准确的结论:V4.1 Flash 的领先集中在 Agent、代码与工具使用类,V4 Pro 的优势留在知识储备与深度推理类(GPQA Diamond、HLE)。这个方向在官方基座评测表里同样成立——V4-Pro-Base 在 SimpleQA-Verified(55.2 对 42.3)、LongBench-V2(51.5 对 45.2)、C-Eval(93.1 对 92.1)、MGSM(84.4 对 80.2)上更高,而 V4.1-Flash-Base 在 MMLU-Pro(74.1 对 73.5)、HumanEval(79.4 对 76.8)、GSM8K(93.0 对 92.6)、BigCodeBench(60.6 对 59.2)上更高。官方在基座表的说明里专门写了一句「分差在 0.3 以内的视为持平」,按这个口径,上表里 MathArena Apex 的 0.3 分差属于持平。
另外两个必须交代的口径:一是这些成绩都在Max 思考档下取得,官方模型卡写明全部 instruct 结果使用最大档位 reasoning_effort=100,衡量的是潜力上限而非默认体验;二是 Code Agent 类项目用的是 DeepSeek Harness 的 Minimal 模式,官方在同一张表下注明「其他框架下结果可能略有不同」——这句话在官方数据里有实测支撑:同一份模型卡的跨框架对照表显示,DeepSWE v1.1 在 Claude Code、Codex、OpenCode、Pi、mini-SWE、DSH Minimal、DSH Standard、DSH PTC 八个框架下得分从 65.5 到 74.2,相差 8.7 个百分点。跨模型比较时,这个幅度足以覆盖两档模型之间的多数分差。 V4.1 Flash与V4 Pro的第三方实测数据
独立评测机构 Artificial Analysis 已把两个模型都跑了一遍,并且都取各自最高思考档。以下读数直接取自该机构模型页(核对时间 2026 年 9 月 15 日):
| | DeepSeek V4 Pro 0813(max) |
|---|
智能指数(AA Intelligence Index v4.3) | | |
| | |
| | |
| | |
| | |
| | |
| | |
这张表有三处值得单列。第一是互证:独立机构自己标注的参数量(552B/16B 与 1.6T/49B)和输入模态(文本与图像 / 仅文本),与 DeepSeek 官方模型卡、官方定价页完全对得上——厂商口径与独立口径在此处一致,这比任何单方数据都更可信。第二是幅度差异:第三方榜单上 V4.1 Flash 确实排在 V4 Pro 之前(40 对 36),方向与官方一致,但只差 4 分;把它放进整个榜单看,「超越 V4 Pro」成立,「国产第一」并不成立。
| | | |
|---|
Claude Fable 5.1(max with fallback) | | | |
| | | |
| | | |
| | | |
| | | |
DeepSeek V4 Pro 0813(max) | | | |
第三处是「贵」与「便宜」在第三方口径下被分成了两个指标:V4.1 Flash 单任务成本 0.27 美元、V4 Pro 0.67 美元,差约 2.5 倍,比单价上的 3.4~7.5 倍要小——原因就在同一个表格的另一列:跑完整套 Index,V4.1 Flash 输出了 2.5 亿 tokens,比 V4 Pro 的 1.6 亿多约 56%,评测机构把它的「冗长程度」单独列为一个指标并给出「非常啰嗦」的评语。低价被自己的啰嗦吃掉了一部分,这是选型时最容易被忽略的一项。
引用这类第三方数字时还有两个口径必须带上:一是智能指数的版本号,AA 当前的 v4.3 由 10 项评测加权构成(含 AA-Briefcase、GDPval-AA v2、AutomationBench-AA、Terminal-Bench v4.0、SciCode、Humanity's Last Exam、GDP.pdf、CritPt、AA-Omniscience、AA-LCR v1.1),该机构页面会随评测集调整而更换版本号,不同版本的分数不能互相比较,引用时务必带上版本号;二是推理档位,上表两行都是 max 档,与默认档的读数并不相同。
普通用户在网页端和App里怎么选
结论是:普通用户没有这道选择题,也不需要选。官方 App 2.5.1 版本(2026 年 9 月 12 日发布)的更新说明原文只有三行,第一行就是「新模型上线,快速、专家、识图模式合并升级」——原来在网页端与 App 上对应 V4 Pro 的「专家模式」,在 C 端已不再作为独立模式存在,与「快速模式」「识图模式」一起合并为统一入口。
把前后两条官方表述连起来看会更清楚:2026 年 8 月 13 日 V4-Pro 正式版上线的公告写的是「用户可以通过 APP 或网页端选择『专家模式』使用全新的 V4 Pro 正式版模型」;一个月后的 9 月 12 日,官方 App 的更新说明改成了模式合并。C 端的模型由服务端决定,用户侧只保留一个入口,这也是官方把 V4.1 Flash 定位为「原生多模态+自动判断任务复杂度」的必然结果。如果旧客户端上仍显示三模式切换界面,按官方更新说明升级到最新版本即可。
顺带确认另一件常被问的事:网页端同样免费。2026 年 4 月 24 日 V4 预览版发布公告写的是「即日起登录官网 chat.deepseek.com 或官方 App,即可与最新的 DeepSeek-V4 对话」,并写明 1M 上下文是所有官方服务的标配;付费只发生在 API 一侧,按上文的单价与峰谷规则计费。
选用V4.1 Flash与V4 Pro的注意事项
- 不要把 deepseek-v4-pro 当成永久主模型:官方只承诺「如有变动,我们将另行通知」,并把「V4.1 Pro 上线」写成下一个节点。工程上建议用配置项或别名承接模型名,避免下次调整时要改代码重新部署。
- 先查代码里写的是哪个旧名:deepseek-v4-flash 与 deepseek-v4-flash-vision-exp 现在指向的是 V4.1-Flash,按 Flash 单价计费,早已不是原来的模型;沿用旧名的人其实已经在用新模型,只是账单和输出都变了。
- 需要读图就只能用 Flash:官方定价页的功能行明确写着图像理解 Flash「支持」、V4 Pro「不支持」。视觉类 Agent、截图理解、带图文档处理等场景,选 V4 Pro 会直接缺少该能力。
- 高峰期价格翻倍:北京时间周一至周五 9:00-12:00、14:00-18:00 为高峰时段,单价是空闲时段的两倍。批量任务、离线评测尽量排到空闲时段,这一点对两个模型同样适用。
- 并发按账号计,与 API Key 无关:官方写明一个请求从发出到响应完成记为一个并发,超限返回 429;Flash 并发 2500、V4 Pro 只有 500。用 V4 Pro 承接突发流量前要先算并发,官方也提供账号扩容申请工单,且「扩容并不增加额外的费用」。
- 「全面超越」要按评测项拆开看:官方公告的表述与官方模型卡的对照表并不完全一致,知识与推理类项目上 V4 Pro 仍领先。选型时用自己的真实任务跑一遍,比看公告或榜单都可靠。
- 跨模型比跑分要先对齐框架:官方成绩取自 DeepSeek Harness Minimal 模式配最大思考档,属潜力上限;同一模型在八个不同 Agent 框架下 DeepSWE v1.1 的读数从 65.5 到 74.2、相差 8.7 个百分点,这个幅度足以覆盖两档模型之间的多数分差。
DeepSeek V4.1与V4 Pro常见问题
Q:V4.1 和 V4 Pro 是同一代模型吗?
A:不是。V4 Pro 属 V4 系列的正式版旗舰(2026-08-13 上线,权重快照 0813),V4.1 Flash 属全新的 V4.1 结构系列(2026-09-10 上线)。体量差别也很大:前者主干 1.6T、激活 49B,后者主干 552B、预填充激活 8B、解码激活 16B。
Q:V4.1 Pro 什么时候发布?
A:截至 2026 年 9 月 15 日官方没有公布日期。官方只在 V4.1 Flash 发布公告里以「至未来 V4.1 Pro 上线之前」(英文版 until V4.1-Pro launches)的方式承认它存在,目前没有发布日期、没有模型卡、也没有可调用的 API 端点。
Q:便宜的 Flash 会不会比贵的 Pro 弱?
A:要按任务类型分。第三方 AA 智能指数上 Flash 为 40、V4 Pro 为 36,方向上是 Flash 更强;但官方自己的对照表显示 V4 Pro 在 GPQA Diamond(92.4 对 90.9)、HLE(42.7 对 36.8)等知识推理项目上仍领先,Flash 的优势集中在 Agent 与代码类。
Q:两个模型的 API 地址一样吗?
A:一样。官方定价页写明两者共用同一组 Base URL——OpenAI 格式 https://api.deepseek.com、Anthropic 格式 https://api.deepseek.com/anthropic,切换模型只需修改 model 参数,SDK 与地址都不用动。
Q:V4 Pro 现在还能调用吗?
A:能。官方在定价页脚注与更新日志里写明「决定在 2026 年 9 月 14 日之后继续提供 DeepSeek V4 Pro 的 API 调用服务,计费方式保持不变」。今日实测 deepseek-v4-pro 仍指向 DeepSeek-V4-Pro-0813、单价与并发均未变。
Q:为什么我在 App 里找不到「专家模式」了?
A:因为 C 端的模式入口已合并。官方 App 2.5.1(2026-09-12 发布)的更新说明原文是「新模型上线,快速、专家、识图模式合并升级」,原来对应 V4 Pro 的专家模式不再作为独立模式存在,模型由服务端自动分配。
Q:哪个模型支持图片输入?
A:只有 V4.1 Flash。官方定价页功能行写明图像理解 Flash「支持」、V4 Pro「不支持」;独立机构 Artificial Analysis 的模型页也分别标注为文本与图像输入、仅文本输入。需要读图、读带图 PDF 的场景只能用 Flash。
Q:代码里的旧模型名还能用吗?
A:能调通但模型已经换了。官方原文写 deepseek-v4-flash 与 deepseek-v4-flash-vision-exp「仍可调用,但对应模型已下线,请求将由 DeepSeek-V4.1-Flash 模型提供服务,并按 Flash 价格计费」;更早的 deepseek-chat 与 deepseek-reasoner 已于 2026-07-24 停止使用。
Q:两个模型都开源吗?许可有附加条件吗?
A:都开源,许可都是 MIT,没有附加的商用门槛或署名义务。官方 V4.1 Flash 发布页给出了权重仓库与《DeepSeek_V41_Tech_Report》技术报告链接;官方模型卡末尾写明「This repository and the model weights are licensed under the MIT License」。注意本地部署的实际门槛在显存与 SSD 侧,官方公布的每 token 全局 KV 缓存为 890 字节,对 SSD 的需求是上一代的八分之一。
 AI 速览