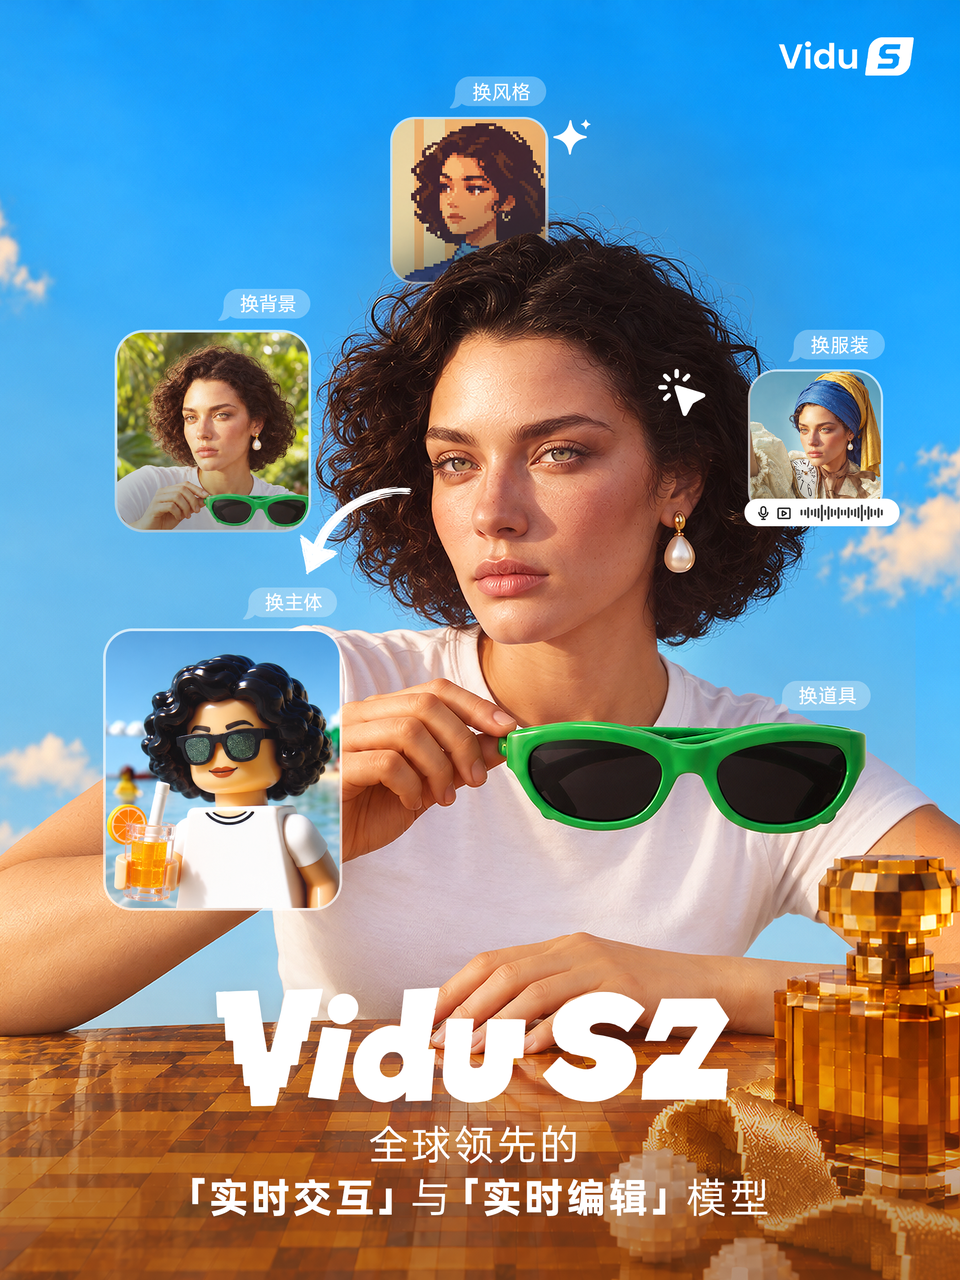
9 月 15 日,生数科技正式发布 Vidu S2 实时视频生成模型,距离上一代 Vidu S1 仅间隔 69 天。本次更新一次性推出实时数字人互动、实时视频编辑、实时空间视频三大核心能力,支持边播边换装、换角色、换背景、换风格,且发布当天全量开放,成为 AI 视频赛道从 “离线生成” 向 “实时交互” 演进的关键节点。
一、核心升级:三大能力覆盖互动、编辑与空间体验
Vidu S2 包含两大细分模型,同步拓展了空间视频新场景,形成三维能力矩阵。
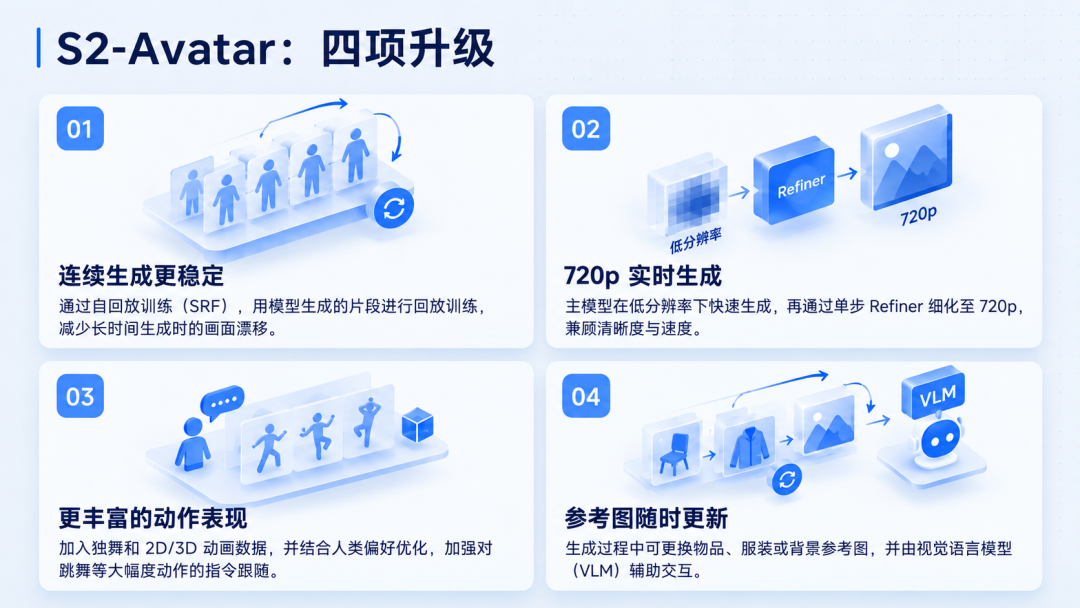
第一是S2-Avatar 实时数字人:分辨率从上一代 540p 提升至 720p,面部与服装细节更丰富;突破了前代以聊天为主的限制,可执行跳舞、转身、跺脚等大幅度肢体动作;支持互动中途输入参考图,让数字人即时更换服装、拿起指定物品、切换场景。
第二是S2-Editing 实时视频编辑:堪称 “视频版修图工具”,支持对正在播放的视频进行四类实时修改:人物换装、更换背景、替换主体角色、转换整体风格,全程保持动作连贯、透视一致、光影自然。
第三是实时空间视频:基于双目立体视觉原理,可将生成或编辑的视频实时转换为左右眼立体画面,适配 VR 头显;还能将头显摄像头捕捉的真实物理世界作为创作画布,让 AI 角色 “走出屏幕”,目前团队正持续优化分辨率与延迟,未来将拓展全景空间视频。
二、实测表现:动作与画面一致性突破,边播边改流畅落地
实测验证了模型的实时性与完成度。
数字人场景中,S1 无法完成的连续舞蹈、转圈等复杂动作,S2 可精准跟随指令执行,动作衔接自然;中途传入参考图后,服装、物品能自然融入当前画面,不会出现突兀的跳变。 实时编辑场景中,人物换装的服装褶皱、运动形变、遮挡关系高度真实,比如大衣袖口自然遮挡首饰的细节还原到位;更换背景、替换角色时,透视比例、光影环境、前后景遮挡均符合真实逻辑;风格迁移全程保持画面一致性,无明显割裂感。
目前仍存在少量瑕疵,比如色块服装偶有涂抹感、佩戴帽子时头发存在轻微穿模。 整体来看,该能力直接拓展了直播、短视频、虚拟主播的玩法边界,观众弹幕提出的换装、换景需求,可在播放过程中即时响应。
三、技术底层:多维度优化实现 “边播边改”
实时视频生成的核心挑战,是生成速度必须跑赢播放速度,同时保证画面质量与指令遵循度。Vidu S2 通过多套技术方案实现了体验突破。
架构上采用Backbone-Refiner 两阶段架构:Backbone 先在低分辨率下生成主体结构、动作与语义,Refiner 并行完成细节精修,通过异步流水线实现 720P 输出不掉帧。针对 “中途改内容” 的需求,通过时间戳对齐的位置编码,让参考图精准匹配到对应时间点,实现生成条件的平滑过渡。
交互层面引入VLM Agent,持续解析画面状态、跟踪指令进度,再规划后续生成,避免指令冲突与画面脱节。
训练层面采用Self-Replay Forcing机制,让模型在连续生成后复盘修正偏差,解决流式生成的误差累积问题;同时通过双向 DPO、流式 Streaming NFT 强化学习,持续优化画质、动作自然度与指令遵循度。
四、行业趋势:AI 视频从 “生成内容” 走向 “实时交互”
从 Vidu S1 首次实现 “照片生成可实时互动的数字人”,到 S2 拓展实时编辑与空间视频,AI 视频正在经历范式升级:过去是 “离线生成、一次性交付”,现在是 “实时生成、边播边改、双向交互”。 这一演进也打开了更多落地场景:直播间可实时响应观众需求调整内容,虚拟主播可承接更多临场互动,创意内容可快速迭代修改,VR/AR 场景可实现沉浸式的空间互动。
当 AI 视频不再只是生成一段内容,而是成为可交互、可编辑、可拓展的实时媒介,人与 AI 的视觉交互也将走向更自然、更立体的新阶段。
 AI 速览