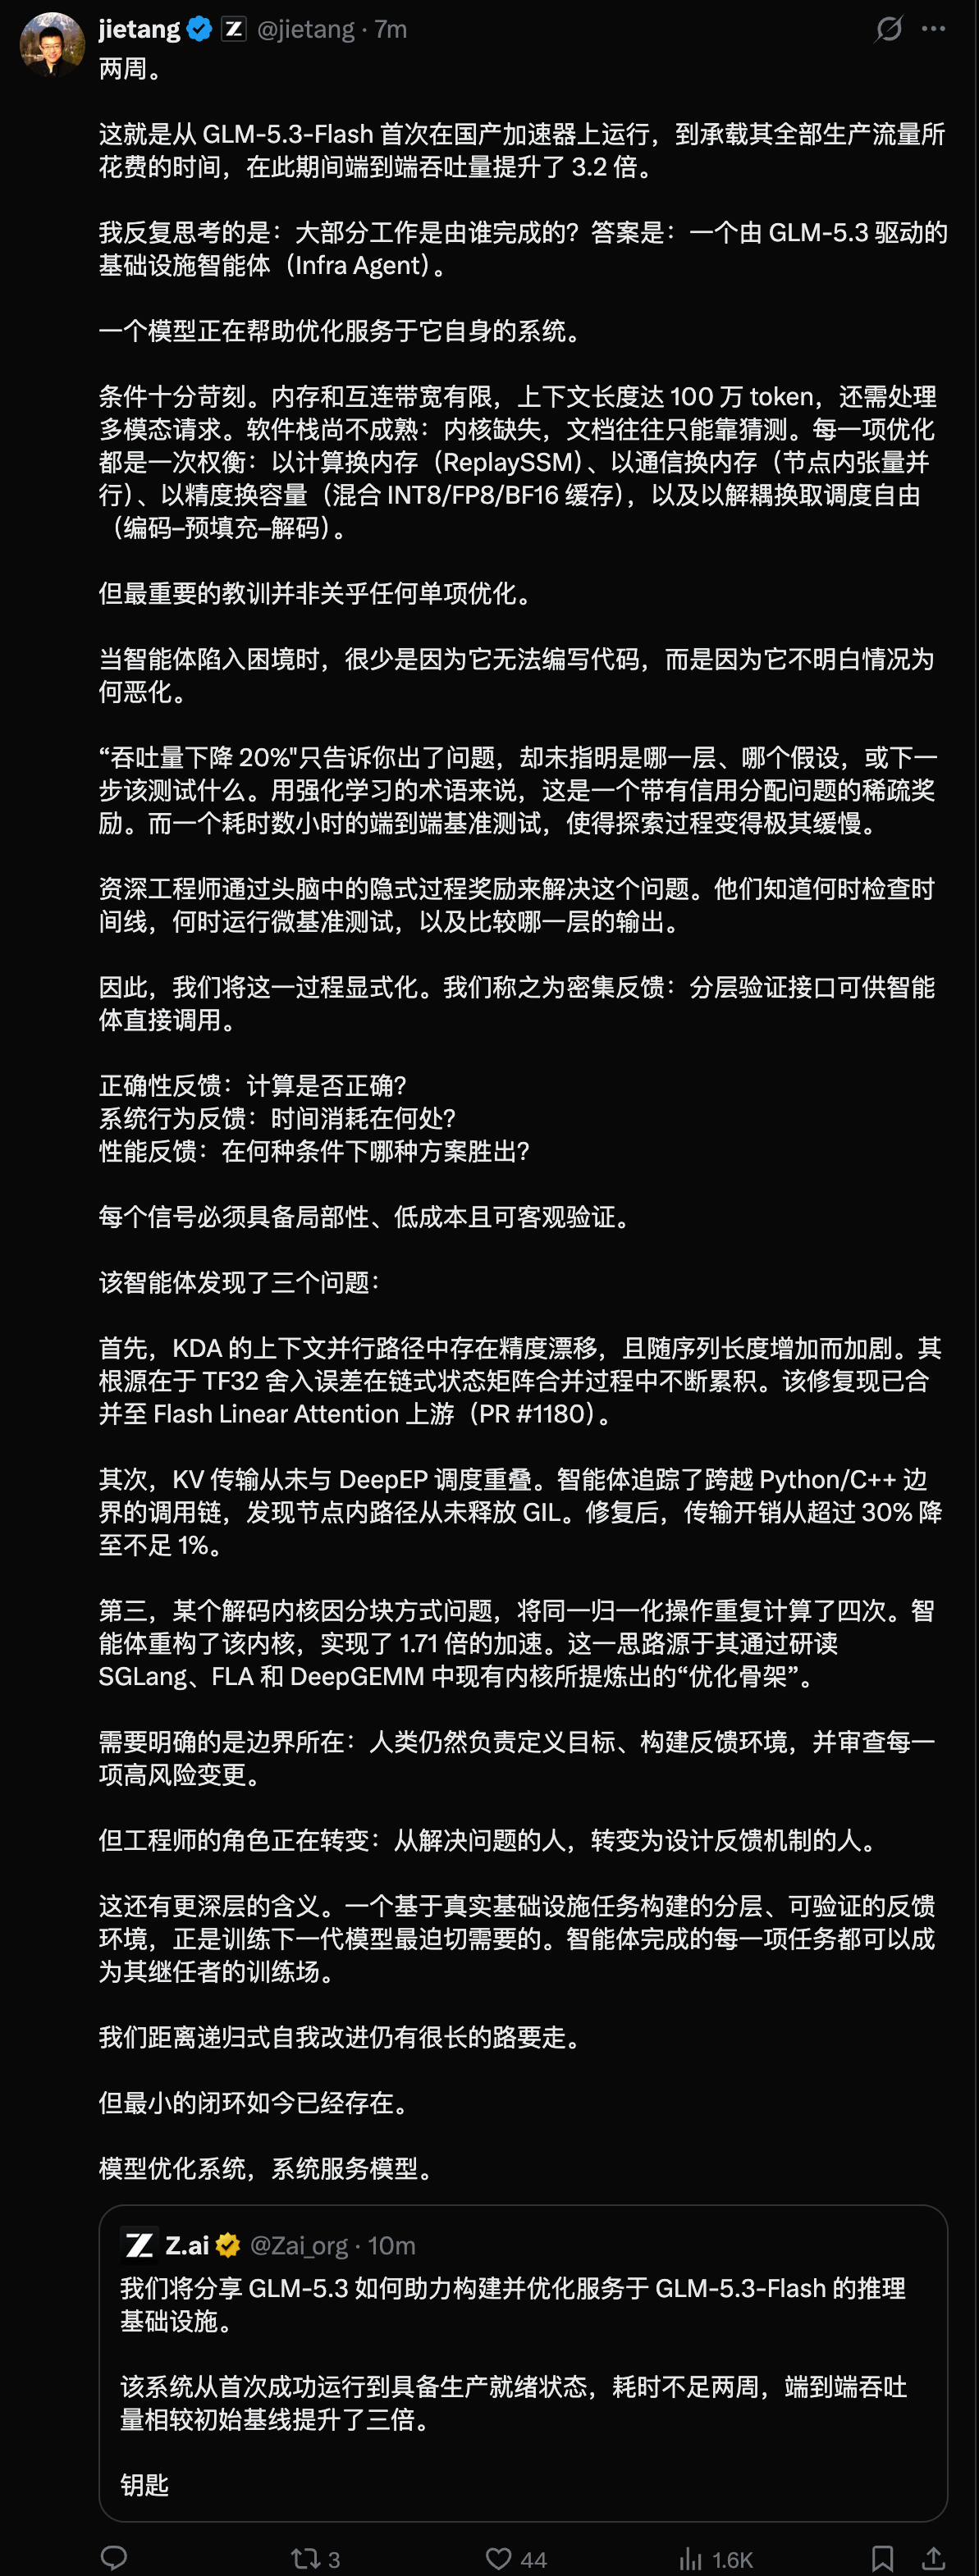
9月17日,智谱发布一篇技术文章,披露 GLM-5.3-Flash 的全部线上推理服务跑在一套自建系统上,规模超过 10 万张国产 AI 加速器。文章写道,这套系统的搭建过程"不是一群基础设施工程师单独完成的",大量工作由一个基于 GLM-5.3 的"基础设施智能体"(Infra Agent)承担,人负责定目标、定边界,并审核关键改动。
原文用一句话给这件事定了位:"我们的继任者,就是我们自己造出来的 AI 系统。"文章把集群规模、性能倍数与芯片部署列为智谱自己的数据,芯片厂商的名字没有出现,六天用量与第三方口径不一致。
先说清"推理"是什么
用户每次向 AI 提问,模型要当场算一遍答案,这个过程叫推理。训练像上学,推理像上班干活。这篇文章讲的是智谱给模型盖的"工位":工位搭得好,回答快、便宜;搭得差,每一次调用要多花钱。
GLM-5.3-Flash 的工位有三个约束:支持 100 万 token 的上下文,处理文本、图像、视频与 PDF 请求,跑在国产加速器上。智谱说,难点在于国产加速器的单卡显存容量与带宽相对有限,配套生态不成熟、内核支持不完整,不少本该有文档的地方要靠猜。
10 万张国产芯片,两周上线
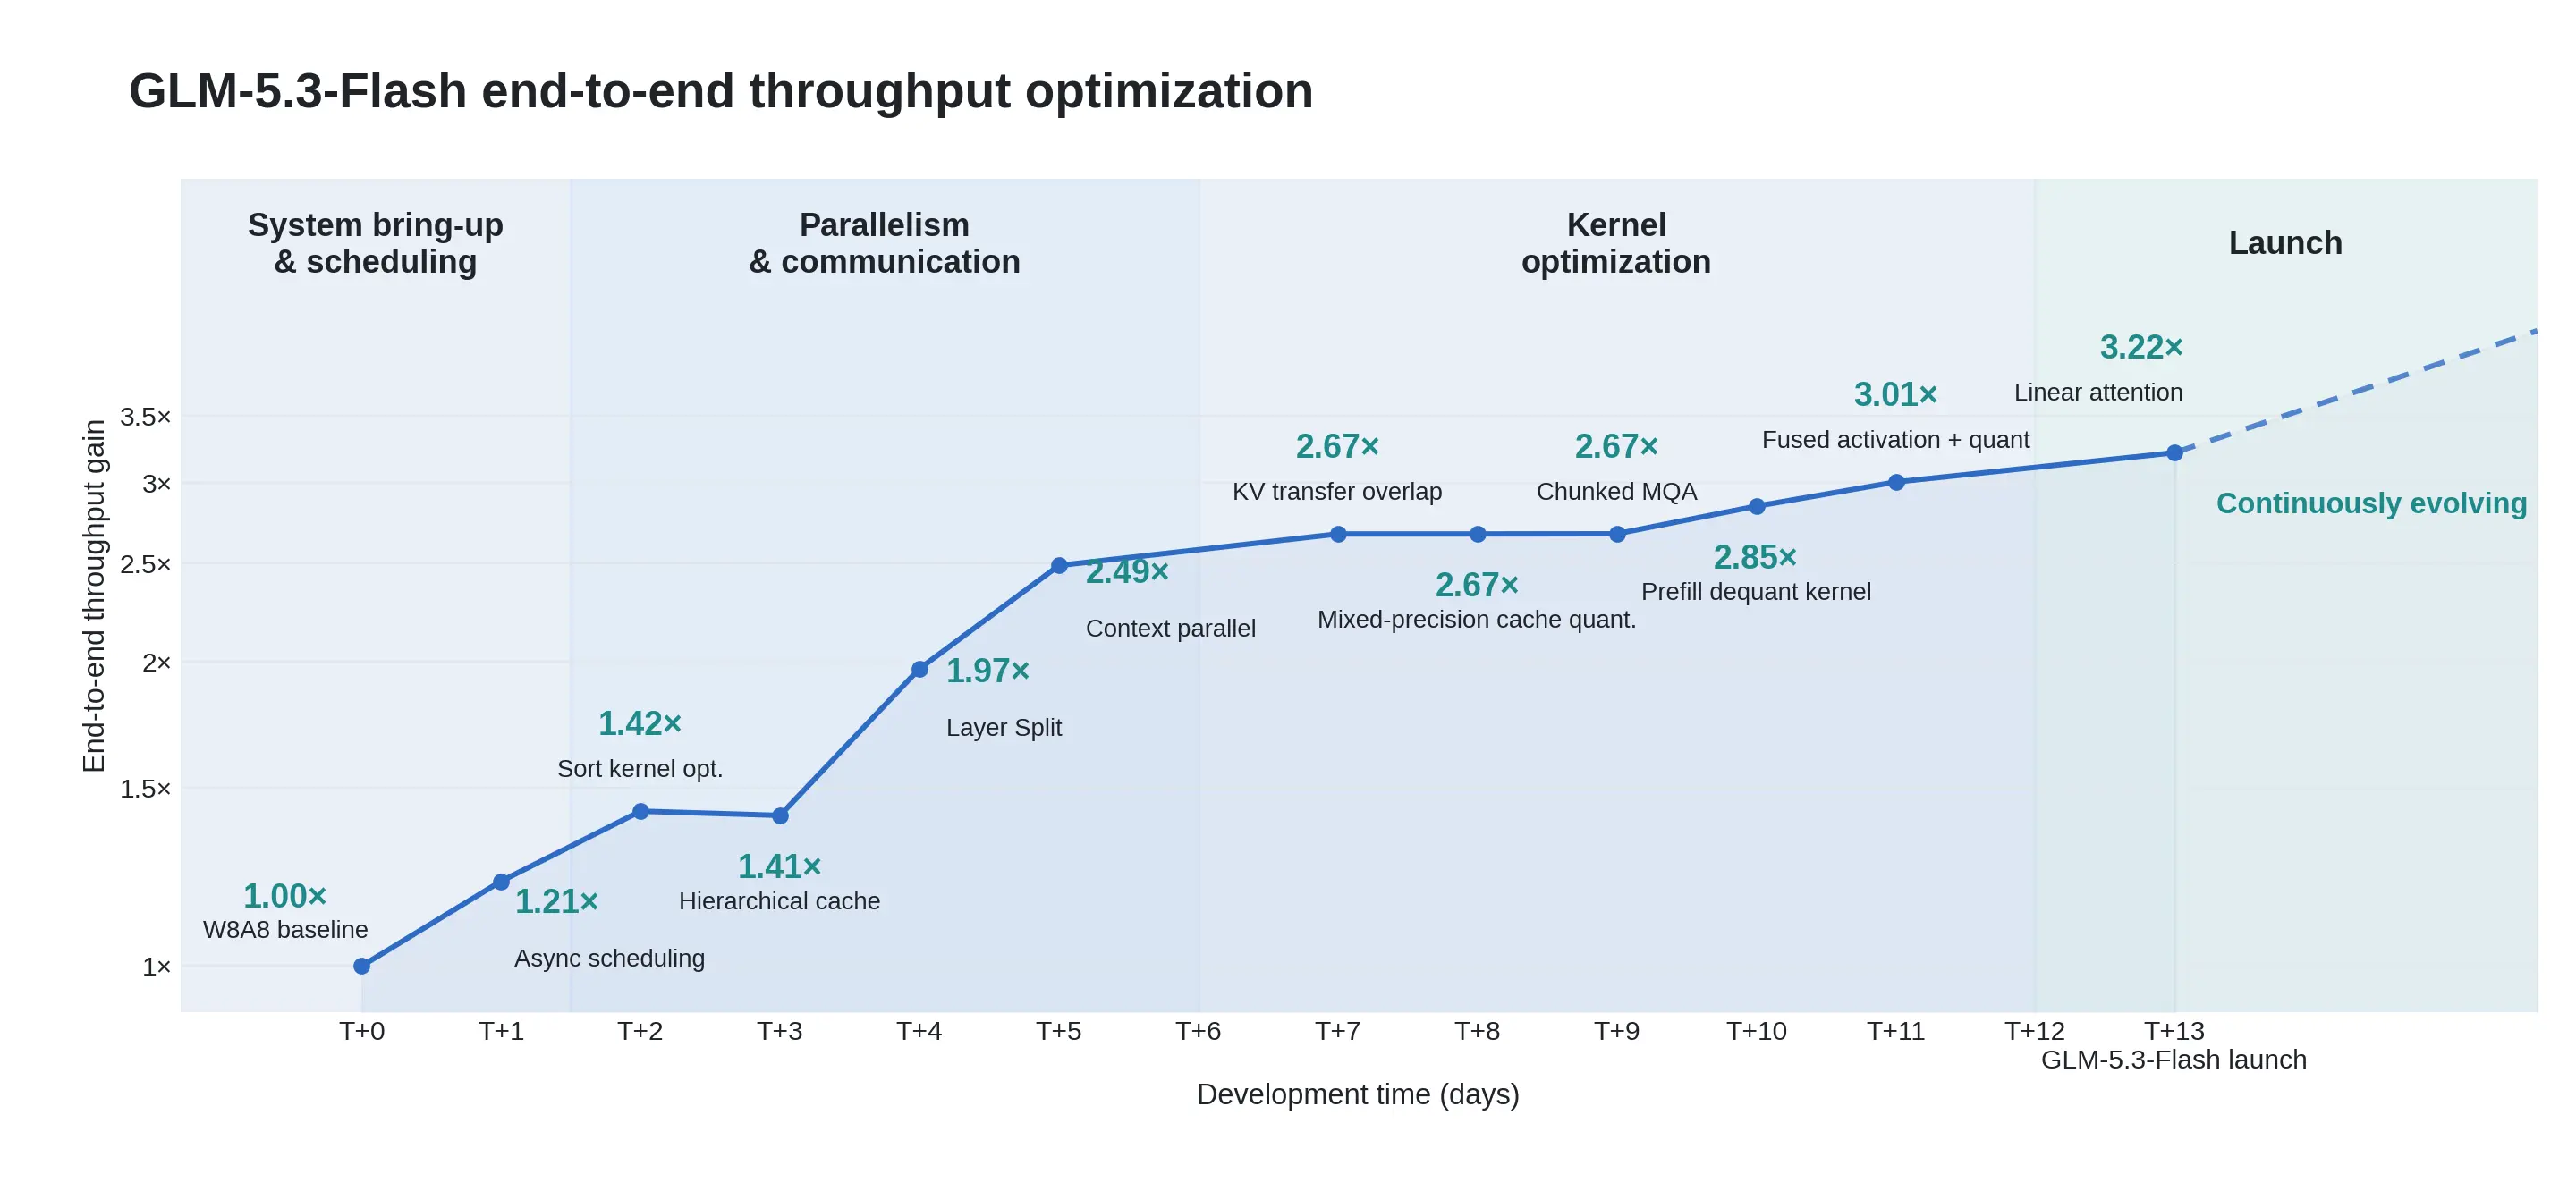
智谱说,此前没有人以这个规模部署过国产加速器。文章给出的落点是工期:从模型适配到生产就绪,用时不到两周;端到端服务性能相对最初基线提升 3 倍左右;硬件利用效率与每 token 成本"达到主流 NVIDIA GPU 的可比水平"。
这些数字来自智谱自己的文章,没有第三方复核。芯片厂商的名字没有出现。美国财经媒体 CNBC 报道称智谱未公开所用芯片厂商;市场调研机构 Counterpoint 的分析师 Ivan Lam 推测,智谱采用了华为昇腾系列芯片。
AI 参与的那部分,具体做了什么
智谱把方法叫"密反馈",强调的重点是反馈能否指到具体位置。传统做法是整套服务跑一轮压测,拿到一句"吞吐没达标";智谱把正确性测试、运行日志、执行轨迹、运行时事件与微基准接进智能体的工作流,让它按当前的假设挑一种验证方法,无需为每次改动跑一遍完整部署与压测。
文章给了三个例子,指向同一类问题:结果变差,原因不明。
第一个是数值精度。智能体在 KDA 内核的上下文并行路径上比对分区与未分区的输出,发现误差。追下去,原因是矩阵乘默认按 TF32 精度计算,该内核在输入为 FP32 时按 TF32 计算,长上下文下误差累积。修法是显式改用 tf32x3。
第二个是抢锁。压测发现"预填充加 KV 传输"相对"单独预填充"慢了 20% 以上,而验收标准是不超过 5%。智能体看时间线,发现传输任务的提交被拖住,根因是 DeepEP 的节点内两个调用没有释放 Python 的全局解释器锁,同进程里负责传输的线程拿不到锁。修复后,两者差距落到 1% 以内。
第三个是重复计算。一个内核原来沿 V 维度切分,同一组归一化与门控计算被重复做了四次。智能体把切分合并进一个线程块,中间结果留在寄存器里,改用一次 warp 级归约,相对前一版提速 1.71 倍。
这三件事由工程师把关。文章写明工程师承担三项职责:定优化目标与系统边界、建设智能体自己可用的反馈环境、审核涉及数值语义、异步并发与生产风险的关键改动。文章把分工收成一句对句:模型优化系统,系统运行模型。
哪些能查,哪些是公司自己说的
可查的部分有四类。
权重是公开的。Hugging Face 上的 zai-org/GLM-5.3-Flash 采用 MIT 协议,创建于 8月25日,参数量 3213 亿,下载量超过 224 万。
文中提到的那处精度修复能对上。上游仓库 flash-linear-attention 的 1180 号提交,标题是 [CP] use tf32x3 affine chain in kcp,合并时间是 8月27日。文章的主张限于"修复已合入上游",没有主张这个提交由智能体完成。
匿名期的表现在平台侧有说法。模型以 Ox-Alpha 的名义在 OpenCode 与 OpenRouter 上测试,OpenRouter 官方账号称它是该平台历史上用量居首的模型,六天处理超过 20 万亿 token。 揭晓后的现状可以查。OpenCode 的数据页显示,GLM-5.3-Flash 上周用量排在 OpenCode 第 5,token 份额 8.7%,累计 token 量 56 万亿,独立用户 90.7 万,会话数 1538 万。 对不上的地方在这里。智谱文章写的是"六天处理超过 62 万亿 token"。这个数字高于 OpenRouter 官方账号给出的 20 多万亿,与第三方统计里出现的 44 万亿、23.2 万亿不一致,口径与时间窗没有公开。文章给出的另一个说法是,它在一周内成为两个平台用量第一的模型,而两个平台现在的排名为 OpenCode 第 5、OpenRouter 30 天榜第 10。
参数与性能的口径在这里:3 倍左右的提升、"达到主流 NVIDIA GPU 的可比水平"、10 万张芯片的部署规模,属智谱单方数据。
事实比那个说法窄
文章把这件事放进"递归自我改进"的讨论,指系统设计并训练自己的下一代。文章自述没有到达这一步,并写明选目标、定边界、评估风险属于人的职责,人应当长期守住这条线。
发生的事比那个说法窄:一个模型参与搭建和调优了自己运行所需的那套工程。
 AI 速览