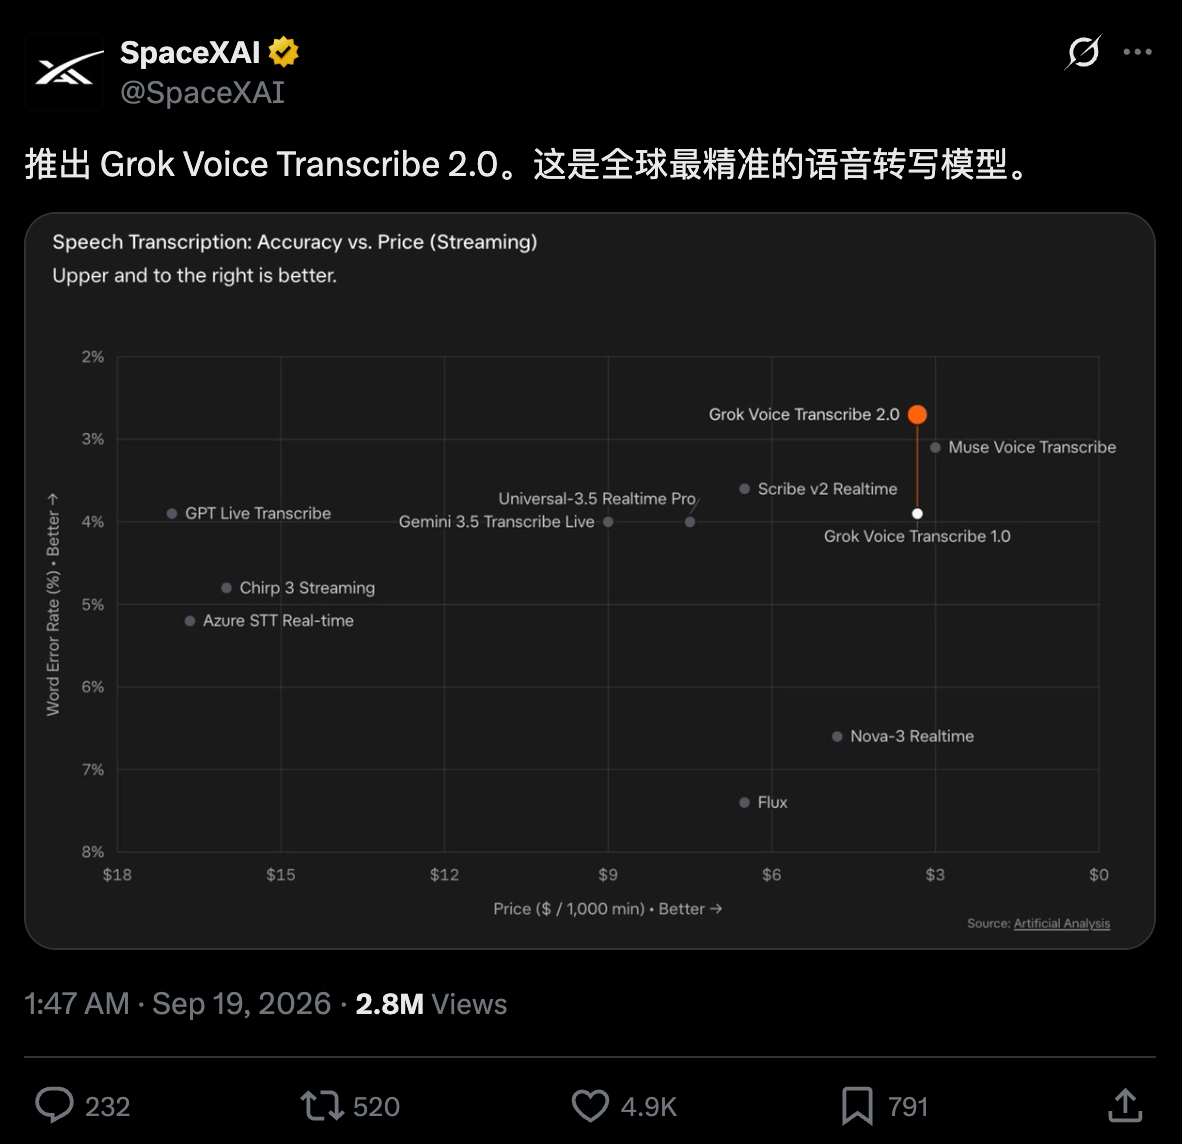
9月20日消息,SpaceXAI 发布语音转文本模型 Grok Voice Transcribe 2.0,价格与上一代持平。官方称其在第三方评测机构 Artificial Analysis 的流式榜上排名第一;截至9月20日,该榜收录 34 个模型,Grok Voice Transcribe 2.0 的最终转写词错误率(WER,越低越好)为 2.73%,居首。官方给出的安排是:默认模型切到 2.0,旧版 Grok Voice Transcribe 1.0 在未来数周进入弃用流程。 官方公布的数字与切换安排
官方介绍,该模型建立在 Grok Voice 的音频基础模型之上,训练数据取自真实环境中的嘈杂多语言音频,面向电话线路不稳、说话人重叠、地区口音和口述凭证这类场景。发布主体在 2026年7月由 xAI 更名为 SpaceXAI,官方页与文档沿用 x.ai 域名。
四组内部评测的数值为:客服电话的 8 kHz 音频,WER 从 10.6% 降到 7.1%;与 Grok 的对话音频,从 8.7% 降到 3.3%;电话号码、邮箱地址这类口述凭证,从 7.2% 降到 3.2%;19 种语言的短句命令,从 20.6% 降到 6.8%。这四组数据取自 SpaceXAI 的生产流量,属于官方自测。
调用方式上,批量转写走 REST 端点,实时转写走 WebSocket。配置项包括词级时间戳、说话人分离、8 声道以内的多声道转写、单次 100 个术语的关键词偏置、数字与币种的文本格式化、填充词移除,以及用于语音 agent 的智能话轮检测。官方称现有集成无需改代码即可获得精度提升。
价格与 1.0 相同:批量转写 0.1 美元/小时音频,流式转写 0.2 美元/小时,说话人分离、时间戳和关键词偏置包含在价格内。文档把 grok-voice-transcribe-2.0 列为省略模型参数时的默认值;留在旧版的团队可以在请求里 pin 住 grok-voice-transcribe-1.0。
「准确率第一」属于哪一套口径
Artificial Analysis 的流式榜以最终转写作为准确率的主列。Grok Voice Transcribe 2.0 为 2.73%,排在首位;Muse Voice Transcribe 为 3.06%,Cartesia Ink-2(semantic endpoints)为 3.36%,ElevenLabs Scribe v2 Realtime 为 3.59%,Gemini 3.5 Transcribe Live 为 4.00%。 这套指数由三个数据集合成,总量约 8 小时音频:AA-AgentTalk 是 Artificial Analysis 自有的语音 agent 场景保留集,VoxPopuli 取欧洲议会的英语片段,Earnings22 是含技术术语与重叠说话人的上市公司财报电话会议。权重为 AA-AgentTalk 一半,VoxPopuli 与 Earnings22 各四分之一。官方自测的多语言短句与电话音频不在这三项数据集之内。
非流式是另一套口径。同一站的非流式 AA-WER 榜上,Grok Voice Transcribe 2.0 为 2.29%,排在第五,前面四位是 Fun-Realtime-ASR-preview(1.73%)、StepAudio 3 ASR(1.75%)、MAI-Transcribe-2(2.04%)和 Scribe v2(2.18%)。
换代在流式榜上的结果是:1.0 的 WER 为 3.93%,排第 7;2.0 为 2.73%,排第 1,相对降幅为 31%。官方把「准确率为 1.0 的两倍」归在自家的真实场景评测之下,其自测四组数字的降幅在 33% 到 67% 之间。榜单口径与自测口径测的是不同音频集,给出的幅度也不一致,官方未给出倍率与降幅之间的换算说明。官方发布时给出的说法是 32 个流式模型,与截至9月20日的 34 个有出入。
流式价格压在对照之下,延迟落在后段
按同一站的标价,Grok Voice Transcribe 2.0 的流式价格为 3.33 美元/千分钟,与官方价目表的 0.2 美元/小时一致。OpenAI 的 GPT Live Transcribe 标注 17 美元/千分钟,为前者的 5.1 倍。ElevenLabs Scribe v2 Realtime 与 Deepgram Flux 的标价为 6.5 美元/千分钟。批量一侧,Grok Voice Transcribe 2.0 为 1.67 美元/千分钟。
延迟是另一项。Artificial Analysis 流式榜的「语音结束后到最终转写」一列,Grok Voice Transcribe 2.0 为 0.49 秒,在 34 个模型中排第 25;上一代 1.0 为 0.37 秒,排第 17。位次靠前的是 Deepgram Flux(0.02 秒)、Soniox v5 Real-Time(0.05 秒)和 Inworld STT 1 Realtime(0.07 秒)。
价差可以直接换算,延迟不能。跟随默认的集成在获得这项精度提升时,延迟一项随之后退。实时语音 agent 的选型判断要分两步:准确率看榜单,延迟看自家音频。
改善集中在哪一类音频,谁在用
官方自测的四组数字里,19 种语言的短句命令降幅居首,从 20.6% 到 6.8%;客服电话的 8 kHz 音频降幅居末,从 10.6% 到 7.1%。多语言与上下文少的短音频是这一代的改善重点。
接入案例来自 Atlassian。官方页称 Atlassian 的评估结论是该模型转写 Loom 视频的准确率高于原有方案;Atlassian 负责 Teamwork Collection 的高级副总裁 Sanchan Saxena 提到,录音转成文字后接入 Cursor,代码改动由后者完成。官方对 Grok Voice 的描述是每天支撑数万通客服电话、转写数百万小时视频旁白,并用于 Tesla 车内的 Grok 助手。
截至9月20日,公开数据支持三项:流式口径下准确率第一、单价与 1.0 相同、延迟排在第 25 位。多语言改善与 Loom 的对比来自 SpaceXAI 与 Atlassian 的表述,缺少第三方复现数据。弃用窗口在数周内,使用旧版的团队要在 pin 住旧 slug 与跟随默认之间做一次选择。
 AI 速览