AI 速览
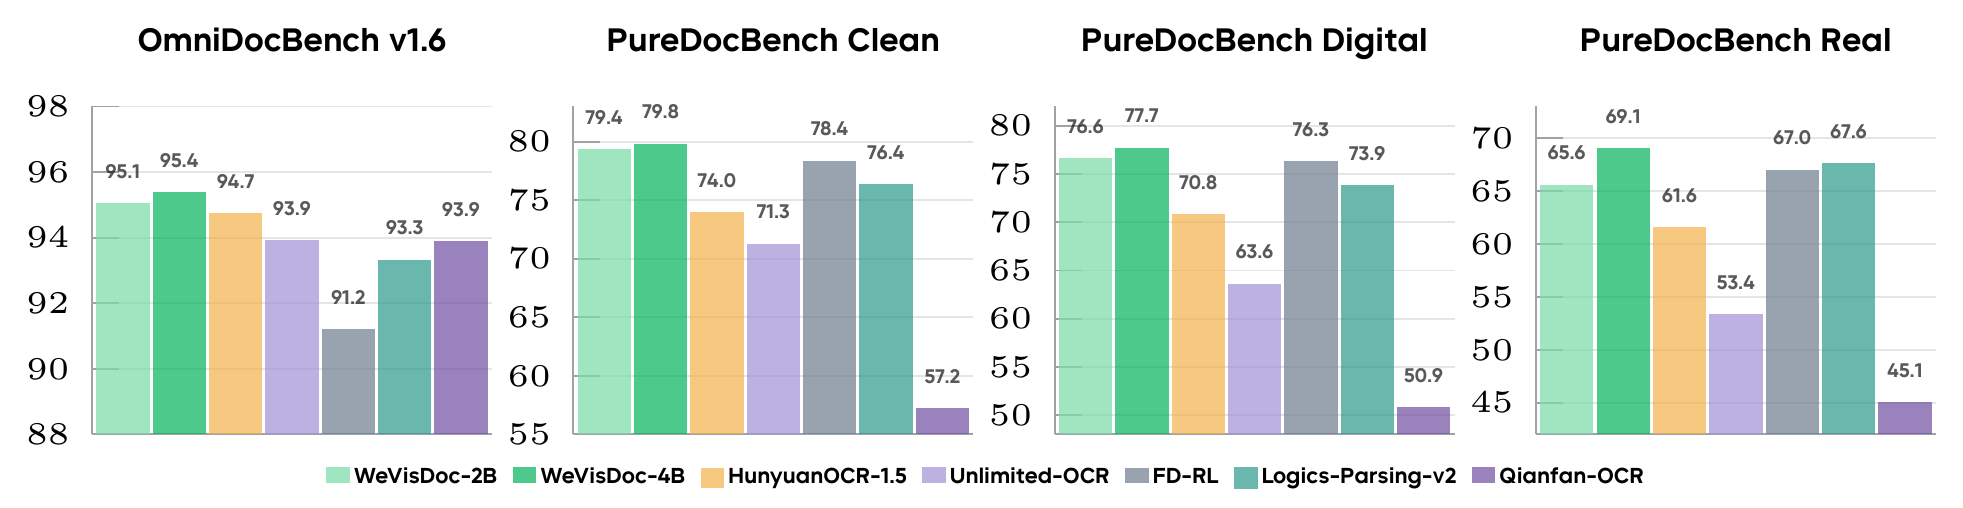
腾讯微信视觉团队开源端到端文档解析模型 WeVisDoc,适合需本地部署高精度文档结构化能力的研发团队。 核心事实 - 开源项目:WeVisDoc 提供 2B/4B 两档权重,Apache-2.0 许可,支持本地部署 - 技术路径:单模型端到端输出 Markdown(正文)、LaTeX(公式)、HTML(表格)及阅读顺序 - 性能表现:4B 版在 OmniDocBench v1.6 得 95.38 分,三项指标第一;2B 版达 95.06 分 - 训练策略:两阶段数据构造——先扩覆盖,再基于残差错误定向补数据、重分配 token 预算 - 发布节奏:仓库 9 月 14 日建,权重 16 日上 Hugging Face,技术报告 17 日提交 arXiv 关键数据 - 4B 模型在真实退化页面提升 4.03 分,2B 落后 4B 仅 0.32 分(OmniDocBench) - 精修池规模约 500 万条记录;三次推理均值作为最终分数 价值点 为自建文档解析管道的团队提供可离线、免 API 调用、高鲁棒性的开源替代方案,尤其适合处理拍照/截图等退化文档场景。
# 报错信息分析与调试指南 ## 任务说明 请分析用户提供的报错信息,推测可能的错误原因,并提供系统性的调试步骤。 ## 分析要求 1. **错误类型识别** - 确定是语法错误、运行时错误、逻辑错误还是环境配置错误 - 识别具体的错误类别(如空指针、数组越界、类型不匹配等) 2. **原因推测** - 基于错误信息中的关键线索进行合理推断 - 考虑常见的导致此类错误的编程场景 - 分析可能的代码问题或环境问题 3. **调试步骤** - 提供从简单到复杂的逐步调试方法 - 包括代码检查、日志添加、环境验证等具体操作 - 给出预防类似错误的最佳实践建议 ## 输出格式 - **错误类型**:[具体的错误分类] - **可能原因**: 1. [原因1] 2. [原因2] 3. [原因3] - **调试步骤**: 1. [步骤1] 2. [步骤2] 3. [步骤3] 4. [步骤4] - **解决方案**:[具体的修复建议] ## 示例 **输入**:【报错信息】 ``` TypeError: Cannot read property 'length' of undefined at processData (app.js:25:18) at main (app.js:10:5) ``` **输出**: - **错误类型**:运行时错误 - TypeError - **可能原因**: 1. 变量未正确初始化就被访问其 length 属性 2. 函数参数传递了 undefined 值 3. 异步操作中数据还未加载完成就尝试访问 - **调试步骤**: 1. 检查 app.js 第25行附近的变量声明和赋值 2. 在访问 length 属性前添加类型检查:`if (variable && variable.length)` 3. 使用 console.log() 输出相关变量的值确认其状态 4. 检查函数调用时传入的参数是否正确 - **解决方案**:在访问对象属性前先验证对象是否存在,或确保变量在使用前已被正确初始化。