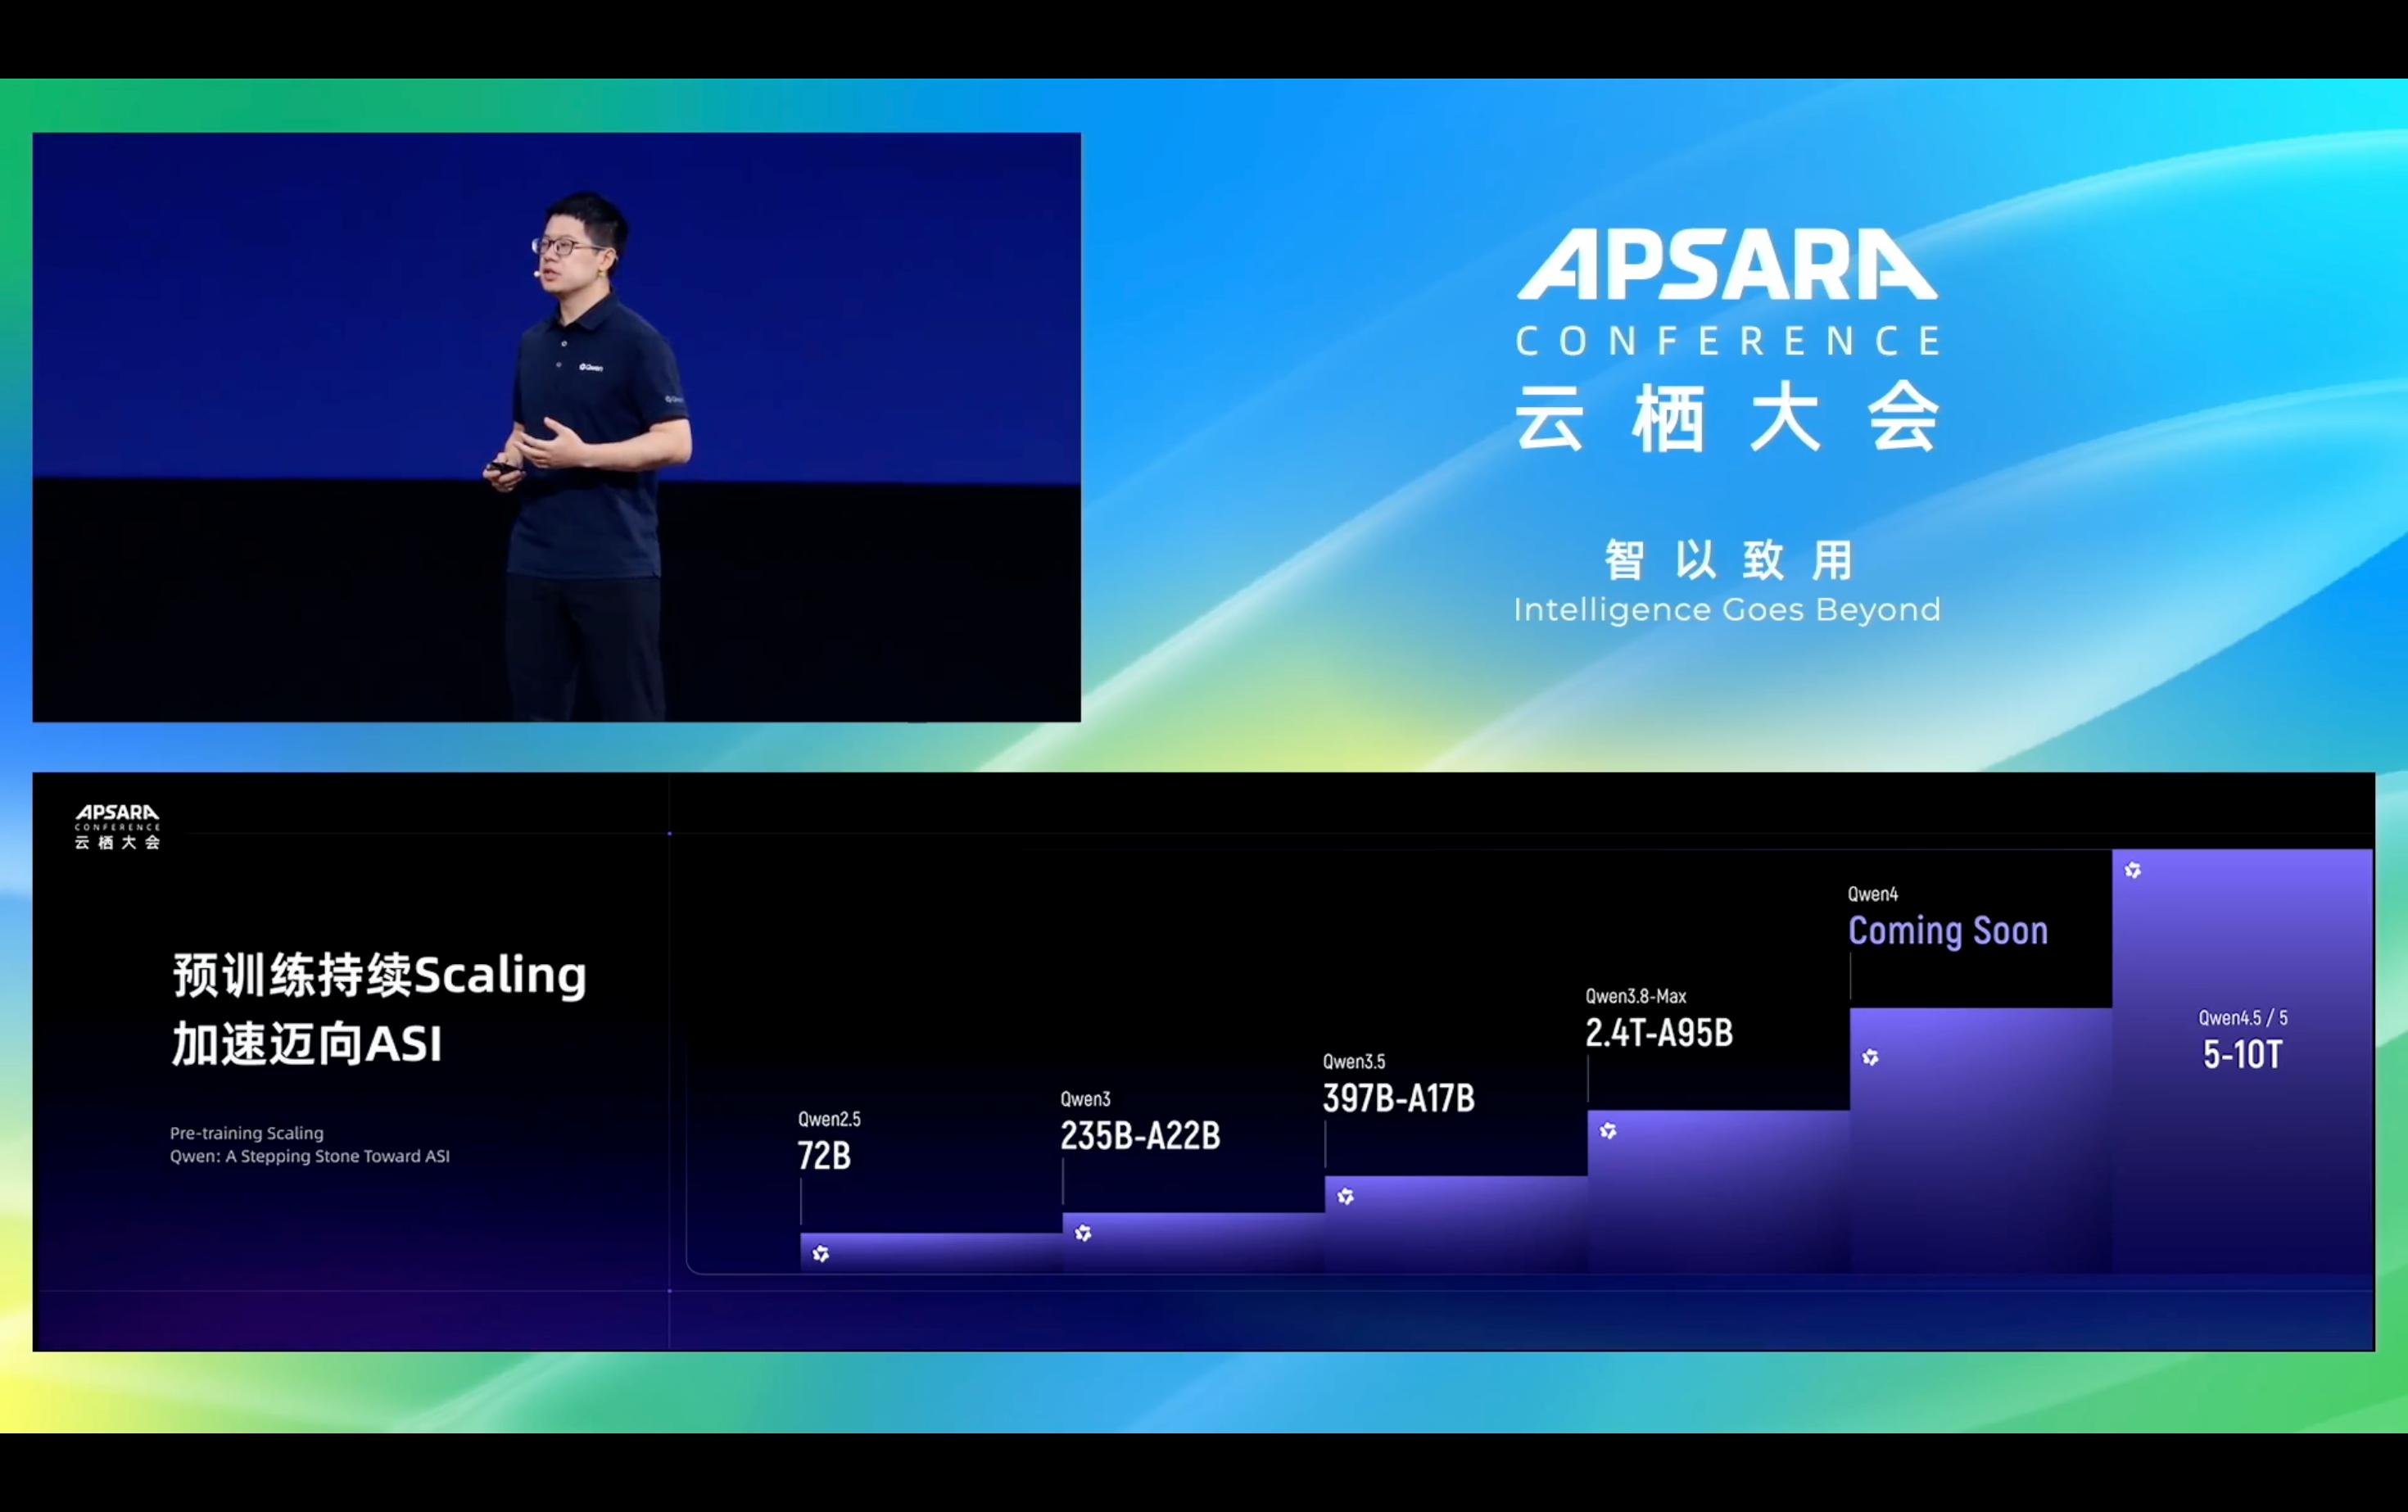
9月22日消息,2026 云栖大会主论坛上,阿里巴巴 ATH 事业群 Token Foundry、Qwen LLM 项目负责人刘大一恒在《Qwen:迈向真实世界智能体》演讲中公开 Qwen4 系列。按现场公布的方案,Qwen4 采用全新架构,已进入训练,开源侧优先安排 Qwen4-27B。
Qwen4 的架构与阵容
现场幻灯片把 Qwen4 标为 Coming Soon,给出的阵容延续 Qwen3.8 的分层方式。闭源侧是 Qwen4-Max 作为旗舰,Qwen4-Flash 与 Qwen4-Plus 覆盖不同性能与成本区间;开源侧先推 Qwen4-27B 这一稠密模型,方便开发者本地部署。
这一分层的依据来自上一代的产品结构。Qwen3.8-27B 是原生多模态稠密模型,采用 Apache 2.0 许可,原生上下文 262K Token,可扩展至 100 万 Token;官方称其能力接近参数量十倍于己的 MoE 模型 Qwen3.7-Plus,量化后能在笔记本上运行。旗舰 Qwen3.8-Max 为 2.4T 总参数、95B 激活参数,上下文同样支持 100 万 Token。
架构上,8月发布的 Qwen3.8-Flash-Next 已被官方定位为 Qwen4 架构的早期预览。这个模型的规模是 125B 总参数、51B N-gram embedding、6B 激活,在 GDN(门控 Delta 网络)与 QSA(量化稀疏注意力)混合注意力、Gated Residual、N-Gram 与协同设计缩放四项设计下,官方给出的训练成本降幅接近 90%。
自我迭代跑出了什么
Qwen3.8-Max 在一个月内跑完一轮自我迭代。按现场公布的数据,它在人类「零参与」的条件下自主搭建训练流程、构造训练数据、设计实验并定位缺陷,持续迭代超 1 个月,完成 33 轮有效迭代。
迭代后的版本在 Artificial Analysis 上的得分从 40 升至 45。阿里在会场称,该分数与 Claude、GPT 的最强模型同处第一阵营,也领先 GLM5.3、Kimi-K3 等国产模型。 同一套能力被用到推理与芯片设计上。在平头哥一款未公布型号的新款 GPU 上,Qwen3.8-Max 自主完成了下代架构 Qwen3.8-Flash 推理框架的适配优化,单实例推理吞吐量提升 96%。
芯片设计侧,按现场展示,模型仅依据一份真实的总线模块规范展开前端、验证、后端的全链路自迭代,运行超 60 小时、调用 EDA(电子设计自动化)工具超万次,最终完成面积减少 42% 的物理实现优化。
现场把这套机制称为递归式自我改进(RSI)。按展示的闭环,流程从内测消息出发,经过问题定位、模型与数据合成、验证数据回到下一轮,Qwen 训练正在朝这个方向演进。
参数路线与开源侧
参数规模上的规划更远。刘大一恒表示,预训练规模扩展(Scaling)是走向超级人工智能(ASI)的关键路径,Qwen4.5、Qwen5 计划扩展到 5 万亿至 10 万亿参数。以现场给出的爬坡节点看,Qwen2.5 为 72B、Qwen3 为 235B-A22B、Qwen3.5 为 397B-A17B、Qwen3.8-Max 为 2.4T-A95B,5 万亿至 10 万亿对应的是 Qwen4.5 之后的版本,不是 Qwen4 本身。
开源侧仍在加码。现场公布的数字是:阿里已开源 460 余个 Qwen 模型,累计下载突破 30 亿次,衍生模型超过 30 万个。官方称,Qwen3.8-27B 发布两天内进入 Hugging Face 最受欢迎模型前五,后续拿下该平台历史上最受欢迎的开源大模型。
 AI 速览